Основи ШІ
Що таке нейронні мережі?

 Додайте Unite.AI до бажаних джерел у Google
Штучна нейронна мережа — це параметризована математична модель, складена з шарів з’єднаних операцій. Під час навчання мережа налаштовує свої параметри так, щоб вхідні дані перетворювалися на корисні виходи. Нейронні мережі можуть апроксимувати складні нелінійні залежності та навчатися представленням безпосередньо з тексту, зображень, аудіо, часових рядів та інших даних.
Назва історично натхненна біологічними нейронами, проте сучасні мережі — це інженерні системи, а не реалістичні симуляції мозку. Терміни типу «нейрон» і «навчання» є зручними скороченнями і не слід плутати їх з доказами людської когніції.
Основні висновки
- Нейрон обчислює зважену суму, додає навчене зміщення та застосовує функцію активації.
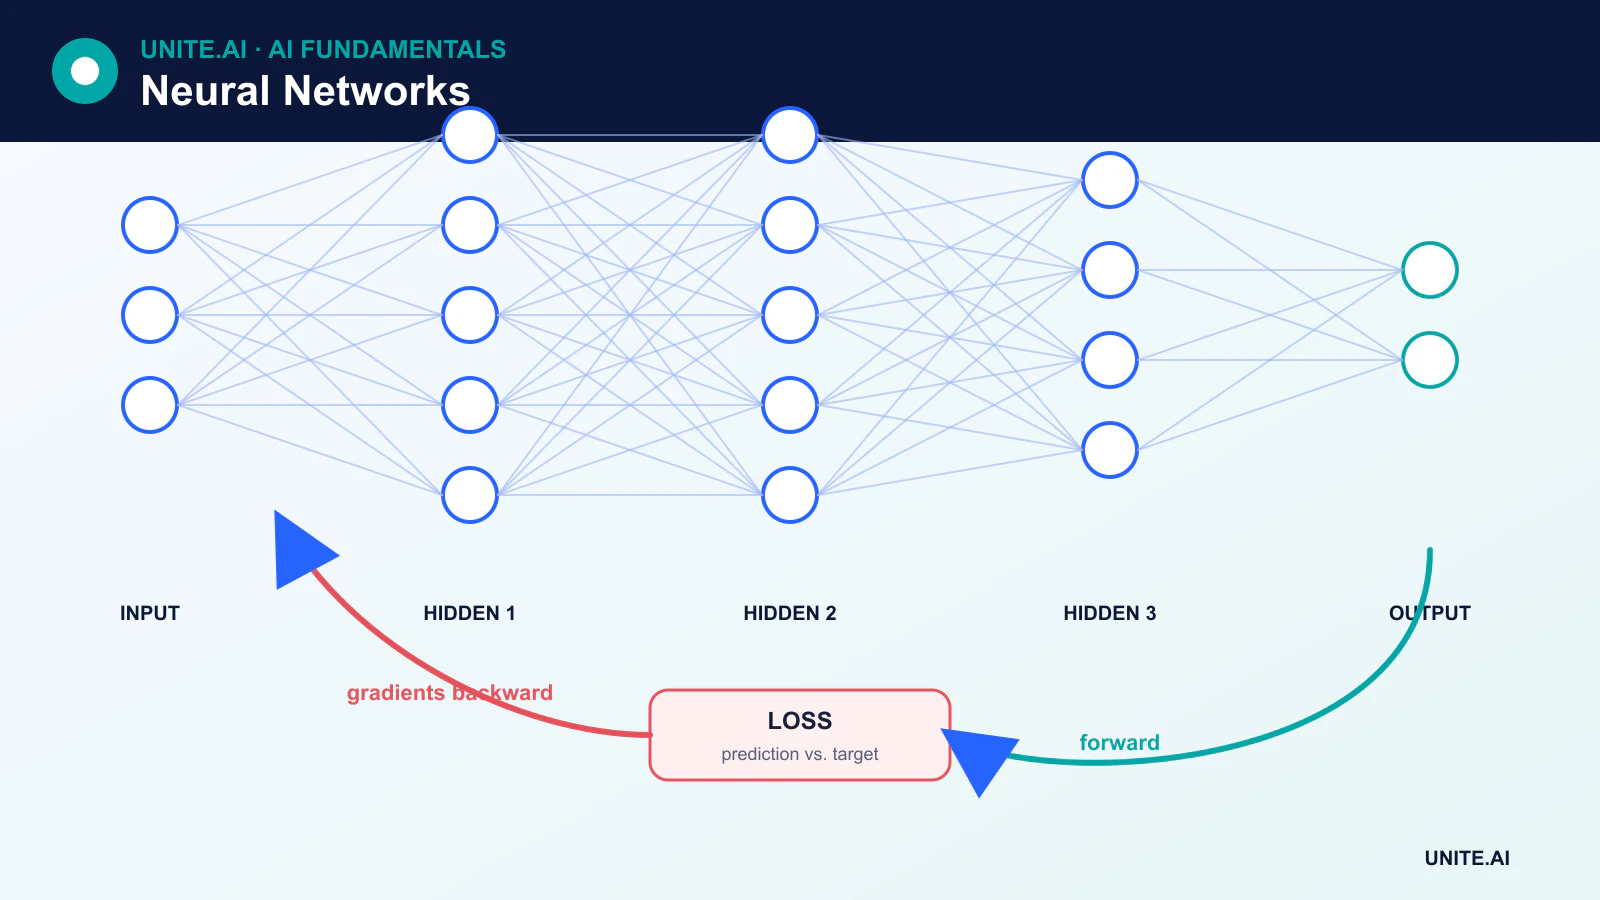
- Прямий прохід створює прогнози; функція втрат вимірює помилку; зворотне поширення обчислює градієнти; оптимізатор оновлює параметри.
- MLP, CNN, RNN та трансформери організовують зв’язки по‑різному.
- Більша кількість шарів або параметрів не гарантує кращу чи більш надійну модель.
Від окремого штучного нейрону до мережі
Для вхідного вектора x базовий елемент обчислює:
z = Wx + boutput = activation(z)
W містить навчені ваги, а b — навчене зміщення. Функція активації вводить нелінійність. Ваги не «проходять» через активацію самостійно; активація застосовується до зваженої суми та зміщення.
Багатошаровий перцептрон (MLP) складає послідовність щільних шарів. Вхідний шар представляє ознаки, приховані шари їх трансформують, а вихідний шар призначений для конкретного завдання — наприклад, логіти класу або значення регресії.
Як нейронні мережі навчаються
- Модель ініціалізує навчальні параметри.
- Прямий прохід обробляє пакет даних і створює прогнози.
- Функція втрат порівнює прогнози з ціллю навчання.
- Зворотне поширення використовує правило ланцюга для обчислення градієнтів.
- Оптимізатор, наприклад стохастичний градієнтний спуск або AdamW, оновлює ваги та зміщення.
Зворотне поширення стало центральним у навчанні нейронних мереж завдяки роботам, розробленим і популяризованим протягом кількох десятиліть; воно не було створене лише в епоху сучасного deep learning. Сучасні фреймворки реалізують автоматичне диференціювання у зворотному режимі, тому практики не повинні вручну виводити кожен градієнт.
Чому функції активації важливі
Без нелінійних активацій кілька звичайних лінійних шарів зводяться до однієї лінійної трансформації. ReLU широко використовується, оскільки простий і ефективний. GELU та SiLU поширені в сучасних архітектурах. Sigmoid і softmax залишаються корисними для певних інтерпретацій виходів, проте sigmoid може насичуватись у прихованих шарах і спричиняти зникання градієнтів.
Основні архітектури нейронних мереж
Конволюційні нейронні мережі
CNN застосовують вивчені фільтри до локальних окремих ділянок і ділять параметри між позиціями. Ці властивості роблять їх ефективними для зображень та інших сигналів у вигляді сітки.
Рекурентні мережі
RNN, LSTM та GRU оновлюють прихований стан протягом послідовності. Вони залишаються корисними для потокових та часових задач, хоча рекурентність обмежує паралельну обробку і може мати труднощі з довгими залежностями.
Трансформери
Трансформери використовують увагу для створення контекстно-залежних представлень. Резидуальні зв’язки, нормалізація, позиційна інформація та блоки feed-forward є основними складовими архітектури. Трансформери зараз лежать в основі багатьох великих мовних та мультимодальних моделей.
Автоенкодери та генеративні мережі
Автоенкодери навчаються представленням через реконструкцію. GAN, моделі дифузії та авторегресивні мережі генерують нові зразки, використовуючи різні цілі та процедури навчання.
Компоненти, що роблять глибокі мережі придатними до навчання
Сучасні системи використовують більше, ніж лише шари та активації. Резидуальні зв’язки дозволяють інформації та градієнтам обходити блоки. Нормалізація стабілізує активації. Регуляризація, розширення даних, dropout та згасання ваг можуть зменшити overfitting. Шари вбудовування відображають дискретні елементи, такі як токени, у вектори. Увага дозволяє представленню динамічно залежати від інших елементів.
Сильні та слабкі сторони
Нейронні мережі можуть навчатися ознакам з високовимірних сирих даних і масштабуватись разом з даними та обчислювальними ресурсами. Вони також можуть вимагати великі набори даних, спеціалізоване обладнання та ретельне налаштування. Їх прогнози можуть бути погано каліброваними, крихкими при зсуві розподілу, вразливими до атак та важкими для пояснення.
Архітектура має відповідати задачі та обмеженням розгортання. Для багатьох табличних задач ансамбль дерев або лінійна модель можуть бути швидшими та простішими у валідації. Для критичних застосувань продуктивність моделі слід оцінювати за підгрупами та режимами відмов, а не лише за агрегованим бенчмарком.
Шари, активації та потік інформації
Нейронна мережа складає параметризовані функції. Кожна одиниця формує зважену комбінацію вхідних даних, додає зміщення та пропускає результат через активацію, таку як ReLU, sigmoid, tanh або GELU. Наскрізне укладання шарів дозволяє створювати ієрархічні ознаки та нелінійні межі рішень. Ширина контролює кількість одиниць у шарі; глибина — кількість послідовних перетворень; зв’язність та спільне використання ваг кодує архітектуру. Вихід мережі залежить від попередньої обробки, параметрів, нормалізації та режиму інференції разом. Нейрон — це математична операція, а не буквальний біологічний нейрон чи самостійно значущий концепт.
Пряме поширення обчислює прогнози; функція втрат кількісно оцінює помилку; зворотне поширення застосовує правило ланцюга до градієнтів; оптимізатор оновлює параметри. Ініціалізація, швидкість навчання, статистика пакетів, резидуальні шляхи та нормалізація впливають на те, чи зникають градієнти, вибухають чи залишаються корисними. Регуляризація включає згасання ваг, dropout, розширення, ранню зупинку та архітектурні обмеження. Будьте уважні до поведінки навчання та валідації, аналізуйте статистику градієнтів і активацій, порівнюйте повторні запуски. Велика мережа може запам’ятовувати навчальні дані, тоді як мала може недообучатися або не захоплювати необхідну структуру.
Вибір архітектури, оцінка та розгортання
Багатошарові перцептрони обробляють фіксовані вектори; конволюційні мережі використовують локальну структуру; рекурентні та state‑space моделі обробляють послідовності; трансформери застосовують увагу; графові мережі обмінюються інформацією по ребрам. Гібриди поширені. Обирайте, керуючись індуктивним ухилом, даними, розміром послідовності чи зображення, затримкою, пам’яттю, інтерпретованістю та доступним обладнанням. Порівнюйте з лінійною або деревовою базовою моделлю та проводьте абляції, щоб дізнатись, яка складність має значення. Кількість параметрів сама по собі не передбачає якість, вартість інференції чи вимоги до даних.
Обслуговування вимагає замороженої попередньої обробки, експортованого або скомпільованого графу, чисельної валідації та тестування ресурсів при реальному навантаженні. Квантизація та обрізка можуть зменшити розмір, але можуть змінити поведінку рідкісних класів. Слідкуйте за вхідними та вихідними даними, калібруванням, затримкою та підтвердженими результатами; тестуйте на атакувальні та зсунути дані. Захищайте моделі, залежності та дані за допомогою підписаних артефактів, контролю доступу та перевірки ланцюжка постачання. Пояснення з окремих активацій або saliency потребують каузальної та поведінкової верифікації. Нейронні мережі — гнучкі апроксиматори функцій, а не гарантії розуміння, істини чи стійкості.
Практичний приклад: нейронний прогнозувальник попиту
Роздрібний продавець прогнозує щотижневий попит на товари за даними про продажі, акції, ціну, святкові дні, наявність та погоду. Мережа порівнюється з сезонним naïve, лінійним та деревовим базовими моделями, використовуючи скользячі часові розбиття. Майбутні акції включаються лише коли вони дійсно відомі на момент прогнозу, тоді як відсутність товару моделюється, бо фактичні продажі можуть недооцінювати попит. Оцінка здійснюється за допомогою зваженої абсолютної помилки, зміщення, охоплення інтервалу та результатів за швидкістю товару та магазином.
Конвеєр обслуговування включає версію доступності, модель та горизонт і відхиляє прогноз, коли необхідні вхідні дані застарілі. Планувальники бачать інтервали та можуть перевизначити їх з вказанням причин. Моніторинг виявляє відсутні потоки, зміну помилок, зміщення та незвичні прогнози; бізнес‑результати відокремлюються від точності прогнозу, оскільки політика замовлень також впливає на інвентар. Оновлення моделі тіньове протягом кількох циклів, і попередній прогнозувальник залишається доступним для відкату під час сезонних або постачальницьких порушень.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Сформулюйте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої невдачі. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені чи відсутні вхідні дані, зсув розподілу, відсутність залежностей, неправильне використання та групи або середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно введених відмов. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходів, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих чутливих даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткої точки, коли її слід вимкнути або замінити.
Часті запитання
Чи є кожна нейронна мережа deep learning?
Ні. Невелика мережа з одним прихованим шаром є нейронною мережею, тоді як deep learning зазвичай стосується архітектур з кількома навчальними етапами обробки. Межа є умовною, а не строгим науковим порогом.
Чи зберігають нейронні мережі свої навчальні дані?
Вони зберігають лише навчені параметри, а не звичайну пошукову копію набору даних. Проте великі моделі можуть запам’ятовувати та відтворювати окремі навчальні приклади, що створює ризики щодо конфіденційності та авторських прав, які потрібно перевіряти.
Основні джерела