Основи ШІ
Навчання з учителем проти навчання без учителя

 Додайте Unite.AI до бажаних джерел у Google
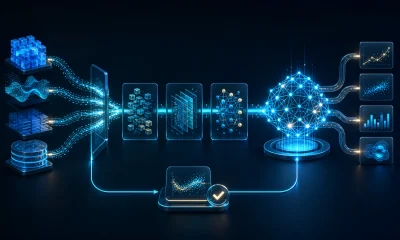
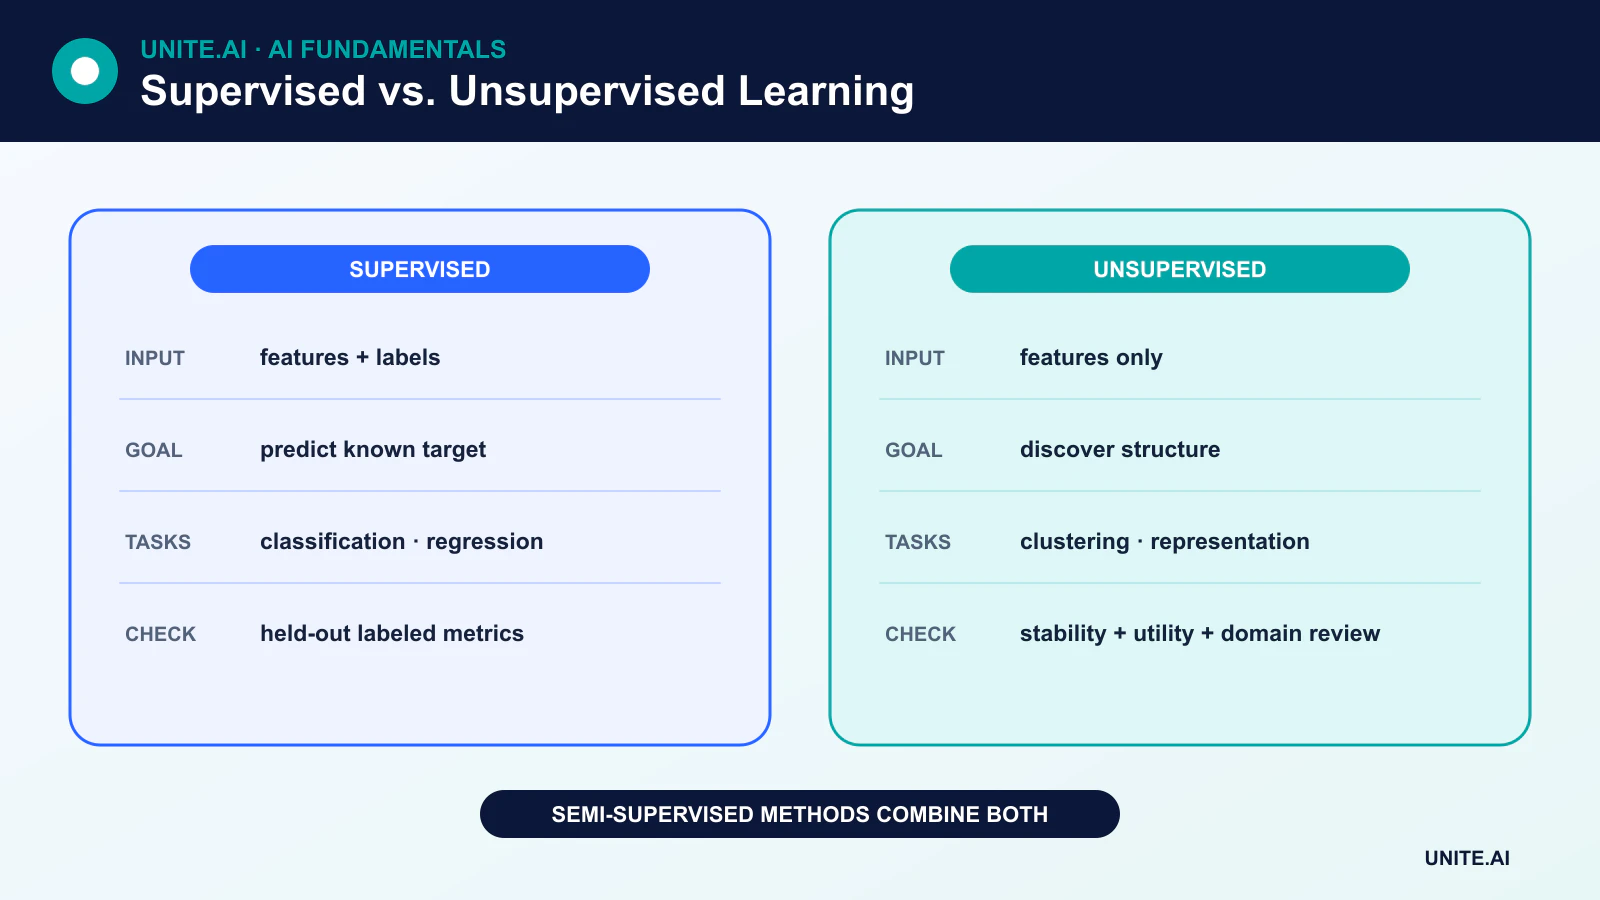
Навчання з учителем навчається на прикладах, поєднаних із цільовими відповідями. Навчання без учителя шукає структуру в даних без цільових міток. Різниця полягає не в тому, який підхід розумніший чи точніший; а в типі доступного навчального сигналу та у питанні, на яке система розрахована відповісти.
Це два основних парадигми в машинному навчанні, проте сучасні системи також використовують напівавтоматичне, самостійне та підкріплювальне навчання.
Ключові висновки
- Навчання з учителем передбачає відомий цільовий параметр; навчання без учителя виявляє шаблони або представлення.
- Класифікація та регресія — це завдання навчання з учителем; кластеризація, оцінка густини та багато методів зменшення розмірності — це навчання без учителя.
- Виходи навчання без учителя не є автоматично реальними класами у світі та можуть бути складнішими для оцінки.
- Вартість обчислень та точність залежать від алгоритму, даних, завдання та оцінки — а не лише від парадигми.
Як працює навчання з учителем
У наборі даних навчання з учителем присутні ознаки X та ціль y. Під час навчання модель налаштовується так, щоб її передбачення наближалися до цілей. Оцінка використовує відкладені позначені приклади для оцінки здатності узагальнювати.
Класифікація
Класифікація передбачає категорію: спам чи не спам, одну тему документа серед кількох, або один чи кілька об’єктів на зображенні. Важливі метрики включають точність (precision), повноту (recall), F1, калібрування та вимірювання, чутливі до вартості. Точність може вводити в оману, коли один клас є рідкісним; матриця плутанини показує, які класи плутаються.
Регресія
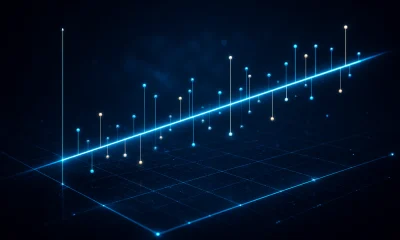
Регресія передбачає безперервне значення, наприклад попит, тривалість або температуру. Лінійна регресія може використовувати одну чи багато ознак; вона не обмежується лише встановленням зв’язку між двома змінними. Метрики регресії включають середню абсолютну помилку, кореневу середньоквадратичну помилку та специфічні для завдання витрати.
Поширені алгоритми навчання з учителем
Методи навчання з учителем включають лінійні та логістичні моделі, дерева рішень, випадкові ліси, градієнтне підсилення, машини опорних векторів, k‑найближчих сусідів та нейронні мережі.
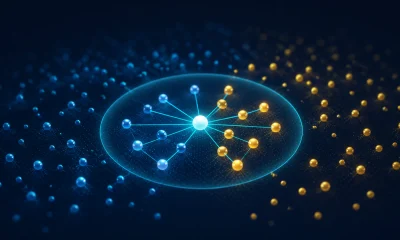
Логістична регресія генерує оцінку або ймовірність, яку можна перетворити на клас за допомогою обраного порогу. Лист дерева рішень містить передбачення, засноване на регіоні простору ознак, а не обов’язково на одному навчальному спостереженні. KNN передбачає на основі близьких позначених навчальних прикладів і все ще потребує належного розподілу даних на навчання/валидацію/тест.
Як працює навчання без учителя
Навчання без учителя отримує ознаки без цільового стовпця. Його мета визначається опосередковано — наприклад, мінімізувати відстань всередині кластерів, відновити вхід, оцінити густину даних або зберегти якомога більше дисперсії у меншій кількості вимірів.
Кластеризація
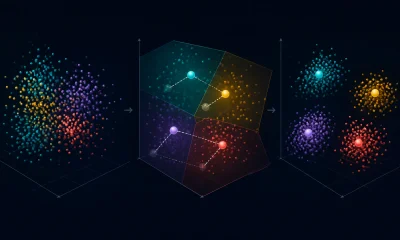
K‑means розподіляє точки по заданій кількості кластерів і оновлює центри кластерів, щоб зменшити квадратну відстань всередині кластера. Алгоритм виявляє геометричні групування за певної метрики та представлення ознак. Ці групи не автоматично відповідають значущим типам клієнтів, діагнозам чи іншим доменним міткам.
Зменшення розмірності
Зменшення розмірності представляє дані за допомогою меншої кількості змінних. Аналіз головних компонент знаходить ортогональні напрямки, які зберігають якомога більше дисперсії при лінійній проекції. Інші методи зберігають різні уявлення структури та можуть створювати зовсім інші візуалізації.
Виявлення аномалій та оцінка густини
Методи навчання без учителя можуть оцінювати, де дані густі, та позначати незвичні спостереження. Оцінка аномалії не доводить шахрайство, збій чи зловмисну дію; вона вказує на відхилення у вибраному представленні та моделі.
Як оцінюється навчання без учителя
Не існує універсального поняття «точності» у навчанні без учителя. Практик може використовувати внутрішні метрики, такі як силуетний індекс, порівнювати стабільність між вибірками, тестувати корисність у наступному завданні або запитати експертів галузі, чи є виявлена структура значущою. Якщо для оцінки існують еталонні мітки, можна застосовувати зовнішні метрики кластеризації, не перетворюючи процес навчання на навчання з учителем.
Поза двостороннім порівнянням
Напівавтоматичне навчання
Напівавтоматичне навчання поєднує менший позначений набір з більшим непозначеним набором. Прикладами є псевдо‑маркування, регуляризація узгодженості та графові методи. Непозначені дані все ж повинні достатньо схожі на цільовий розподіл, щоб бути корисними.
Самостійне навчання
Самостійне навчання отримує цілі безпосередньо з вхідних даних, наприклад, передбачаючи замасковані токени або порівнюючи трансформовані вигляди. Це фундамент для сучасних мовних, візуальних та мультимодальних моделей, включаючи трансформери.
Підкріплювальне навчання
Підкріплювальне навчання оптимізує рішення за допомогою винагород, що генеруються взаємодією. Воно відрізняється як від передбачення з мітками, так і від статичного виявлення шаблонів.
Вибір правильного підходу
Почніть з рішення або інсайту, який система повинна надати. Якщо існують надійні цілі та метою є передбачення, навчання з учителем є природним вибором. Якщо мета — дослідження, представлення або групування, підходить метод навчання без учителя. Коли міток бракує, передтренування самостійним або напівавтоматичним способом з подальшою оцінкою навчанням з учителем може бути ефективнішим.
У будь‑якому випадку витік даних, упереднене вибірковування, слабкі проксі та зсув розподілу можуть визначати вибір алгоритму. Технічно правильна модель, навченa на неправильну мету, все одно може зазнати невдачі.
Навчальні сигнали, цілі та представницькі методи
Навчання з учителем використовує приклади, поєднані з цільовими мітками або значеннями, і оптимізує передбачувальну помилку. Класифікація, регресія, ранжирування та структуроване передбачення відрізняються виходом та функцією втрат. Навчання без учителя шукає структуру без цільових міток за допомогою кластеризації, оцінки густини, зменшення розмірності, навчання представленням або генеративного моделювання. Самостійне навчання створює цілі передбачення безпосередньо з даних, тоді як напівавтоматичне навчання поєднує невеликий позначений набір з більшим непозначеним набором. Ці категорії описують навчальний сигнал; одна й та сама нейронна архітектура може бути навчена за кількома парадигмами.
Мітки роблять ціль явною, але вводять витрати на анотацію, шум, припущення політики та часову затримку. Непозначені дані легше збирати, проте вони не підказують алгоритму, яка виявлена структура корисна. Кластер може відображати освітлення, довжину документа або джерело отримання, а не значущу категорію. Оцінку слід визначати незалежно: моделі навчання з учителем використовують відкладені позначені результати, тоді як моделі без учителя потребують стабільності, відновлення, правдоподібності, пошуку, корисності у наступних завданнях або експертної верифікації. Візуальне розділення саме по собі не є доказом валідної структури.
Вибір парадигми та запобігання типових помилок
Використовуйте навчання з учителем, коли існує стабільна ціль та репрезентативні мітки. Використовуйте дослідження без учителя для підсумовування, виявлення новизни, стиснення або генерації гіпотез, проте розглядайте виходи як проміжні. Передтренування самостійним способом цінне, коли необроблених даних багато і наступні завдання спільно використовують представлення. Напівавтоматичні методи допомагають лише за умови, що припущення щодо непозначених даних та структури класів вірні. Порівнюйте зі простими базовими моделями та враховуйте загальні витрати на збір, маркування, перегляд, обчислення та помилки, а не припускайте, що непозначені дані автоматично дешеві.
Запобігайте витоку даних, розділяючи пов’язані сутності перед створенням міток, аугментацій чи псевдо‑міток. Слідкуйте за балансом класів, погодженістю анотацій, стабільністю кластерів, їх колапсом та зсувом. Псевдо‑мітки можуть підкріплювати ранні помилки; кластеризація може кодувати чутливі атрибути; попередньо навчене представлення може передавати вихідний упереджений. Перегляд людьми має зосереджуватись на граничних випадках та їх наслідках. У продакшн‑середовищі документуйте, як був створений навчальний сигнал і коли він стає застарілим. Парадигма визначає, де у систему входить нагляд, а не чи присутні людські вибори та цінності.
Практичний приклад: виявлення та маркування тем підтримки
Компанія спочатку використовує непозначені векторні представлення та кластеризацію для дослідження тем у анонімізованих повідомленнях підтримки. Аналітики переглядають представницькі та граничні приклади і виявляють, що деякі кластери відображають довжину повідомлення та канал, а не проблеми. Вони розробляють навчальну таксономію з невідомим класом, інструкціями щодо анотації та виміряною погодженістю. Класифікатор потім оцінюється на пізніших періодах, мовах та продуктах у порівнянні з базовими підходами за ключовими словами та найближчими сусідами.
Непозначені нові повідомлення допомагають виявляти дрейф, проте не переучують класифікатор автоматично. Рецензенти маркують обрані невизначені та нові випадки за допомогою активного навчання, з перевірками якості та закритим набором для оцінки. Моніторинг відстежує поширеність тем, впевненість, розбіжності та результати маршрутизації. Коли запускається новий продукт, таксономія та потужність підрозділів оновлюються разом. Робочий процес використовує методи без учителя для генерації гіпотез і навчання з учителем для операційної маршрутизації.
Докази впровадження та готовність до експлуатації
Рішення щодо впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версіонований набір для оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг шляхом навмисного введення збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходу, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑показники залишаться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Основні джерела