
Основи ШІ
Що таке підкріплювальне навчання?

 Додайте Unite.AI до бажаних джерел у Google
Підкріплювальне навчання (RL) — це фреймворк машинного навчання, у якому агент вчиться діяти, взаємодіючи зі середовищем. Після кожної дії середовище змінюється і може повернути нагороду. Метою агента є вивчення політики, яка максимізує очікувану сукупну нагороду, а не лише нагороду за наступний крок.
RL використовується, коли рішення розгортаються протягом часу і одна дія впливає на те, що станеться далі. Це концептуально відрізняється від контрольованого навчання, де набір даних надає цільову відповідь для кожного прикладу навчання.
Основні висновки
- Проблема RL містить агента, середовище, стани, дії, нагороди та політику.
- Позитивне та негативне підкріплення обидва підвищують поведінку; покарання знижує її.
- Агент повинен балансувати між дослідженням незнайомих дій та використанням вже відомих ефективних дій.
- Методи, засновані на значеннях, політиці, актор‑критик, моделі та офлайн, вирішують різні налаштування RL.
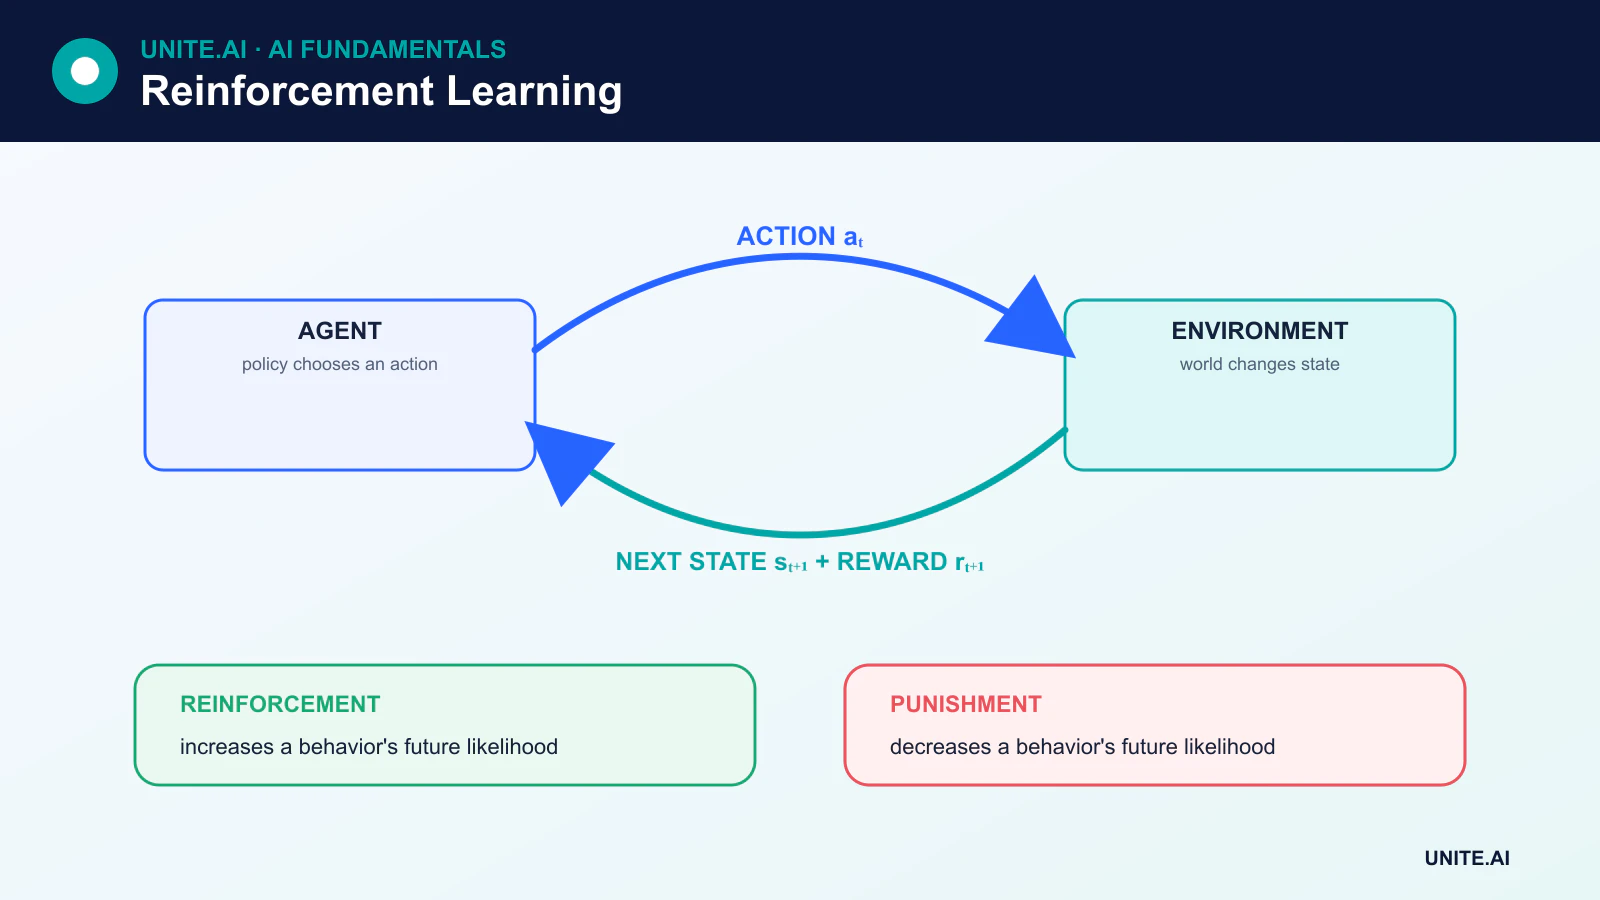
Компоненти підкріплювального навчання
Багато задач RL моделюються як марковський процес прийняття рішень (MDP). MDP включає:
- Стан: інформація, що описує поточну ситуацію.
- Дія: вибір, доступний агенту.
- Перехід: як стан змінюється після дії.
- Нагорода: негайний зворотний зв’язок, що виникає внаслідок переходу.
- Політика: стратегія агента щодо вибору дій.
- Коефіцієнт дисконтування: наскільки майбутні нагороди враховуються порівняно з негайними.
Стан не обов’язково повинен відкривати всю інформацію про світ. Коли важлива інформація прихована, задача може бути частково спостережуваною, і агенту може знадобитися пам’ять або стан віри.
Підкріплення не те саме, що покарання
Термінологія походить від поведінкової психології. Позитивне підкріплення додає наслідок, який робить поведінку більш ймовірною. Негативне підкріплення усуває неприємну умову і також робить поведінку більш ймовірною. Штраф, спрямований на зменшення ймовірності дії, є покаранням, а не негативним підкріпленням.
У машинному навчанні практики частіше говорять безпосередньо про позитивні нагороди, негативні нагороди, витрати та штрафи. Основне питання — як ці сигнали формують повернення, яке агент намагається максимізувати.
Повернення, цінність та призначення кредиту
Нагорода описує один перехід. Повернення об’єднує нагороди протягом часу, зазвичай дисконтуючи нагороди, що надходять у далекому майбутньому. Функція цінності стану оцінює очікуване повернення зі стану, тоді як функція цінності дії оцінює очікуване повернення після виконання певної дії в цьому стані.
Це створює проблему призначення кредиту: якщо корисний результат приходить значно пізніше, які ранні дії заслуговують на кредит? Алгоритми RL різняться у способах оцінки цього зв’язку.
Методи Монте‑Карло та навчання з часовою різницею
Методи Монте‑Карло навчаються на повних вибіркових поверненнях, зазвичай після завершення епізоду. Методи часової різниці (TD) оновлюють оцінку до кінцевого результату, комбінуючи спостережувану нагороду з оцінкою того, що буде далі. Тому навчання TD базується на поточних оцінках цінності.
Жодна з сімей не є універсально кращою. Цілі Монте‑Карло є незміщеними за вибірковою політикою, але можуть мати високу дисперсію та потребувати завершення епізоду. Методи TD можуть навчатися онлайн і на безперервних завданнях, проте їхні бутстреп‑цілі вводять упередженість.
Дослідження проти використання
Дослідження збирає інформацію, випробовуючи дії, цінність яких невизначена. Використання обирає дію, яка, на даний момент, вважається найкращою за поверненням. Агент, який ніколи не досліджує, може застрягти у поганій стратегії; агент, який ніколи не використовує, не отримує вигоди від того, чого навчився.
Прості стратегії включають ε‑жадібний вибір дій, дослідження, засноване на довірі, бонуси ентропії та методи внутрішньої нагороди. У безпечних критичних умовах необмежене дослідження може бути неприйнятним, тому важливими стають симуляція, обмеження, офлайн‑дані або людський нагляд.
Основні підходи підкріплювального навчання
Методи, засновані на цінності
Q‑навчання та пов’язані алгоритми вивчають цінності дій і формують політику, обираючи дії з високою цінністю. Глибоке підкріплювальне навчання використовує нейронні мережі для апроксимації функцій цінності або політик, коли простір станів надто великий для таблиці.
Методи градієнту політики
Методи градієнту політики безпосередньо коригують параметризовану політику для покращення очікуваного повернення. Вони корисні для безперервних дій та стохастичних політик, проте можуть мати оцінки градієнту з високою дисперсією.
Методи актор‑критик
Актор обирає дії, тоді як критик оцінює цінність і забезпечує навчальний сигнал. Це поєднує пряму оптимізацію політики з оцінкою цінності.
Моделізоване та безмодельне підкріплювальне навчання
Системи, засновані на моделі, вивчають або використовують модель переходів і нагород, щоб планувати. Безмодельні системи вивчають цінності або політики без явного моделювання середовища. Методи, засновані на моделі, можуть ефективно використовувати досвід, проте помилки у вивченій моделі можуть вводити в оману планування.
Офлайн підкріплювальне навчання
Офлайн RL навчається на фіксованому наборі даних, а не збирає нові взаємодії під час тренування. Це може знизити вартість або ризик дослідження, проте агент повинен уникати переоцінки дій, які погано представлені в даних.
RLHF та людські уподобання
Підкріплювальне навчання за людським зворотним зв’язком (RLHF) використовує дані уподобань для навчання сигналу нагороди або прямої оптимізації політики. Воно застосовувалося для узгодження поведінки мовних моделей з людськими оцінками. Оптимізація уподобань не гарантує правдивості чи безпеки: результати залежать від того, хто надавав зворотний зв’язок, що саме оцінювалося та як було сформульовано мету.
Обмеження
RL може вимагати величезної кількості взаємодій, поводитися нестабільно під час навчання та використовувати ненавмисні скорочення у функції нагороди. Оцінка складна, оскільки результати можуть змінюватися в залежності від випадкових зерен та деталей середовища. Рекомендовані практики включають множинні запуски, прозорі базові лінії, обмежені цілі, тестування поза розподілом та моніторинг під час «хакерства» нагород.
Проектування задачі RL: стан, дія, нагорода та горизонт
Підкріплювальне навчання моделює послідовні рішення. Середовище генерує спостереження, агент обирає дію згідно політики, а перехід дає нагороду та наступне спостереження. Марковський процес прийняття рішень передбачає, що стан містить інформацію, необхідну для прогнозування майбутніх переходів і нагород; часткова спостережуваність вимагає пам’яті, стану віри або рекурентних представлень. Дисконтування контролює вагу відкладених результатів, тоді як епізодичні та безперервні завдання потребують різних визначень повернення. Поганий дизайн стану або дії може зробити розв’язну мету невивченою.
Проєктування нагороди визначає поведінку опосередковано і є основним джерелом провалів. Проксі може бути використано у шкідливих цілях: агент, що отримує нагороду за швидкість, може ігнорувати безпеку, тоді як агент, що отримує нагороду лише після завершення завдання, може отримувати занадто мало навчального сигналу. Додайте обмеження та правила завершення, засновані на реальних вимогах, тестуйте чутливість нагороди та аналізуйте траєкторії на предмет небажаних стратегій. Методи дослідження балансують збір інформації та використання поточних знань. Дані поза політикою можуть підвищити ефективність вибірки, проте невідповідність між поведінковою та цільовою політикою вимагає спеціальних алгоритмів.
Оцінка, симуляція та безпечне впровадження
Методи, засновані на цінності, оцінюють очікуване повернення для станів або дій; методи градієнту політики оптимізують параметризовану політику; методи актор‑критик вивчають обидва. Моделізоване RL вивчає або використовує динаміку переходів для планування. Вибір підходящої сім’ї залежить від типу дії, даних, точності симулятора, горизонту та вимог до стабільності. Порівнюйте з евристичними, контрольованими та теоретичними базовими лініями. Оцінюйте середнє та найгірше повернення, порушення обмежень, ефективність вибірки, стійкість до змін середовища та дисперсію між різними зернами, а не лише найкращу криву навчання.
Онлайн‑дослідження може бути неприйнятним у охороні здоров’я, фінансах, робототехніці та інфраструктурі. За можливості навчайте у симуляції або на записаних даних, кількісно оцініть розрив між симулятором і реальністю та обережно використовуйте оцінку поза політикою, оскільки невидимі дії не мають підтримки. Впровадження має обмежувати дії, швидкість, ресурси та робочу область; включати людське схвалення для важливих рішень; і забезпечувати безпечний контролер або аварійне вимкнення. Моніторьте нагороду разом з реальними результатами, бо агент може підвищити свій бал, шкодячи запланованій меті. Перевіряйте знову після змін середовища, політики чи нагород.
Практичний приклад: управління енергією за допомогою підкріплювального навчання
Оператор будівлі моделює температуру, зайнятість, погоду, стан обладнання та ціну електроенергії, причому дії обмежені безпечними корекціями встановлених точок. Нагорода поєднує комфорт, енергію, плати за попит та обмеження обладнання, проте реальні порушення комфорту оцінюються окремо, тому оптимізація нагороди не може приховати шкоду. Історичний контроль та модельно‑прогнозний контроль слугують базовими лініями. Навчання здійснюється у каліброваному симуляторі з випадковою погодою, шумом датчиків та ефективністю обладнання.
Перед впливом на будівлю політика запускається на живих спостереженнях без виконання дій. Інженери перевіряють траєкторії, запас обмежень та поведінку під час свят, спеки, відключень та відсутності датчиків. Впровадження обмежує швидкість та діапазон дій і зберігає існуючий безпечний контролер. Людина може втрутитися в будь‑який момент. Моніторинг порівнює енергію та комфорт із відповідними періодами, реєструє втручання та відкачує зміни, якщо порушення, неочікуване циклювання або невідповідність моделі перевищують встановлені пороги.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, робоче середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректні або відсутні дані, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість завдання разом з калибруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапне розгортання, зберігайте безпечний резерв і перевіряйте моніторинг шляхом навмисного внесення збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку вихідних, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім переглядайте реальні докази після впровадження, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткої точки, в якій її слід вимкнути або замінити.
Основні джерела












