
Основи ШІ
Що таке лінійна регресія?

 Додайте Unite.AI до бажаних джерел у Google
Лінійна регресія моделює безперервну цільову змінну як лінійну комбінацію однієї або декількох вхідних ознак. Її використовують для прогнозування, оцінки та як прозору базову модель, щоб зрозуміти, чи додає більш складна модель значущу цінність.
Слова незалежна змінна та залежна змінна описують ролі в моделі, а не доведений причинно‑наслідковий зв’язок. Регресія може виявити асоціацію, хоча спотворення, упередженість вибору, зворотна причинність або помилка вимірювання пояснюють взаємозв’язок.
Основні висновки
- Цільова змінна y моделюється за допомогою вхідних ознак X; у старішій версії статті ці мітки були переплутані в одному поясненні формули.
- Метод найменших квадратів (OLS) мінімізує суму квадратів залишків.
- Діагностика залишків та припущення мають значення для інференції та оцінки невизначеності.
- Регуляризація Ridge та Lasso допомагає, коли предиктори численні або корельовані.
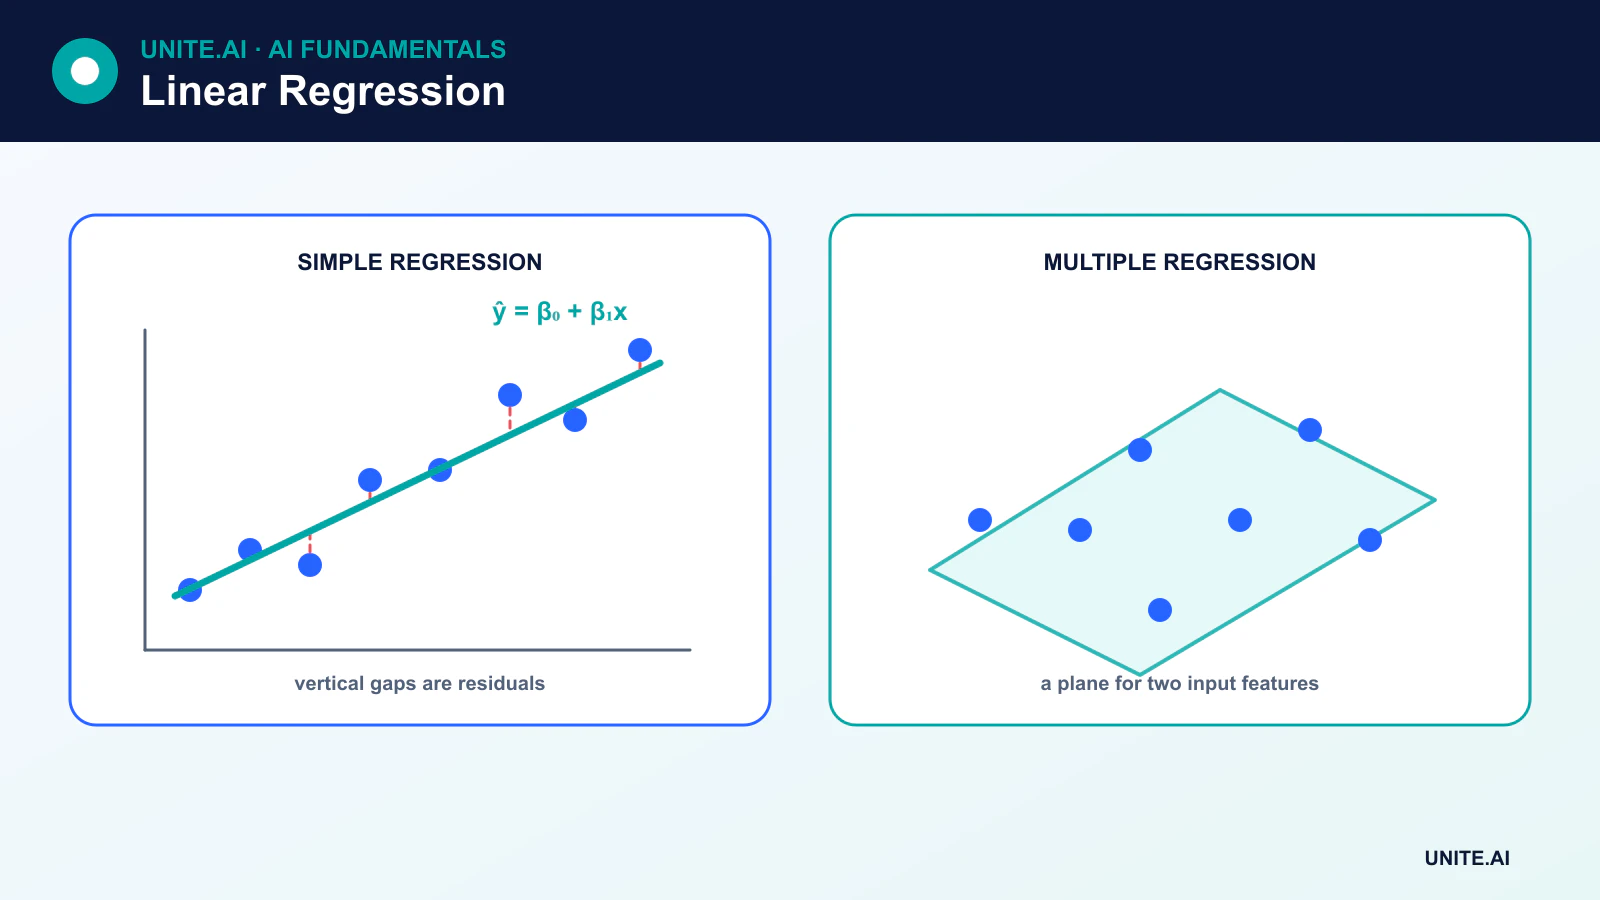
Проста лінійна регресія
При одній ознаці модель має вигляд:
ŷ = β₀ + β₁x
β₀ — це інтерцепт, а β₁ — нахил. Залишок для спостереження i дорівнює yᵢ - ŷᵢ. Метод найменших квадратів (OLS) обирає коефіцієнти, які мінімізують суму квадратів залишків.
Нахил оцінює очікувану зміну цільової змінної, пов’язану зі зміною ознаки на одну одиницю у підгоненій моделі. Його не слід описувати як причинний ефект, якщо лише дизайн дослідження та припущення не підтримують причинну ідентифікацію.
Множинна лінійна регресія
При p ознаках:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Кожен коефіцієнт інтерпретується за умови фіксованих інших включених ознак. Множинна регресія може включати категоріальні змінні через кодування, поліноміальні члени та взаємодії. Вона залишається «лінійною», оскільки лінійна щодо коефіцієнтів, навіть якщо включені перетворені ознаки, такі як x².
Припущення та діагностика
Для прогнозування головне питання — наскільки добре модель узагальнюється. Для класичних тестів коефіцієнтів та інтервалів додаткові припущення стають важливими:
- Лінійність: умовне середнє представлено обраною лінійною формою.
- Незалежні або правильно змодельовані помилки: повторні, згруповані, просторові або часові спостереження можуть вимагати іншої структури помилок.
- Постійна дисперсія помилок: гетероскедастичність впливає на стандартні помилки та оцінки невизначеності.
- Обмежена мультиколінеарність: сильно корельовані предиктори роблять окремі коефіцієнти нестабільними.
- Розподіл залишків: нормальність важлива для деяких висновків за малих вибірок, але не є вимогою, щоб кожна ознака була нормально розподілена.
Графіки залишків, показники важливості та впливу, а також експертний перегляд можуть виявити викиди, нелінійність, змінну дисперсію або спостереження, які домінують у підгонці.
Оцінка прогнозів
- Середня абсолютна помилка (MAE) усереднює абсолютний розмір залишків.
- Середня квадратична помилка (MSE) надає більшу вагу великим помилкам.
- Кореневе середнє квадратичної помилки (RMSE) повертає квадрат помилки у одиниці цільової змінної.
- R² порівнює варіацію залишків з константною базовою лінійкою на оцінюваних даних.
R² не є мірою точності, не встановлює причинність і може бути від’ємним на відкладених даних. Валідація повинна відповідати реальним умовам прогнозування, включаючи розподіл за часом або групами, коли це необхідно.
Ridge, lasso та elastic net
Ridge‑регресія додає L2‑штраф, який стискає коефіцієнти та стабілізує корельовані предиктори. Lasso додає L1‑штраф і може занулювати коефіцієнти. Elastic net поєднує обидва підходи. Зазвичай ознаки потребують сумісного масштабування перед порівнянням цих штрафів.
Регуляризація вводить упередженість в обмін на меншу дисперсію і може зменшити перепідгонку. Сила штрафу підбирається за допомогою валідації, а не на фінальному тестовому наборі.
Коли лінійна регресія — неправильний інструмент
Лінійна модель може не впоратися, коли взаємозв’язки сильно нелінійні, помилки залежать від попередніх значень, розподіл цільової змінної потребує спеціалізованого моделювання, або кілька викидів домінують у квадратичній втраті. Дерева рішень, узагальнені лінійні моделі, моделі часових рядів, стійка регресія або нелінійні методи можуть підходити краще.
Навіть коли складна модель переважає, лінійна регресія залишається цінною базовою моделлю. Якщо велика система не може стабільно перевершити її, додаткова складність може бути необґрунтованою.
Припущення моделі, оцінка та діагностика
Лінійна регресія моделює умовне середнє числового результату як інтерцепт плюс зважені предиктори. Метод найменших квадратів обирає коефіцієнти, які мінімізують квадрати залишків. Коефіцієнти описують очікувану зміну результату при зміні предиктора на одну одиницю за умови, що інші включені змінні залишаються постійними, згідно зазначеної моделі. Це лише асоціація, якщо лише припущення щодо причинної ідентифікації та дизайн дослідження не виправдовують інше. Одиниці, кодування, трансформації, взаємодії та референтні категорії визначають інтерпретацію, тому коефіцієнти без словника даних є неповними.
Класична інференція спирається на припущення щодо функціональної форми, незалежних помилок, постійної дисперсії та розподілу помилок для конкретних тестів і інтервалів. Графіки залишків проти підгонених значень виявляють нелінійність або гетероскедастичність; Q–Q графіки оцінюють поведінку хвостів; діагностика важливості та впливу ідентифікує спостереження, які сильно впливають на оцінки. Корельовані предиктори збільшують невизначеність і роблять окремі коефіцієнти нестабільними, навіть коли прогнози залишаються адекватними. Можуть знадобитися стійкі стандартні помилки, трансформації, сплайни, ієрархічна структура або інша модель, замість видалення незручних даних.
Регуляризація, оцінка та відповідальне використання
Ridge‑регресія стискає коефіцієнти за допомогою L2‑штрафу, тоді як lasso може занулювати деякі з них за допомогою L1‑штрафу; elastic net поєднує обидва підходи. Стандартизувати предиктори, коли шкала штрафу має бути порівнянною, і підбирати силу за допомогою валідації або крос‑валідації. Оцінювати середню абсолютну помилку, кореневу середню квадратичну помилку, розподіл залишків, калібрування по діапазонах та невизначеність, використовуючи розбиття за часом або групами, що відповідає застосуванню. Порівнювати з середньою базовою моделлю та нелінійними альтернативами, але зберігати лінійні моделі, коли важливі прозорість і стабільність.
Екстраполяція за межі спостережуваного діапазону предикторів слідує підгоненій лінії без доказів і може бути небезпечною. Слідкуйте за діапазонами ознак, пропусками, залишками та помилками підгруп у виробництві. Інтервали прогнозу описують індивідуальну невизначеність результату і ширші, ніж інтервали довіри для середнього; обидва потребують припущень. Уникайте контролю за змінними, які вводять причинний упереджений, коли метою є оцінка ефекту. Лінійна регресія — це точний інструмент для визначеного зв’язку, а не універсальна гарантія, що світ лінійний або що коефіцієнт представляє втручання.
Практичний приклад: оцінка часу доставки
Логістична команда моделює тривалість доставки за допомогою відстані, рівня обслуговування, регіону, дня тижня та відомих погодних умов. Вона аналізує нелінійні патерни залишків і додає обґрунтовані сплайни та взаємодії, замість розглядати лінійне рівняння як буквальну фізику. Групи перевізників та маршрутів визначають валідаційні складки. Звітуються середня абсолютна помилка, хвостова помилка, покриття інтервалу та систематичне упередження. Скасовані доставки та дані, записані після прибуття, виключаються або моделюються явно.
Коефіцієнти документуються в одиницях і перевіряються на нестабільність за наявності корельованих предикторів. Модель відмовляється від екстраполяції за межі валідаційних діапазонів відстані та регіону. Інтервали прогнозу супроводжують оцінки, і подальше планування використовує їхню невизначеність. Моніторинг відстежує діапазони ознак, залишки, покриття інтервалу та упередження після змін у мережі. Причинне твердження щодо перевізника або погоди не робиться на основі предиктивних коефіцієнтів; для підтримки втручання потрібні операційні експерименти або більш сильна ідентифікація.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більшого, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відключення залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаються без підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною спроможністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити доказ від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість вводу, поведінку виводу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткого моменту, коли її слід вимкнути або замінити.
Поширені запитання
Чи потребує лінійна регресія лише одну вхідну змінну?
Ні. Проста регресія має один предиктор, тоді як множинна лінійна регресія може використовувати багато числових, закодованих категоріальних, трансформованих та взаємодіючих ознак.
Чи може лінійна регресія довести причинність?
Ні. Причинна інтерпретація вимагає обґрунтованого дослідницького дизайну та припущень щодо спотворення, вибору, вимірювання та втручання. Один лише предиктивний коефіцієнт описує асоціацію у підгоненій моделі.
Основні джерела












