Основи ШІ
Що таке градієнтний спуск?

 Додайте Unite.AI до бажаних джерел у Google
Градієнтний спуск — це метод оптимізації, який коригує параметри моделі, щоб зменшити функцію мети. При навчанні нейронних мереж ця мета зазвичай є втратою, обчисленою за прикладами. Градієнт вказує напрямок найкрутішого локального зростання, тому градієнтний спуск робить крок у протилежному напрямку.
Градієнт описує локальну чутливість; його величина не є прямим виміром того, наскільки швидко модель «вчиться». Реальний прогрес також залежить від швидкості навчання, кривизни, шуму, параметризації, стану оптимізатора та даних.
Основні висновки
- Зворотне поширення обчислює градієнти, тоді як градієнтний спуск використовує їх для оновлення параметрів.
- Оптимізація міні‑пакетами є стандартним практичним підходом у глибокому навчанні.
- Швидкість навчання контролює масштаб оновлення і може слідувати графіку, а не зменшуватись після кожного кроку.
- Імпульс, AdamW, обрізка та нормалізація вирішують різні проблеми оптимізації.
Базове правило оновлення
Для вектору параметрів θ, швидкості навчання η та функції втрат L:
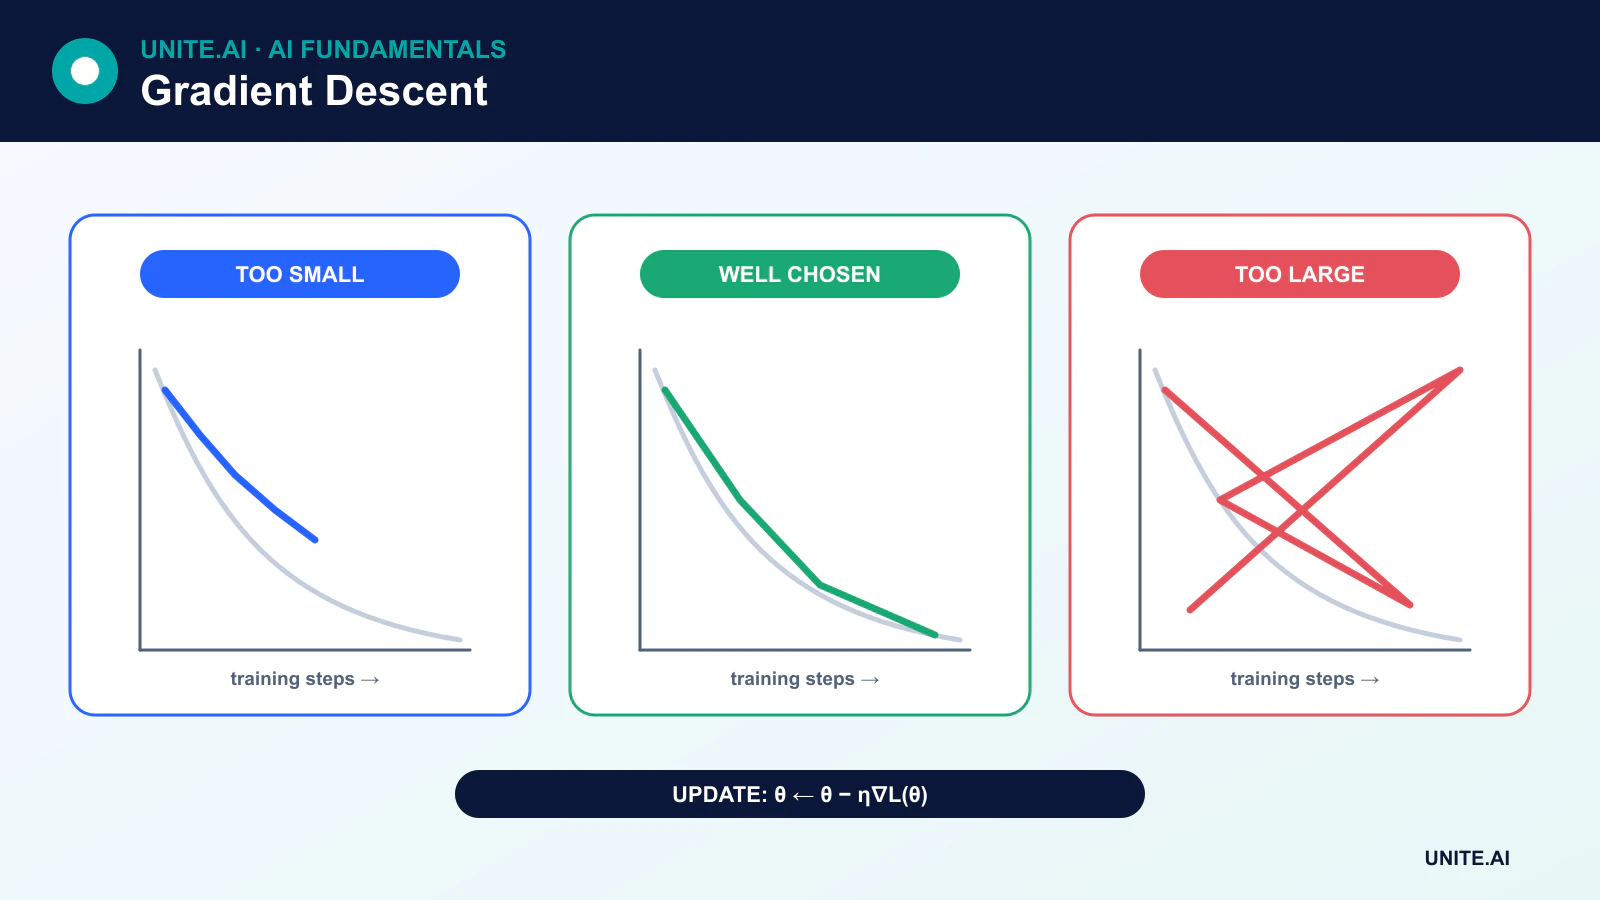
θ ← θ - η∇L(θ)
Градієнт ∇L(θ) містить одну часткову похідну на кожен параметр. Віднімаючи його, ми рухаємося вниз локально. Стаціонарна точка має нульовий градієнт, але це може бути мінімум, максимум, сіда́льна точка або плоска область. Поверхні втрат у глибокому навчанні є невипуклими, тому навчання не гарантує знаходження унікального глобального мінімуму або нульових втрат.
Методи пакетного, стохастичного та міні‑пакетного навчання
Пакетний градієнтний спуск
Пакетний градієнтний спуск обчислює градієнт, використовуючи весь навчальний набір при кожному оновленні. Оцінка стабільна, але може бути дорогою за часом і пам’яттю, і одне оновлення може недоцільно використовувати сучасні прискорювачі.
Стохастичний градієнтний спуск
Строгий стохастичний градієнтний спуск використовує один випадково обраний приклад при кожному оновленні. Його градієнти шумні, що може допомагати дослідженню поверхні втрат, проте операції з одним прикладом можуть бути неефективними на паралельному обладнанні.
Міні‑пакетний градієнтний спуск
Навчання міні‑пакетами оцінює градієнт за підмножиною прикладів. Воно поєднує статистичний шум з ефективними матричними операціями і є звичним підходом у глибокому навчанні. Розмір пакету впливає на пам’ять, пропускну здатність, шум градієнту, нормалізацію та іноді на узагальнення.
Вибір швидкості навчання
Швидкість, що занадто велика, може перескочити корисні області або спричинити розбіжність. Швидкість, що занадто мала, може зробити навчання практично надто повільним або зупинитися у плоских областях. Найкращий масштаб залежить від оптимізатора, розміру пакету, моделі, ініціалізації та мети.
Графіки можуть поступово розігріватися, зменшуватись у визначених точках, слідувати косинусній кривій або реагувати на прогрес валідації. Швидкість не обов’язково повинна монотонно зменшуватись після кожного оновлення. Теплі перезапуски та циклічні графіки навмисно збільшують її протягом частин навчання.
Імпульс
Імпульс підтримує експоненціальне згортання середнього значення минулих градієнтів. Він може прискорювати прогрес у стабільних напрямках і зменшувати коливання по крутим, вузьким напрямкам. Імпульс у стилі Нестерова оцінює або апроксимує градієнт після перегляду вперед уздовж напрямку імпульсу.
Адаптивні оптимізатори
RMSProp масштабує оновлення, використовуючи рухоме середнє квадратів градієнтів. Adam поєднує моменти першого порядку, схожі на імпульс, з масштабуванням за другим моментом. AdamW роз’єднує згасання ваг від адаптивного оновлення градієнту і широко використовується для трансформерів.
Адаптивні оптимізатори часто спрощують раннє навчання, проте вони не автоматично кращі для кожної моделі чи кінцевої мети узагальнення. Порівняння оптимізаторів вимагає узгоджених графіків і ретельного налаштування.
Обрізка та накопичення градієнтів
Обрізка градієнтів обмежує норму або значення градієнту, щоб зменшити вплив вибухових градієнтів, особливо у рекурентному або нестабільному навчанні. Накопичення градієнтів додає градієнти з кількох менших пакетів перед оновленням, апроксимуючи більший ефективний пакет, коли пам’ять обмежена.
Моніторинг оптимізації
Відстежуйте втрати під час навчання та валідації, метрики задачі, швидкість навчання, норми градієнтів, норми параметрів та числові помилки. Падіння втрат під час навчання при погіршенні валідаційної продуктивності вказує на переобучення, а не на успішну оптимізацію, яку слід автоматично продовжувати.
Оптимізація мінімізує задану їй цільову функцію. Низькі втрати не доводять, що дані, метрика або реальна поведінка є адекватними. Протікання, погані мітки та невідповідна ціль можуть створити добре оптимізовану, але шкідливу модель.
Геометрія оптимізації та правила оновлення
Градієнтний спуск оновлює параметри у протилежному напрямку до градієнту втрати. Повний пакетний спуск використовує кожен навчальний приклад на крок; стохастичний — один; міні‑пакетні методи оцінюють градієнт за підмножиною і домінують у глибокому навчанні. Швидкість навчання задає масштаб кроку. Надто мала втрачає обчислювальні ресурси або зупиняється; надто велика викликає коливання або розбіжність. Імпульс накопичує рухомий напрямок, тоді як адаптивні методи, такі як Adam, масштабує координати, використовуючи моменти градієнту. Їх різні неявні упередження можуть створювати моделі з подібними втратами під час навчання, але різною узагальнювальною здатністю.
Поверхні втрат у нейронних мережах містять плоскі та різкі області, сіда́льні точки, симетрії та погано умовлені напрямки. Масштабування ознак, нормалізація, ініціалізація, залишкові зв’язки та передумовлення змінюють геометрію, яку бачить оптимізатор. Графіки можуть розігріватися, зменшуватись, циклічно змінюватись або реагувати на плато. Згасання ваг відрізняється від простого додавання L2‑штрафу в деяких адаптивних оптимізаторах. Розмір пакету впливає на шум, пам’ять, паралелізм та режим швидкості навчання, тому порівняння оптимізаторів потребують узгоджених бюджетів навчання та ретельного налаштування.
Діагностика, відтворюваність та зупинка
Відстежуйте втрати під час навчання та валідації, метрики задачі, норми градієнтів і параметрів, швидкість навчання, пропускну здатність та числові попередження. Розбіжність може виникнути через пошкоджені пакети, недійсні мітки, нестабільну змішану точність або неправильне зведення втрат. Плато може вказувати на недостатню потужність, насичені активації, погані ознаки, надмірну регуляризацію або проблему графіка. Переобучення потребує даних, аугментації, регуляризації або ранньої зупинки — а не ствердження, що оптимізатор зазнав невдачі. Перевірте представницькі помилки та порівняйте просту базову модель перед збільшенням складності навчання.
Відтворюваність вимагає використання випадкових зерен, порядку даних, коду, конфігурації, апаратних та бібліотечних версій, хоча деякі ядра прискорювачів залишаються недетермінованими. Зберігайте контрольні точки разом зі станом оптимізатора та планувальника, щоб навчання могло продовжуватись послідовно. Оберіть контрольну точку за критерієм валідації, встановленим заздалегідь, і залиште незмінний тестовий набір. У розподіленому навчанні підтвердіть ефективний розмір пакету, усереднення градієнтів та обробку збоїв робітників. Оптимізація мінімізує обрану цільову функцію на доступних даних; вона не гарантує каліброваних ймовірностей, причинно‑наслідкових роздумів, справедливості, безпеки чи практичної корисності.
Практичний приклад: налаштування оптимізатора для мовної моделі
Команда фіксує токенізатор, порядок даних, модель, ефективний пакет та бюджет токенів для навчання, а потім порівнює SGD з імпульсом та AdamW за різними обґрунтованими графіками швидкості навчання. Розігрів, згасання, згасання ваг, обрізка та точність фіксуються. Кожен кандидат запускає кілька випадкових зерен, а валідація використовує відкладений часовий сегмент плюс оцінки задач. Пропускна здатність та енергія повідомляються разом із втратою, щоб трохи кращий оптимізатор не був обраний за непропорційну ціну.
Діагностика виявляє, чи походить нестабільність від одного фрагмента даних, надмірного розміру кроку, підпливу чи архітектури моделі. Контрольні точки зберігають стан оптимізатора та планувальника і відновлюються у тесті. Остаточний вибір базується на якості та надійності валідації, а не на найнижчих втратам під час навчання. Закритий тестовий набір запускається один раз після вибору. Продукційне інференс окремо калібрується та моніториться, оскільки успіх оптимізатора під час передтренування не гарантує безпечної чи правдивої поведінки.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої невдачі. Встановіть відтворювану базу та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зсув розподілу, відмову залежностей, неправильне використання та групи чи середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість задачі разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Зафіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та відсторонення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія повинна виявляти якість вхідних даних, поведінку вихідних результатів, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та збереження, а також чіткого моменту, коли її слід вимкнути або замінити.
Часто задавані питання
Чи завжди градієнтний спуск досягає глобального мінімуму?
Ні. Для випуклих цілей існують відповідні умови, які забезпечують сильні гарантії. Цілі глибоких мереж є невипуклими, і практичні оптимізатори зазвичай шукають корисне рішення, а не доводять, що знайшли унікальний глобальний мінімум.
Чому нульовий градієнт може вводити в оману?
Нульовий або дуже малий градієнт може свідчити про мінімум, максимум, сіда́льну точку, насичення або плоске плато. Діагностика навчання повинна враховувати історію втрат, кривизну, масштаб параметрів та валідаційну продуктивність.
Основні джерела