
Основи ШІ
Що таке перенавчання?

 Додайте Unite.AI до бажаних джерел у Google
Перенавчання виникає, коли модель захоплює патерни або шум, які надзвичайно добре працюють на її навчальних даних, але не здатні узагальнюватися на нові приклади. Перенавчена модель може мати дуже низьку помилку на навчанні, тоді як показники на валідації або в реальному світі значно гірші.
Протилежна проблема — недонавчання: модель або процес навчання не можуть захопити достатньо сигналу навіть на навчальному наборі. Якісне моделювання балансує між підгонкою та узагальненням, а не прагне до ідеальної продуктивності на навчанні.
Ключові висновки
- Тільки показники навчання не можуть діагностувати узагальнення.
- Раннє зупинення має базуватись на поведінці валідації, а не на повторних рішеннях щодо фінального тестового набору.
- Більше даних може допомогти, проте більше ознак або потужності також може погіршити перенавчання.
- Регуляризація, аугментація, крос‑валідація, запобігання витоку даних та належна оцінка вирішують різні причини.
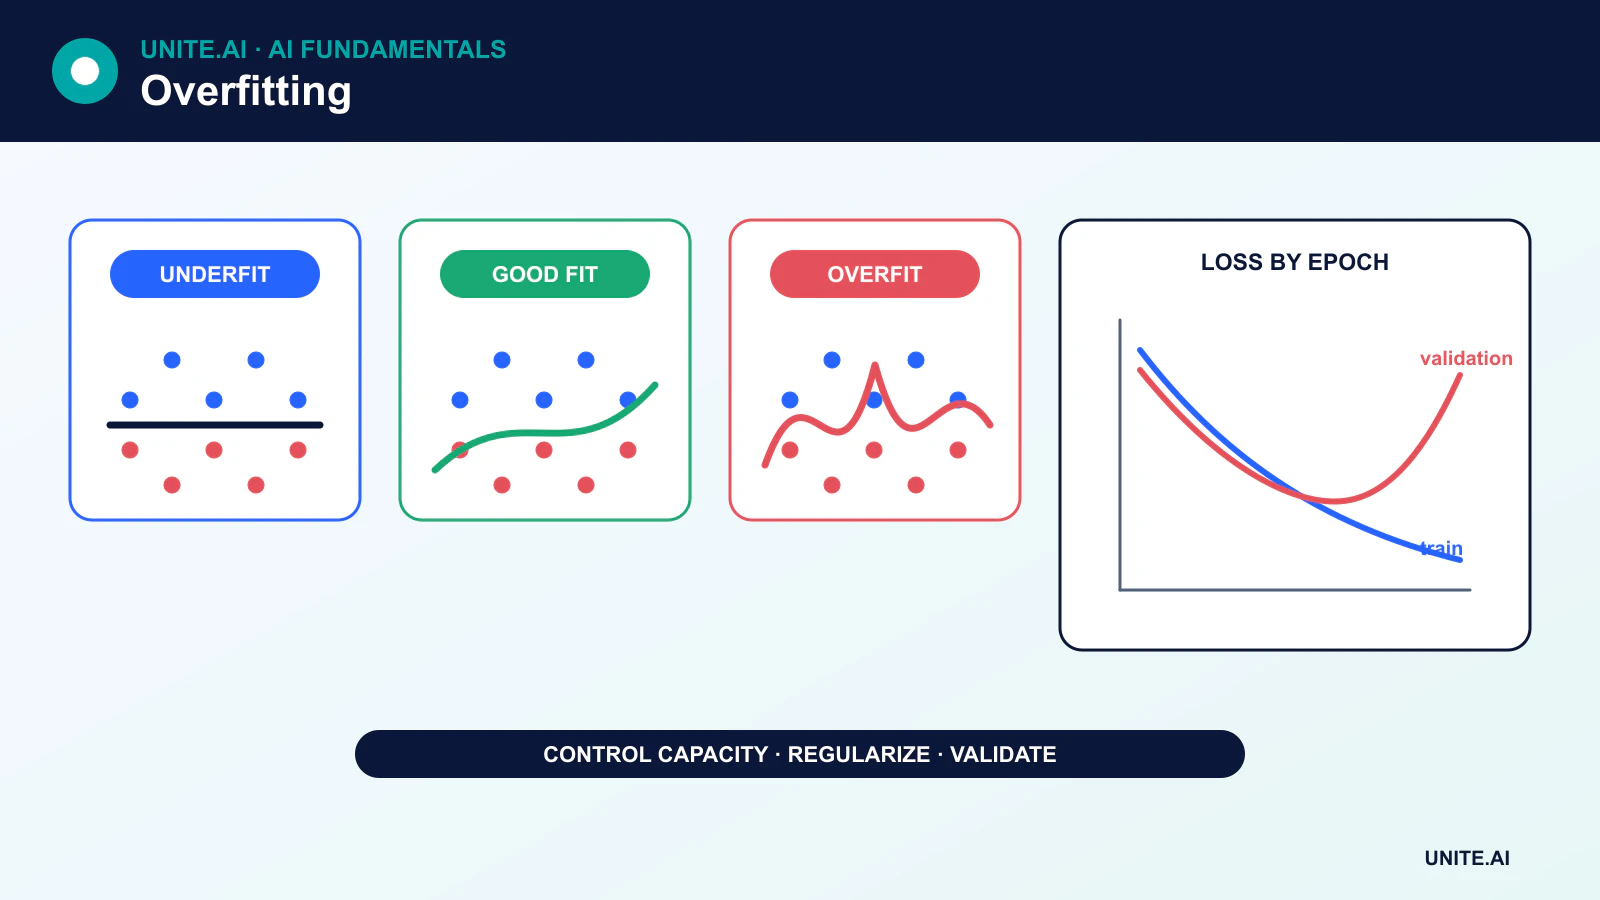
Підгонка, недонавчання та перенавчання
Модель недонавчається, коли її припущення надто обмежувальні, ознаки пропускають важливий сигнал, оптимізація недостатня або навчання недостатнє. Додавання релевантних ознак або потужності може допомогти, проте просте додавання довільних ознак може збільшити шум і перенавчання.
Модель перенавчається, коли її ефективна потужність занадто висока щодо інформації в навчальних даних. Прикладами є глибоке дерево рішень, яке створює крихітні листки, поліном, що слідує випадковим коливанням, або нейронна мережа, що запам’ятовує приклади.
Роль навчальних, валідаційних та тестових даних
- Навчальні дані підгоняють параметри моделі.
- Валідаційні дані вибирають архітектуру, гіперпараметри, пороги та момент зупинки.
- Тестові дані надають остаточну оцінку після завершення цих виборів.
Якщо тестовий набір постійно використовується для прийняття рішень, він стає частиною процесу розробки і більше не забезпечує неупереджену остаточну оцінку. Крос‑валідація може ефективніше використовувати обмежені дані, проте вся передобробка та відбір ознак мають виконуватись всередині кожного навчального фолду.
Раннє зупинення
Під час навчання втрата на навчанні зазвичай продовжує падати. Втрата на валідації може спочатку знижуватись, а згодом зростати, коли модель спеціалізується на шумі навчальних даних. Раннє зупинення зберігає контрольну точку з найкращою валідаційною метрикою або зупиняє процес після того, як валідація не покращується протягом визначеного періоду терпіння.
Правильна контрольна точка — це не та, що має найнижчу втрату на навчанні. Окремий фінальний тестовий набір оцінюється після завершення раннього зупинення та налаштувань.
Методи регуляризації
Штрафи за ваги
L2‑регуляризація або згасання ваг заохочує уникати великих значень параметрів. L1‑регуляризація може сприяти розрідженим коефіцієнтам. Їхній вплив залежить від моделі та оптимізатора; наприклад, AdamW роз’єднує згасання ваг від адаптивного оновлення.
Dropout та стохастична регуляризація
Dropout випадково маскує активації під час навчання. Інші методи відкидають шляхи, змінюють ознаки або згладжують мітки. Ці техніки змінюють цільову функцію навчання і повинні бути вимкнені або коректно оброблені під час інференсу.
Аугментація даних
Аугментація створює реалістичні варіації — наприклад, обрізки, обертання, шум або перефразування — які мають зберігати ціль. Неправильні трансформації можуть змінити мітку і нашкодити моделі. Для комп’ютерного зору інструменти, такі як Albumentations, допомагають впроваджувати контрольовані конвеєри.
Контроль потужності
Менші дерева, менша кількість параметрів, відбір ознак, обрізка та простіші класи гіпотез можуть знизити дисперсію. Обрізка дерев здійснюється за критерієм, а не випадковим видаленням вивчених деталей.
Витік даних може виглядати як надзвичайна продуктивність
Витік даних відбувається, коли інформація, недоступна під час передбачення, потрапляє у навчання або оцінку. Типові приклади включають нормалізацію на всьому наборі даних, розподіл повторюваних записів між фолдами, використання майбутніх даних для передбачення минулого або включення ознаки, отриманої з цільової змінної.
Витік не є звичайним перенавчанням, проте створює той самий оманливий розрив між офлайн‑результатами та розгортанням. Стратегія розподілу повинна враховувати час, ідентичність, місце та процеси генерації даних.
Зміна розподілу — окрема проблема
Модель може узагальнюватися на тестовому розподілі і все ж зазнавати провалу, коли дані у виробництві змінюються. Нові пристрої, політики, популяції, сезони або ворожа поведінка можуть змінювати взаємозв’язок між вхідними даними та цільовою змінною. Моніторинг та періодичне переоцінювання необхідні навіть тоді, коли початкова модель не була перенавченою.
Діагностика перенавчання
Використовуйте навчальні криві, дисперсію крос‑валідації, метрики підгруп, калібрування та аналіз помилок. Якщо і навчальна, і валідаційна продуктивність низька, зосередьтеся на недонавченні, ознаках, мітках або оптимізації. Якщо навчання сильне, а валідація слабка, досліджуйте потужність, витік даних, регуляризацію та репрезентативність перед простим збільшенням обсягу даних.
Чому виникає перенавчання і як його виявити
Перенавчання виникає, коли модель вивчає закономірності, що знижують помилку навчання, але не узагальнюються на цільову популяцію. Причини включають надмірну потужність щодо ефективних даних, шум у мітках, повторювані сутності, гнучкий відбір ознак, витік даних та налаштування на одному і тому ж валідаційному наборі. Зростаючий розрив між показниками навчання та валідації є типовим доказом, проте невеликий розрив не виключає перенавчання, якщо обидва набори мають спільне забруднення або відрізняються від розгортання. Навчальні криві за обсягом даних та потужністю допомагають розрізнити дисперсію та упередженість.
Витік даних особливо оманливий: майбутня інформація, дублікати, перекриття суб’єктів, передобробка, підгонка на всіх даних, або мітки, закодовані в метаданих, можуть дати відмінні результати на відкладеному наборі. Розділяйте дані за одиницею, яка буде новою під час розгортання — пацієнт, клієнт, машина, місце або час — перед підгонкою трансформацій або аугментацій. Тримайте фінальний тестовий набір закритим під час вибору ознак, архітектури та порогів. Якщо команди постійно аналізують результати тесту, тестовий набір стає ще одним валідаційним набором і потребує заміни або формальної корекції.
Регуляризація, вибір моделі та дрейф у виробництві
Зменшіть перенавчання за допомогою більш репрезентативних даних, меншої потужності, згасання ваг, dropout, раннього зупинення, аугментації, ансамблювання або обмежень, що відображають структуру домену. Кожен метод має компроміси: аугментація може спотворювати мітки, dropout змінює оптимізацію, а ансамблі підвищують вартість обслуговування. Крос‑валідація оцінює варіативність вибору, проте згруповані або часові фолди повинні зберігати межу розгортання. Порівнюйте зі простою моделлю та повідомляйте невизначеність по фолдах або випадкових ініціалізаціях, а не обирайте найвигідніший запуск.
У виробництві може виявитися інша форма провалу узагальнення, коли змінюються вхідні дані, користувачі, стимули або вимірювання. Моніторьте розподіли ознак та передбачень, калібрування, результати підгруп та затриману правду. Не переобучайте автоматично на непереглянутих відгуках; рішення моделі можуть формувати мітки, які вона пізніше бачить. Діагностуйте, чи провал викликаний дрейфом, конвеєрами даних, змінами політики чи недійсною ціллю. Перенавчання контролюється експериментальним дизайном та дисципліною життєвого циклу, а не одним налаштуванням регуляризації.
Практичний приклад: усунення витоку в моделі шахрайства
Початкова модель класифікації шахрайства отримує надзвичайно високі оцінки, оскільки повторювані транзакції карт та торговців з’являються у випадкових рядках навчального та тестового наборів, а інформація про відшкодування, записана через кілька тижнів, включена як ознака. Команда відтворює час доступності кожної ознаки, видаляє поля після прийняття рішення, групує за рахунком і використовує розподіл за часом вперед. Продуктивність різко падає, але тепер оцінює реальне рішення. Проста базова модель правил та навчальні криві визначають необхідну складність моделі.
Регуляризація та раннє зупинення налаштовуються лише в межах історичних фолдів. Остаточна оцінка повідомляє точність при обсязі перегляду, повноту, калібрування та вартість за типом шахрайства та сегментом клієнтів. У виробництві підтверджені мітки надходять із запізненням і упереджені тим, які транзакції були переглянуті, тому моніторинг розділяє дрейф оцінок від оцінок результатів. Переобучення використовує судові випадки та повторне застосування до поточної політики. Проєкт віддає перевагу нижчій чесній оцінці, а не високій витікованій, яка не може вижити у розгортанні.
Докази впровадження та готовність до експлуатації
Рішення щодо впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректні або відсутні вхідні дані, зміну розподілу, відмову залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Зафіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат і виведення з експлуатації. Використовуйте поетапне розгортання, збережіть безпечний резерв і перевірте моніторинг за допомогою навмисно внесених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги тривоги та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часті запитання
Чи може проста модель перенавчитися?
Так. Повторюваний відбір ознак, налаштування порогів або оцінка на тому самому відкладеному наборі можуть призвести до перенавчання процесу розробки, навіть якщо кінцева модель проста.
Чи завжди більше навчальних даних вирішує проблему перенавчання?
Ні. Більше репрезентативних, правильно маркованих даних може допомогти, проте дубльовані, упереджені, витіковані або дані поза доменом можуть не допомогти. Ціль навчання та дизайн оцінки залишаються важливими.
Основні джерела












