
Основи ШІ
Що таке дерево рішень?

 Додайте Unite.AI до бажаних джерел у Google
Дерево рішень — це модель контролюваного навчання, яка робить передбачення, застосовуючи послідовність правил «якщо‑то». Кожен внутрішній вузол тестує ознаку, кожна гілка представляє результат цього тесту, а кожен листок дає передбачення класу, ймовірність або числове значення.
Дерева рішень використовуються для класифікації та регресії. Їхня привабливість практична: вони можуть представляти нелінійні взаємодії, потребують відносно невеликих попередніх обробок і створюють шлях, який можна переглянути. Їхня слабкість — нестабільність: невеликі зміни в навчальних даних можуть створити інше дерево.
Ключові висновки
- Дерево рекурсивно розбиває простір ознак; йому не потрібно ізолювати кожне навчальне спостереження.
- Для класифікації розщеплення зазвичай використовують нечистоту Джині або ентропію, тоді як у регресії розщеплення зменшують помилку передбачення або дисперсію.
- Глибина, мінімальний розмір листка та обрізка контролюють складність і перепідгонку.
- Випадкові ліси та градієнтно‑підсилювані дерева підвищують предиктивну потужність, комбінуючи багато дерев.
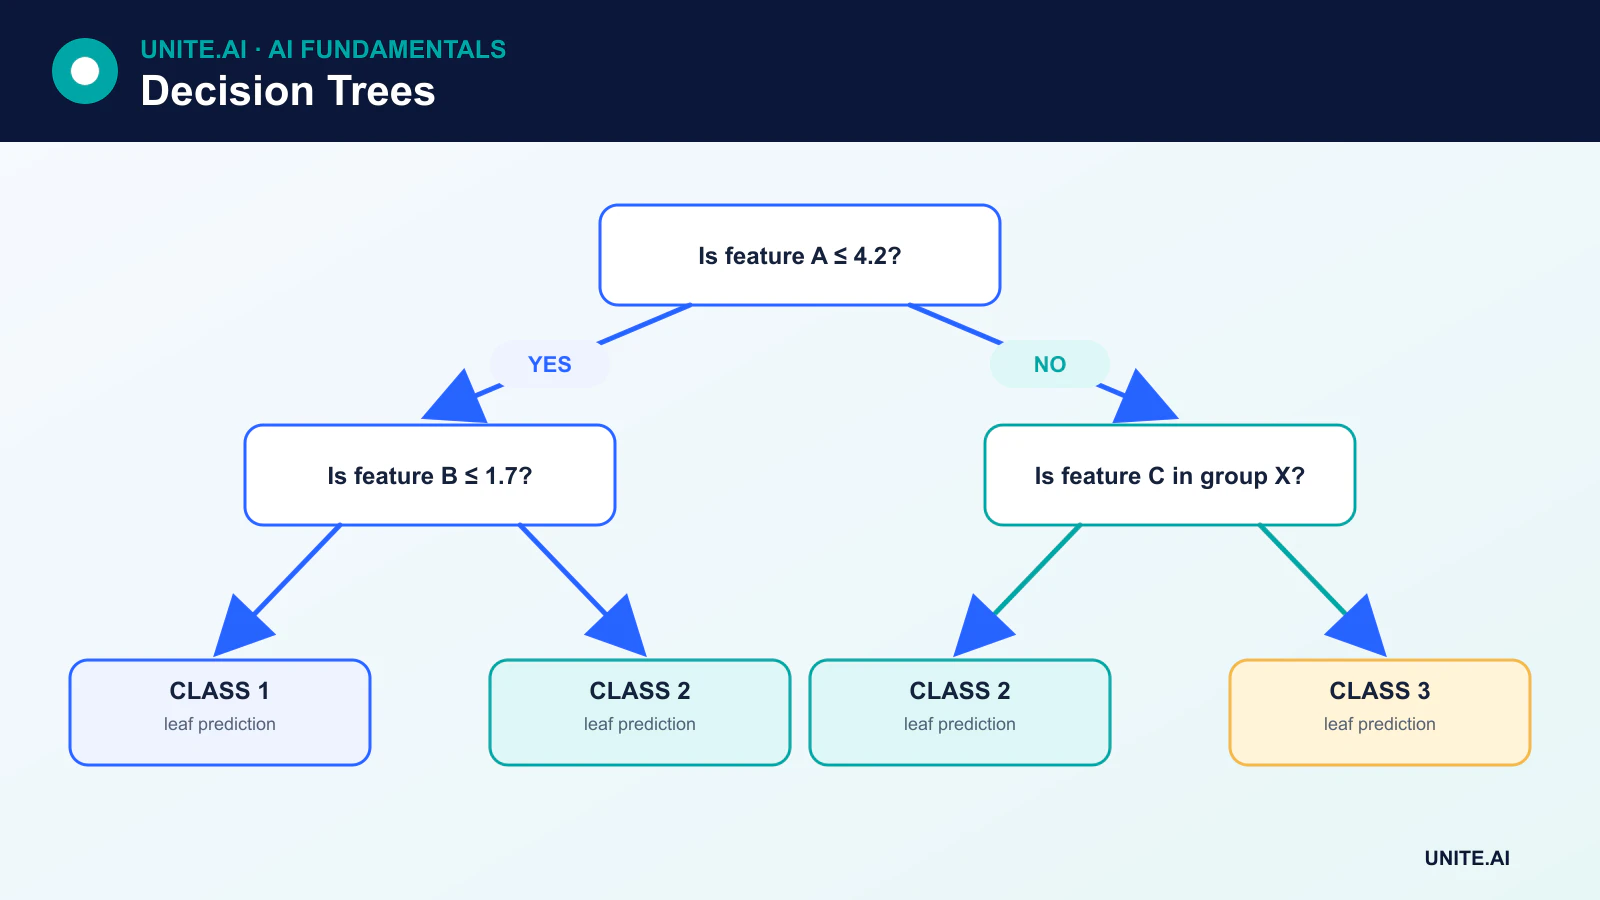
Як дерево рішень робить передбачення
Припустимо, модель передбачає, чи ймовірно, що машина вийде з ладу. Кореневий вузол може запитати, чи перевищує вібрація навчальний поріг. Далі гілка може перевіряти робочу температуру. Спостереження потрапляє до листка, що містить оцінку ймовірності відмови серед навчальних прикладів, які пройшли той самий шлях.
Для регресії листок може повертати середнє значення цільової змінної спостережень у цьому регіоні. Для класифікації він може повертати домінуючий клас або розподіл частот класів. У листку може бути багато спостережень; повне розділення навчальних даних зазвичай небажане, оскільки може призвести до перепідгонки дерева.
Як дерево обирає розщеплення
Навчання розглядає кандидатські ознаки та пороги, а потім вибирає розщеплення, яке найбільше покращує визначену мету. Покращення має бути зважене за кількістю спостережень, що переходять до кожного дочірнього вузла.
Нечистота Джині
Для класифікації нечистота Джині вимірює, наскільки змішані класи у вузлі:
Gini = 1 - Σ p(k)²
Вузол, що містить лише один клас, має нечистоту нуль. Кандидатське розщеплення корисне, коли зважена нечистота його дочірніх вузлів нижча за нечистоту батьківського вузла.
Ентропія та приріст інформації
Ентропія — інша міра невизначеності класу:
Entropy = -Σ p(k) log₂ p(k)
Приріст інформації — це ентропія батька мінус зважена ентропія дочірніх вузлів. Джині та ентропія часто дають схожі дерева, хоча не завжди ідентичні.
Регресійна втрата
Дерева регресії зазвичай обирають розщеплення, які зменшують квадратичну помилку, абсолютну помилку або інший регресійний критерій. Кожен листок потім передбачає значення, базуючись на цільових значеннях навчання у цьому регіоні.
CART та інші алгоритми дерев
CART, або Classification and Regression Trees, використовує бінарні розщеплення і лежить в основі поширених реалізацій, таких як дерева рішень scikit-learn. Інші алгоритми включають ID3, C4.5 та C5.0. Реалізації відрізняються підтримуваними типами розщеплень, обробкою пропущених значень, обрізкою та цілями.
Категоріальні змінні можуть вимагати кодування, прямих підмножинних розщеплень або специфічної для реалізації обробки. Пропущені значення можна імпутувати або обробляти за допомогою вивчених напрямків за замовчуванням або сурогатних розщеплень. Важливо розуміти поведінку конкретної бібліотеки, а не припускати, що всі реалізації дерев працюють однаково.
Контроль складності дерева
Глибоке дерево може запам’ятовувати шум. Типові засоби контролю включають:
- Максимальна глибина: обмежує довжину шляху передбачення.
- Мінімальна кількість зразків на розщеплення або листок: запобігає надто малим регіонам.
- Мінімальне зменшення нечистоти: вимагає, щоб розщеплення давало достатню вигоду.
- Максимальна кількість листків: обмежує загальну складність.
- Обрізка за вартістю‑складністю: видаляє гілки, покращення яких не виправдовує додану складність.
Обрізка — це структурований процес оптимізації, а не випадкове видалення. Гіперпараметри слід підбирати за допомогою даних валідації або крос‑валідації, при цьому фінальний тестовий набір залишають незмінним.
Сильні та слабкі сторони
Дерева рішень можуть моделювати взаємодії та порогові ефекти без масштабування ознак. Вони приймають числові та, залежно від реалізації, категоріальні вхідні дані. Передбачення швидке, а невелике дерево легко візуалізувати.
Однак одне дерево може мати високу дисперсію, створювати різкі зміни передбачень біля розщеплення та віддавати перевагу ознакам з великою кількістю можливих точок розщеплення. Дерева також погано екстраполюють у регресії: поза спостережуваними регіонами листок все одно повертає значення, отримане з його навчальних зразків. Велике дерево може бути не більш зрозумілим, ніж інша складна модель.
Від одного дерева до ансамблів
Ансамблеве навчання поєднує кілька моделей. Випадковий ліс навчає багато дерев на повторно вибраних спостереженнях та підмножинах ознак, а потім усереднює їх передбачення. Градієнтне підсилення будує дерева послідовно, так що кожне нове дерево виправляє залишкову помилку. Ці підходи зазвичай перевершують одне дерево, проте вони жертвують частиною інтерпретованості та додають обчислювальні витрати.
Важливість ознак, отримана з дерева або ансамблю, слід інтерпретувати обережно. Важливість, заснована на нечистоті, може бути упередженою, і важливість ознаки не доводить причинність. Пермутаційна важливість, інструменти часткової залежності та експертиза галузі надають додатковий контекст.
Як дерево навчає розщеплення та передбачення
Дерево рішень рекурсивно розбиває простір ознак. На кожному вузлі навчальний алгоритм оцінює кандидатські пороги ознак або розподілення категорій і вибирає розщеплення, яке найбільше зменшує нечистоту, наприклад, нечистоту Джині або ентропію для класифікації та квадратичну помилку для регресії. Листки зберігають розподіл класів або числове передбачення, базоване на навчальних спостереженнях, що до них потрапляють. Жадібне розщеплення є обчислювально практичним, проте не гарантує глобально найкращого дерева, і різні вибірки або правила вирішення нічиїх можуть створювати різні структури.
Неперервні, порядкові, категоріальні та пропущені ознаки потребують явної обробки. One‑hot кодування може створювати багато кандидатських розщеплень; власні категоріальні методи можуть використовувати упорядковану статистику, проте потребують безпечної від витоку реалізації. Дерева не вимагають масштабування, проте можуть віддавати перевагу змінним з великою кардинальністю та ізолювати малі групи. Глибина, мінімальний розмір листка, мінімальне зменшення нечистоти та обрізка за вартістю‑складністю контролюють дисперсію. Обирайте їх за допомогою даних валідації та оцінюйте калібрування, оскільки ймовірність листка, заснована на невеликій кількості випадків, може бути екстремальною та нестабільною.
Інтерпретація, режими відмов і використання у продакшн
Шлях від кореня до листка є точним правилом для одного передбачення моделі, проте це не автоматично каузальне пояснення. Корельовані змінні можуть заміняти одна одну, невеликі зміни даних можуть змінити верхні розщеплення, і на вигляд простий шлях може залежати від упереджених міток. Глобальна важливість ознак, заснована на нечистоті, може вводити в оману; пермутаційна важливість, часткова залежність та контрфактичні перевірки додають контекст, але мають свої припущення. Подавайте інформацію про невизначеність і тестуйте, чи дійсне правило працює на незалежних даних та у відповідних підгрупах.
Одинарні дерева корисні, коли важливі прозорість, низька затримка та помірна нелінійна структура, проте ансамблі зазвичай забезпечують кращу предиктивну ефективність. Перевіряйте поведінку на межах, рідкісні категорії, пропуски та вхідні дані поза діапазоном навчання. Експортовані правила повинні точно відтворювати попередню обробку навчання та числові порівняння. Слідкуйте за заповнюваністю листків, розподілом виходів, помилками та новими категоріями. Дерево, яке направляє багато нових випадків у крихітний або раніше порожній регіон, має спровокувати перегляд, навіть якщо сукупний зсув залишається малим. Зберігайте резервний варіант для недійсних схем і документуйте кожне рішення щодо обрізки чи порогу.
Практичний приклад: інтерпретоване дерево триажу кредитів
Кредитор використовує дерево лише для пріоритизації неповних заявок на ручну перевірку, а не для схвалення чи відхилення кредиту. Цільовим показником є задокументований результат повноти, а ознаки, доступні під час подачі, виключають подальші рішення. Групована тимчасова валідація порівнює неглибоке обрізане дерево з правилами та логістичною регресією. Мінімальний розмір листка запобігає правилам, заснованим на кількох заявниках, при цьому калібрування та помилки, специфічні для класу, повідомляються за каналами та відповідними захищеними групами.
Рецензенти бачать точний шлях та вихідні значення, але можуть виправляти помилкові дані та переопреділяти маршрутизацію. Організація тестує корельовані проксі та контрфактичні зміни, стежить за заповнюваністю листків та пропусками, і розглядає раптовий потік у маленький листок як інцидент якості даних. Зміни політики створюють нову версію моделі та валідацію, а не незадокументоване редагування розщеплення. Оскільки використання впливає на доступ та навантаження, заявники отримують людський канал, і дерево ніколи не подається як каузальне пояснення кредитоспроможності.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої відмови. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відсутність залежності, неправильне використання та групи або середовища, які, ймовірно, залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених відмов. Операційна телеметрія має виявляти якість вводу, поведінку виходу, версію моделі або правила, стан залежностей, людські переоприділення та підтверджені результати без збору зайвих чутливих даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Основні джерела












