
Основи ШІ
Що таке пояснювальний ШІ?

 Додайте Unite.AI до бажаних джерел у Google
Explainable AI (XAI) охоплює методи та практики, які допомагають людям розуміти поведінку або вихід системи ШІ. Пояснення може описувати впливові вхідні дані, показувати подібний приклад, представляти контрфактичну зміну, підсумовувати глобальне правило або повідомляти, коли система не знає.
Жодне пояснення не є універсально найкращим. Розробник, що налагоджує модель, аудитор, що перевіряє дотримання політики, та особа, на яку впливає рішення, потребують різних доказів. Тому пояснення слід оцінювати за точністю, змістом та передбаченим використанням — а не лише за візуальною привабливістю.
Основні висновки
- Прозорість описує доступну інформацію; інтерпретованість стосується значення; пояснення передає докази або причини.
- Глобальні методи підсумовують модель, тоді як локальні методи стосуються однієї передбачення або невеликої області.
- Постхок пояснення можуть бути корисними, проте можуть бути нестабільними або недостовірними щодо базової моделі.
- Пояснення не доводить справедливість, причинність, стійкість або правильність.
Чотири принципи корисних пояснень
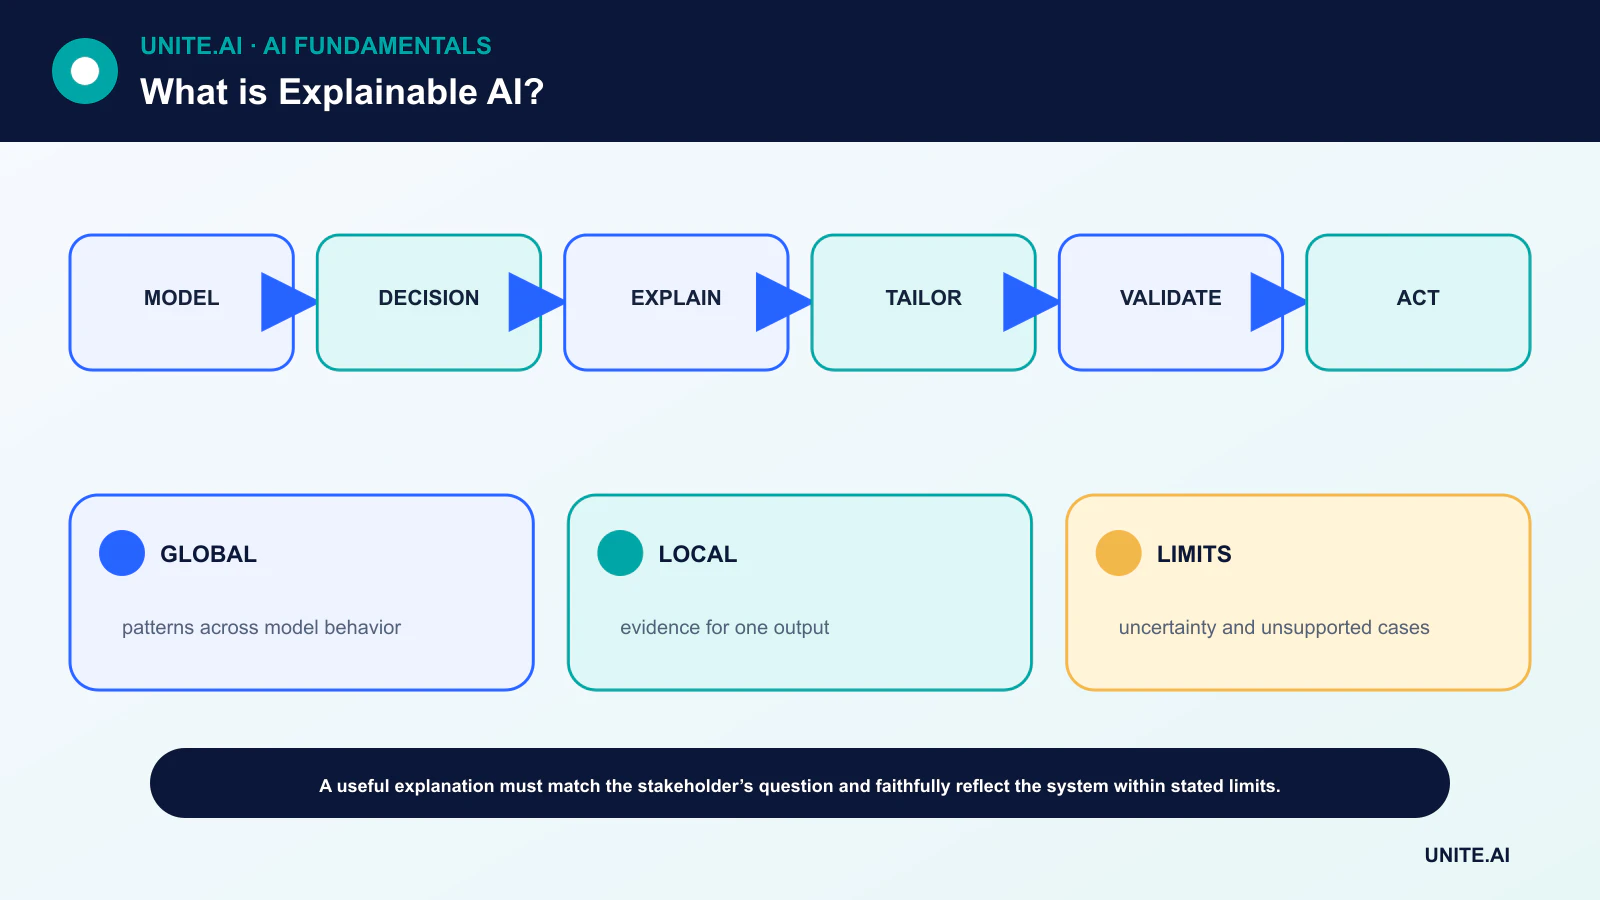
NIST пропонує, щоб система надавала пояснення, робила його зрозумілим для цільового користувача, забезпечувала точне відображення процесу системи та повідомляла про межі своїх знань. Ці принципи розрізняють наявність пояснення та його якість.
Значення залежить від аудиторії. Короткий код причини може допомогти заявнику, тоді як розробнику моделі можуть знадобитися розподіли, поведінка ознак та кластери помилок. Обидва повинні бути пов’язані з однією задокументованою системою та контекстом рішення.
Внутрішні та постхок методи
Розріджена лінійна модель або обмежене дерево рішень можуть бути безпосередньо інтерпретованими в межах їхньої дійсної області. Складну модель можна аналізувати за допомогою постхок атрибуції ознак, локального сурогату, прикладів, карт saliency або контрфактів.
Внутрішня простота не гарантує достовірність, коли ознаки погано визначені або конвеєр прихований. Складність постхок не обов’язково вводить в оману. Метод слід перевіряти щодо питання, на яке він має відповісти.
Атрибуція ознак та корельовані вхідні дані
Методи атрибуції розподіляють частини виходу між вхідними ознаками за явних припущень. LIME підбирає простий локальний сурогат навколо передбачення; методи, пов’язані з SHAP, пов’язують адитивні атрибуції з концепцією значень Шеплі.
Корельовані ознаки можуть ділитися або обмінюватися атрибуцією, і висока атрибуція не означає причинний ефект. Зміна ознаки в ізоляції може створити неможливу особу, зображення або транзакцію. Пояснення повинні вказувати базову лінію, методи вибірки та припущення про залежність.
Контрфакти, приклади та глобальна поведінка
Контрфакт запитує, яку здійснену зміну можна внести, щоб змінити результат. Обмеження є суттєвими: практичне пояснення не повинно рекомендувати незмінні, незаконні або нереалістичні зміни. Методи, засновані на прикладах, показують прототипи або впливові навчальні випадки, але можуть розкривати приватні дані.
Глобальний аналіз досліджує продуктивність, часткову залежність, монотонність, взаємодії та поведінку підгруп. Для ансамблів, таких як gradient boosting, поєднуйте підсумки з локальними доказами та прямими тестами очікуваних обмежень.
Перевірка пояснення та системи
Перевіряйте достовірність, стабільність при незначних збуреннях, послідовність між еквівалентними вхідними даними, розуміння користувачем та чи підтримує пояснення відповідне рішення. Адаптивні тести мають перевіряти, чи переконливе пояснення може супроводжувати неправильний або змінений вихід.
XAI входить до ширшої оцінки: якість на відкладеній вибірці, калібрування, справедливість, приватність, безпека, моніторинг та механізми оскарження. Пояснення може підтримувати підзвітність, але не може замінити відповідне управління.
Цілі пояснень та сімейства методів
Explainable AI має починатися з питання та аудиторії: чому виникло певне рішення, як модель загалом поводиться, які докази вплинули на неї, що змінить результат, чи дотримано політику. Локальні пояснення стосуються одного передбачення; глобальні пояснення підсумовують ширшу поведінку. Внутрішньо інтерпретовані моделі відкривають коефіцієнти, правила або структури, тоді як постхок методи апроксимують складні моделі. Пояснення поведінки моделі не є автоматично причинним поясненням світу чи обґрунтуванням справедливості рішення.
Методи атрибуції ознак включають градієнти, інтегровані градієнти, значення у стилі SHAP, перестановку та локальні сурогатні моделі. Пояснення, засновані на прикладах, отримують впливові або схожі випадки; контрфакти пропонують зміни, пов’язані з іншим виходом; концептуальні методи пов’язують внутрішні представлення з людськими категоріями. Кожен має припущення щодо базових ліній, незалежності ознак, локальної лінійності або доступу до моделі. Корельовані змінні, взаємодії та попередня обробка можуть робити атрибуції нестабільними або вводити в оману. Порівнюйте методи та змінюйте вхідні дані, щоб перевірити, чи передбачає пояснення поведінку.
Оцінка та людські фактори
Оцінюйте достовірність — чи відповідає пояснення моделі — окремо від правдоподібності для людини. Перевіряйте стабільність, чутливість, повноту, розрідженість та корисність для визначеного завдання, такого як налагодження або оскарження. Дослідження з людьми потребують репрезентативних учасників і мають вимірювати якість рішення, виявлення помилок, залежність та час, а не те, чи користувачі вважають графік зрозумілим. Переконливе пояснення може підвищити довіру до помилкової моделі, тому інтерфейси повинні показувати невизначеність, альтернативи та обмеження.
Контрфакти мають бути здійсненними, практичними та не рекомендувати зміну захищених або незмінних характеристик. Пояснення можуть розкривати інформацію про модель або особисті дані та допомагати зловмисникам розбирати рішення. Застосовуйте контроль доступу та мінімізацію виводу. Для регульованих або високовпливових застосувань зберігайте походження даних, версію моделі, поріг та фактичну логіку рішення; загальна графіка важливості ознак не може замінити юридично значущий підхід або людський перегляд.
Відповідальне використання пояснень
Вибирайте найпростішу модель, яка задовольняє вимоги до продуктивності та експлуатації, але не жертвуйте достовірністю заради поверхневої інтерпретованості. Поєднуйте пояснення з тестуванням підгруп, перевірками стійкості, причинним аналізом, коли це доречно, та моніторингом результатів. Документуйте цільову аудиторію та недійсні висновки. Якщо пояснення змінюється після безпечного збурення, розслідуйте це перед впровадженням. Пояснюваність — це доказ про систему за певним методом; вона корисна для налагодження, контролю та комунікації, проте не підтверджує правдивість, справедливість, безпеку чи розуміння.
Практичний приклад: пояснення моделі кредитного ризику
Кредитор спочатку визначає аудиторію та необхідну причину: заявникам потрібні точні фактори рішення та шлях виправлення, тоді як розробникам потрібна діагностика. Калібрований інтерпретований базовий варіант порівнюється з підвищеною моделлю. Локальні атрибуції, контрфакти та глобальний аналіз помилок тестуються на достовірність, стабільність, поведінку корельованих ознак та корисність. Пояснення не можуть рекомендувати зміну віку, інвалідності чи іншої незмінної характеристики і не подаються як причинні ефекти.
Запис виробничого рішення зберігає вихідні дані, трансформацію ознак, модель, поріг, політику та людську дію. Заявники можуть оскаржити неправильні дані та отримати змістовний перегляд. Моніторинг перевіряє стабільність результату та пояснення серед груп та оновлень моделі. Якщо правдоподібне пояснення змінюється при безпечному збуренні ознаки або пропускає вирішальне правило політики, розгортання зупиняється. Пояснюваність доповнює валідацію та процедурні права; вона не виправдовує недійсний ціль, дискримінаційні результати чи відсутність підзвітної людської влади.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, експлуатаційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Створіть відтворювану базу та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджений або відсутній вхід, зсув розподілу, відмову залежності, неправильне використання та групи або середовища, які, ймовірно, залишаться без належної підтримки. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, приватністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно інжектованих збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські переваги та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після впровадження, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часті запитання
Чи є карти уваги поясненнями?
Вони можуть бути діагностичними сигналами, проте ваги уваги самі по собі не гарантують достовірне відображення причин виходу моделі.
Чи вимагає Explainable AI просту модель?
Не завжди. Складні моделі можна аналізувати за допомогою постхок методів, проте такі пояснення потребують незалежної валідації та чітко зазначених обмежень.
Основні джерела












