Основи ШІ
Що таке матриця плутанини?

 Додайте Unite.AI до бажаних джерел у Google
Матриця плутанини — це таблиця, що підраховує, як часто прогнози класифікатора збігаються або розходяться з відомими мітками. Вона показує, які класи плутаються, і надає кількості, які використовуються для обчислення метрик, таких як точність, повнота, специфічність та F1. Це один із ключових діагностичних інструментів для контрольованого навчання задач класифікації.
Саму матрицю не слід розглядати як єдиний показник ефективності. Вона є структурованим представленням результатів при певному порозі рішення, наборі даних та визначенні класу.
Основні висновки
- Для бінарної класифікації чотири результати — це істинно‑позитивний, хибно‑позитивний, хибно‑негативний та істинно‑негативний.
- Завжди підписуйте осі: бібліотеки та публікації не завжди розташовують реальні та передбачені класи в однаковій орієнтації.
- Точність може приховувати серйозні помилки, коли класи незбалансовані.
- Зміна порогу класифікації змінює матрицю плутанини та компроміс між точністю та повнотою.
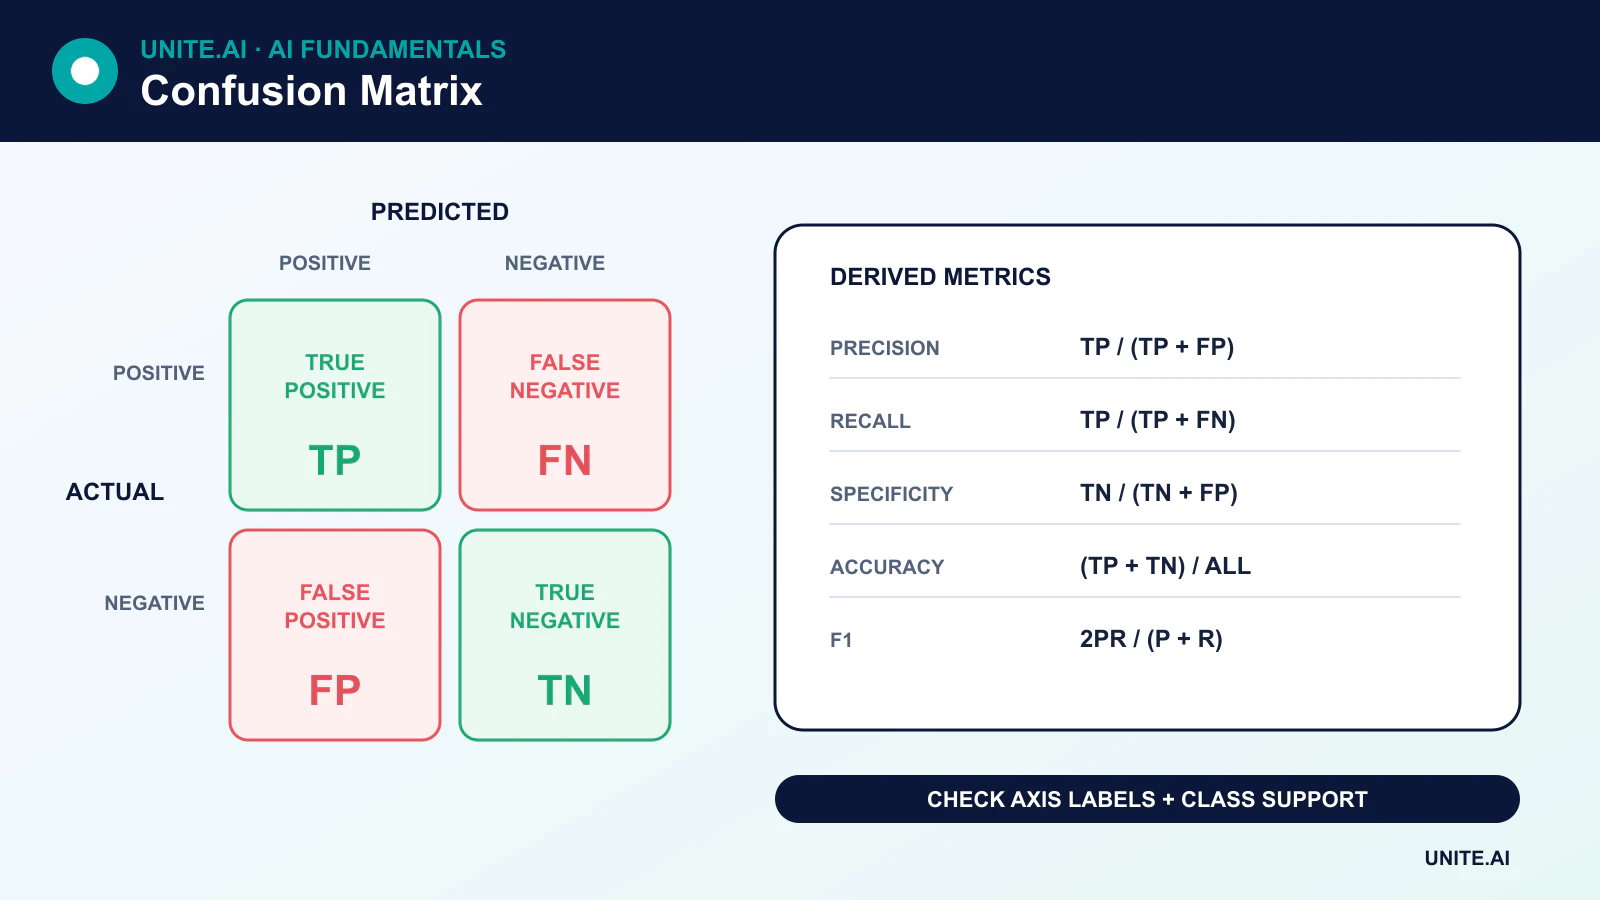
Чотири результати бінарної класифікації
- Істинно‑позитивний (TP): приклад є позитивним, і модель передбачає позитив.
- Хибно‑позитивний (FP): приклад є негативним, але модель передбачає позитив.
- Хибно‑негативний (FN): приклад є позитивним, але модель передбачає негатив.
- Істинно‑негативний (TN): приклад є негативним, і модель передбачає негатив.
У конвенції scikit-learn рядки відповідають справжнім класам, а стовпці — передбаченим. Інші візуалізації можуть транспонувати цей порядок, тому слід орієнтуватися на підписи, а не на положення кутових клітинок.
Метрики, отримані з матриці плутанини
Точність
Precision = TP / (TP + FP)
Точність відповідає на питання: серед передбачених позитивних прикладів, яка частка була дійсно позитивною?
Повнота або чутливість
Recall = TP / (TP + FN)
Повнота відповідає на питання: серед усіх фактичних позитивних прикладів, яку частку модель виявила? У бінарній класифікації повнота позитивного класу також називається чутливістю або рівнем істинно‑позитивних.
Специфічність
Specificity = TN / (TN + FP)
Специфічність — це повнота для негативного класу: серед фактичних негативних прикладів, яку частку модель правильно відхилила?
Точність (accuracy)
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Точність корисна, коли класи та витрати помилок приблизно збалансовані. Вона може вводити в оману, коли один клас домінує.
Оцінка F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Оцінка F1 узагальнює точність і повноту за допомогою гармонійного середнього. Вона ігнорує істинно‑негативні результати, тому не підходить як підсумок для будь‑якої задачі.
Практичний приклад
Припустимо, тестовий набір містить 1 000 транзакцій. П’ятдесят з них шахрайські. Модель виявляє 40 таких шахрайств, але помилково позначає 30 легітимних транзакцій:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Модель має 96 % точності, але її точність становить близько 57 %, а повнота — 80 %. Висока точність зумовлена великою кількістю легітимних транзакцій. Чи прийнятна така модель, залежить від вартості пропущеного шахрайства, можливостей розслідування та того, наскільки добре відкалібровані її ризикові оцінки.
Пороги змінюють матрицю
Багато класифікаторів виводять оцінку замість однозначної відповіді «так/ні». Зниження позитивного порогу, як правило, підвищує повноту і кількість хибнопозитивних результатів; підвищення порогу підвищує точність або специфічність, одночасно пропускаючи більше позитивних випадків. Поріг слід обирати, використовуючи валідаційні дані та реальні витрати помилок, а не фіксуючи його автоматично на 0,5.
Криві точність‑повнота та ROC узагальнюють ефективність при різних порогах. Криві точність‑повнота часто інформативніші, коли позитивний клас є рідкісним.
Матриці плутанини для багатокласової задачі
Для K класів матриця має розмір K × K. Правильні передбачення розташовані на діагоналі; поза‑діагональні клітинки показують, які пари класів плутаються. Метрики за окремими класами можна усереднювати різними способами:
- Макро‑середнє: надає кожному класу рівну вагу.
- Зважене середнє: зважує кожен клас за кількістю його прикладів.
- Мікро‑середнє: агрегує кількості результатів перед обчисленням метрики.
Повідомлення лише одного середнього може приховувати погану продуктивність на малих класах. Необхідно включати кількість підтримки та результати за кожним класом, коли різниця має значення.
Типові помилки
- Читання транспонованої матриці без перевірки підписів осей.
- Обчислення метрик за даними навчання замість відповідного відкладеного набору.
- Ігнорування поширеності класів, стратегії вибірки або дублювання об’єктів між розподілами.
- Порівняння матриць, створених при різних порогах, без зазначення зміни.
- Розгляд усіх хибнопозитивних та хибнонегативних результатів як однаково витратних.
Отже, матриця плутанини — це діагностичний інструмент, а не повна оцінка. Калібрування, аналіз підгруп, стійкість та наслідки downstream також мають бути враховані у огляді класифікації.
Читання кожної клітини та отримання корисних метрик
Для бінарної класифікації матриця плутанини підраховує істинно‑позитивні, хибнопозитивні, хибнонегативні та істинно‑негативні результати для вибраного позитивного класу та порогу. Точність ділить правильні передбачення на всі випадки; точність (precision) запитує, яку частку передбачених позитивних було правильних; повнота (recall) запитує, яку частку фактичних позитивних знайдено; специфічність вимірює, яку частку фактичних негативних правильно відхилено. F1 — це гармонійне середнє точності та повноти. Жодна з них не є універсально кращою: у виявленні шахрайства, медичній триажі та фільтрації спаму різні наслідки при однакових клітинках.
Для багатокласових задач рядки зазвичай представляють фактичні класи, а стовпці — передбачені, хоча конвенції різняться, тому підписи мають бути чіткими. Підрахунок «один проти решти» дає точність і повноту за кожним класом. Макро‑усереднення зважує класи порівну; мікро‑усереднення агрегує рішення та віддає перевагу поширеним класам; зважене усереднення враховує підтримку класу. У багатоміткових задачах дозволено кілька міток на елемент і потрібні визначення за міткою або за зразком. Нормалізація за рядком дозволяє дослідити патерни повноти, за стовпцем — склад передбачень, проте слід зберігати сирі підрахунки, щоб рідкі групи не були візуально перебільшені.
Пороги, невизначеність та операційні рішення
Матриця плутанини підсумовує жорсткі рішення при одному порозі. Використовуйте криві точність‑повнота або ROC для порівняння порогів, а потім оберіть операційну точку, орієнтуючись на пропускну здатність, поширеність та вартість помилок. Калібрування запитує, чи відповідають передбачені ймовірності спостережуваній частоті, і є окремим від ранжирування. При зміні поширеності точність може змінитися, навіть якщо чутливість і специфічність залишаються стабільними. Подавайте інтервали довіри або варіації бутстрепу і уникайте висновків на підставі кількох помилок у малій підгрупі.
Аудитуйте матриці за часом, місцем, пристроєм, мовою та релевантними групами, щоб виявити сконцентровані помилки. Порівнюйте модель із існуючим процесом прийняття рішень, включаючи людський перегляд. Для каскадів реєструйте помилки на кожному етапі: пошук, класифікація, порогування та дія. Моніторьте живі мітки результатів разом із затримкою та процесом виправлення. Здавалося б, покращений F1 може все ж збільшити шкідливі хибнонегативні випадки або перевищити можливості перегляду. Матриця плутанини — це реєстр рішень; пов’язуйте кожну клітинку з тим, хто зазнав помилки, і з реакцією, що слідує.
Практичний приклад: вибір порогу медичного скринінгу
Модель скринінгу машинного навчання виводить ризикову оцінку для стану з низькою поширеністю. Команда створює матриці плутанини при різних порогах і повідомляє чутливість, специфічність, точність, кількість хибних направлень та пропущених випадків з інтервалами довіри. Оскільки позитивна прогностична цінність залежить від поширеності, модель орієнтується на цільову популяцію, а не цитує точність лише одного набору даних. Результати сегментуються за пристроєм, локацією, віком, статтю та іншими клінічно обґрунтованими групами.
Клініцисти обирають операційну точку, яка зберігає необхідну чутливість без перевантаження підтверджувальними тестами. Матрицю переводять у очікувані підрахунки на 10 000 скринінгованих людей, щоб наслідки були зрозумілі. Оцінки поза валідаційними умовами не генерують автоматичний висновок. Моніторинг порівнює передбачення з відкладеними підтвердженими діагнозами, відстежує пропускну здатність і калібрування, і ініціює перегляд при зміні поширеності чи способу збору даних. Матриця плутанини залишається прив’язаною до конкретної моделі, порогу та популяції.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більшого, ніж успішна демонстрація. Визначте цільових користувачів, експлуатаційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої помилки. Встановіть відтворювану базу та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені чи відсутні вхідні дані, зсув розподілу, відмову залежностей, неправильне використання та групи чи середовища, які можуть залишитися без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапне розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно внесених збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку вихідних результатів, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих чутливих даних. Визначте пороги сповіщень та відповідального, а потім переглядайте реальні докази після розгортання, а не припускайте, що офлайн‑ефективність залишиться стабільною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часті запитання
Що таке нормалізована матриця плутанини?
Нормалізація ділить підрахунки на загальну кількість у справжньому класі, у передбаченому класі або на всі спостереження. Це спрощує порівняння швидкостей між класами, проте звіт має також зберігати сирі підрахунки підтримки, щоб малі групи не сприймалися як однаково великі.
Чи може матриця плутанини оцінювати регресію?
Не безпосередньо. Матриця плутанини вимагає дискретних класів. Бінування безперервної цілісної змінної втрачає інформацію; для регресії зазвичай використовують аналіз залишків та метрики, розроблені для безперервних значень, такі як MAE або RMSE.
Основні джерела