
Основи ШІ
Що таке аналіз настроїв? Методи, використання та обмеження

 Додайте Unite.AI до бажаних джерел у Google
Аналіз настроїв оцінює оцінювальну мову в тексті, транскриптах мовлення чи іншому контенті. Система може класифікувати полярність, наприклад позитивну, негативну або нейтральну; виявляти думки на рівні аспектів; оцінювати інтенсивність; або визначати позицію щодо конкретного твердження.
Ціль потрібно визначати ретельно. Настрій не тотожний емоції, наміру, токсичності, задоволенню чи істині. Позитивне речення може саркастично описувати шкідливу подію, тоді як негативний відгук про продукт може загалом його рекомендувати.
Основні висновки
- Визначте одиницю, ціль, мітки та контекст перед збором прикладів.
- Лексикони — прозорі базові моделі; контрольовані та трансформер‑моделі можуть захоплювати більше контексту, але потребують репрезентативних даних.
- Заперечення, сарказм, доменна лексика, багатомовний текст та межі аспектів залишаються складними.
- Оцінюйте за класом, підгрупою, доменом та часовим періодом; включайте людський перегляд для важливих застосувань.
Рівні та цілі
Аналіз на рівні документа генерує одну мітку для всього елементу. Аналіз на рівні речення розділяє висловлювання, а аналіз на рівні аспектів пов’язує настрій з сутністю або атрибутом — наприклад, позитивний щодо якості зображення, але негативний щодо тривалості роботи батареї.
Позиція визначає, чи підтримує мовник конкретну пропозицію, що може відрізнятись від емоційного тону. Ці розрізнення слід зафіксувати в інструкції з анотування перед застосуванням методів класифікації тексту.
Лексикони, класичні моделі та трансформери
Лексикон присвоює словам оцінки і поєднує їх з правилами для заперечень або інтенсивності. Він інтерпретований і недорогий, але має труднощі з контекстом. Класичні контрольовані моделі використовують ознаки слів або n‑грам, тоді як трансформери навчаються контекстуальним представленням і їх можна донастроювати.
Підказка з малим числом прикладів може бути зручною, проте результати залежать від прикладів і формулювання. Порівнюйте кожен складний підхід з базовою моделлю і використовуйте навчання з малим числом прикладів лише з відкладеним, версіонованим набором для оцінки.
Проблеми даних та мови
Мітки можуть відображати перспективу анотатора, а не об’єктивний факт. Зміна домену може бути суттєвою: «непередбачуваний» може бути похвалою щодо фільму і критикою щодо автомобіля. Перемикання коду, діалекти, емодзі, цитовані висловлювання та іронія ускладнюють сигнали на рівні токенів.
Навмисно балансувати класи і запобігати витоку пов’язаних авторів, продуктів чи розмов між навчальним і тестовим набором. Модель, яка запам’ятовує бренд або мовника, може виглядати точною, не навчившись розпізнавати настрій.
Оцінка та відповідальне використання
Повідомляйте точність (precision), повноту (recall), F1 та матрицю плутанини замість лише точності (accuracy). Переглядайте помилки за аспектом, довжиною, діалектом та часом і калібруйте пороги відповідно до операційних витрат кожної помилки.
Агреговані тенденції можуть підтримувати дослідження або триаж, проте виведення стану окремої особи чи прийняття рішень щодо працевлаштування, кредиту, здоров’я чи поліції створює більший ризик. Забезпечуйте оцінку невизначеності, контекст джерела, контроль за конфіденційністю та людський перегляд.
Анотація та створення набору даних
Складіть інструкцію з анотування, включаючи цільову сутність, одиницю аналізу, визначення міток, обробку змішаних та нейтральних випадків, правила цитування, політику щодо сарказму та приклади з домену. Проведіть пілот з кількома анотаторами, розрахуйте згоду, обговоріть розбіжності та перегляньте завдання перед масштабуванням міток.
Відбір визначає, чого навчається модель. Потік соціальних мереж може переважає активних акаунтів; запити підтримки можуть не включати задоволених клієнтів; оцінки у зірках можуть не відповідати тексту відгуку. Зберігайте метадані джерела та часу, дотримуйтесь умов платформи та конфіденційності, і створюйте тестовий набір з популяції, де будуть прийматися рішення.
Витік міток може відбуватись через оцінки, емодзі, вставлені системою збору, шаблонні підписи або назви продуктів, що корелюють з настроєм. Видаляйте майже ідентичні пости та групуйте розмови або авторів, щоб їхня мова не з’являлась з обох боків розподілу.
Вибір моделі та калібрування
Системи на основі лексикону підсумовують оцінки слів і коригують їх з урахуванням заперечень, підсилювачів, пунктуації чи емодзі. Вони слугують корисною перевіркою розумності та можуть бути адаптовані під доменні терміни. Лінійні моделі з ознаками TF–IDF залишаються конкурентоспроможними на деяких наборах даних і виявляють впливові n‑грами.
Контекстуальні енкодери представляють слова згідно з оточуючим текстом і їх можна донастроювати під полярність або аспекти. Довгі документи можуть вимагати ієрархічних моделей, агрегування речень або пошуку релевантних фрагментів. Багатомовні підходи можуть навчати одну спільну модель, перекладати в проміжну мову або підтримувати локальні моделі; кожен варіант має свої переваги щодо охоплення та культурних особливостей.
Калібрування ймовірності важливе, коли оцінки ініціюють дії. Графіки надійності та очікувана помилка калібрування показують, чи відповідає заявлена впевненість 0,8 приблизно 80 % правильності. Пороги можуть створювати діапазон відмови для людського перегляду, а окремі пороги можуть бути виправдані, коли вартість помилок різна — не для приховування нерівної якості.
Застосування та типові неправильні тлумачення
Агрегований настрій може допомогти пріоритизувати теми, порівнювати реакції на кампанії або направляти термінові повідомлення сервісу. Аналіз аспектів часто більш практичний, ніж загальна полярність, оскільки він виявляє, про що говорять люди. Аналіз тенденцій потребує стабільного відбору та визначень міток протягом часу.
Не рівняйте поширеність негативних дописів з думкою населення. Поведінка публікацій, боти, модерація, демографія платформи, кампанії та запити збору формують вибірку. Модель настроїв не вимірює мовчазну частину населення, і зміна формулювання може виглядати як зміна ставлення.
Для індивідуальних рішень хибні мітки можуть стигматизувати і бути важкими для оскарження. Уникайте використання настрою як замінника залученості працівників, психічного здоров’я, кредитоспроможності, наміру чи обману. Коли це стосується людей, покажіть контекст джерела, дозвольте виправлення та вимагайте участі людини‑рішальника з реальними повноваженнями.
Практичний приклад: аналіз настроїв у відгуках клієнтів
Компанія, яка аналізує коментарі підтримки, повинна визначити, чи потрібен їй настрій документа, настрій аспекту, емоція, терміновість або класифікація проблеми. «Доставка була швидкою, але продукт зламався» не може бути достовірно представлений однією позитивною чи негативною міткою. Створіть інструкцію з анотування для цілей, заперечень, сарказму, змішаних висловлювань, цитованих реплік та невідомих випадків, потім виміряйте згоду перед тим, як розглядати мітки як істинні.
Порівняйте лексикон або лінійну базову модель з донастроєним енкодером або підказувальною мовною моделлю. Розділіть дані за часом або клієнтом, щоб запобігти витоку майже дубльованих записів, і зберігайте частотність класів. Повідомляйте точність, повноту, F1, калібрування та матрицю плутанини за мовою, каналом, продуктом та демографічними проксі лише там, де це законно та виправдано. Переглядайте помилки з високою впевненістю, оскільки вони більш небезпечні в автоматичному маршрутуванні, ніж невизначені результати, які ескалюються.
Використовуйте настрій як один сигнал для агрегування чи пріоритезації, а не як беззаперечну міру стану особи. Слідкуйте за змінами словника та продукту, переобучайте модель на переглянутих прикладах і дозволяйте агентам виправляти мітки. Ніколи не виводьте захищені ознаки або не карайте працівників на підставі неперевірених оцінок настрою. Для звітності керівництву показуйте розмір вибірки, невизначеність, відсутні дані та теми, що викликають зміни, щоб коливання оцінки призводило до розслідування, а не до спрощеного висновку.
Багатомовне впровадження не повинно припускати, що переклад вхідних даних зберігає тон, заперечення, ідіому або культурну конвенцію. Перевіряйте кожну підтримувану мову та змішані мовні патерни за допомогою носіїв мови, і надавайте результат «невідомо», коли доказова база слабка. Адаптація до домену також важлива: слова, які звучать негативно в повсякденній розмові, можуть бути нейтральними технічними описами. Підтримуйте окремі пороги або моделі лише тоді, коли операційні дані виправдовують додаткову складність та навантаження на управління.
Практичний чек‑лист впровадження
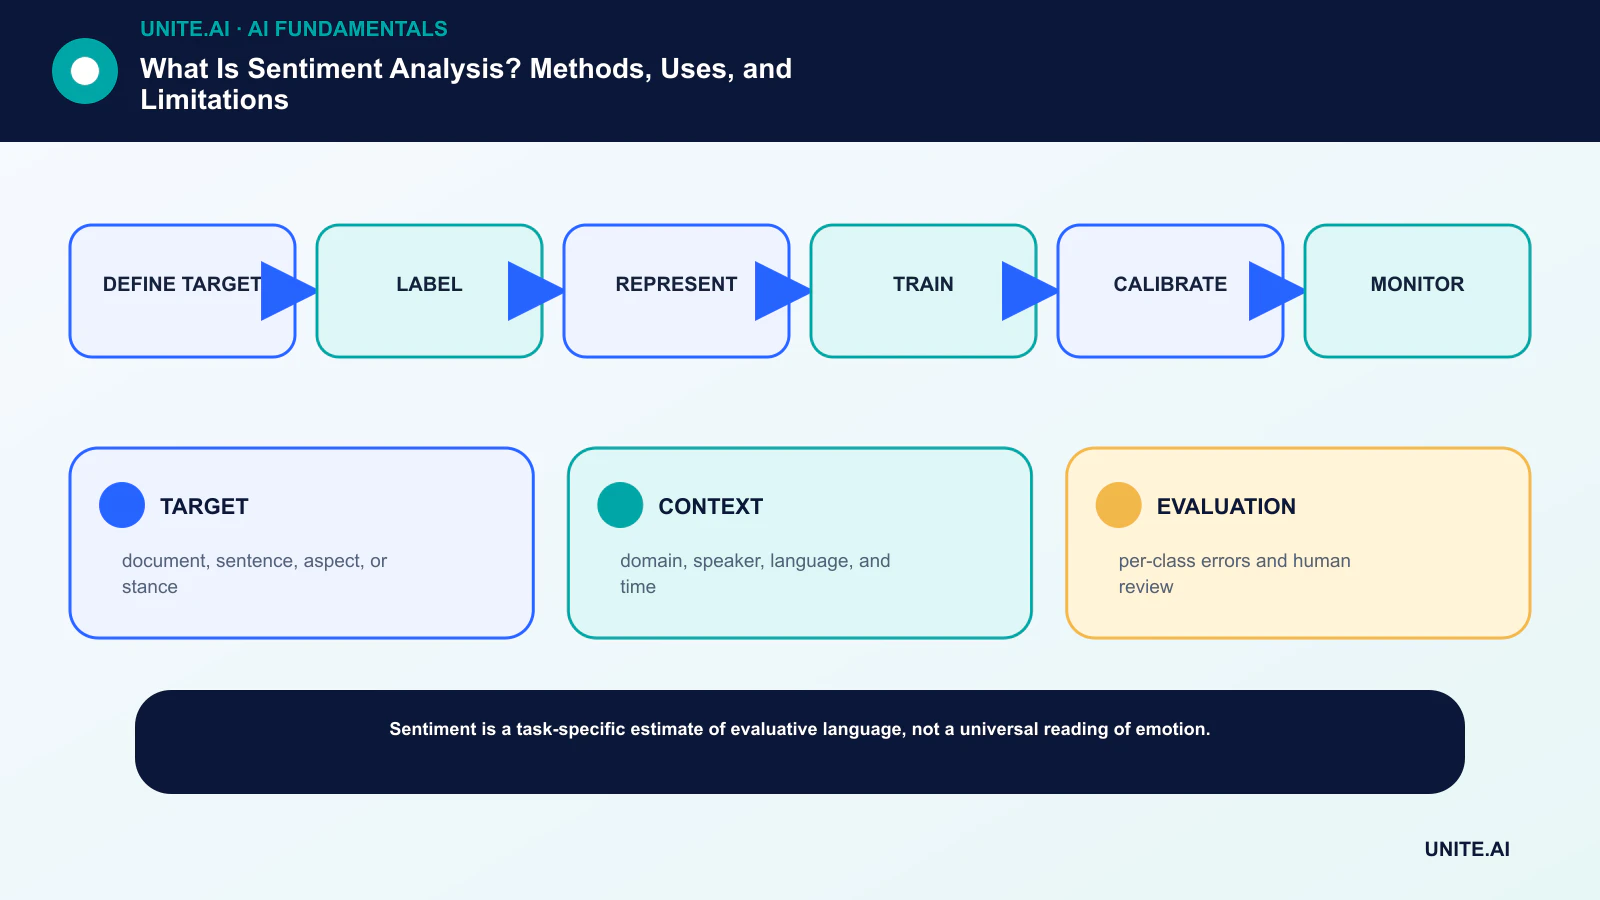
Перетворіть концепцію у обмежений, тестований робочий процес: визначте ціль → мітку → представлення → навчання → калібрування → моніторинг. Призначте відповідального, задокументуйте дані та залежності, встановіть просту базову модель, визначте критерії прийняття та зупинки, протестуйте репрезентативні відмови та визначте моніторинг, відкат і перегляд перед розширенням охоплення. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності за участю людей, які будують, експлуатують, захищають та постраждають від системи. Тестуйте звичайні випадки, граничні умови, відмови залежностей та зловживання; зберігайте докази та невирішені ризики. Визначте, хто може затвердити випуск, змінити поріг, перевизначити вихід або зупинити роботу. Перегляньте рішення після надходження реальних даних, оскільки технічно успішний пілот не гарантує надійної роботи у масштабі.
- МЕТА: документ, речення, аспект або позиція.
- КОНТЕКСТ: домен, мовник, мова та час.
- ОЦІНКА: помилки за класом та людський перегляд.
Поширені запитання
Чи є аналіз настроїв об’єктивним?
Ні. Він оцінює мітки, визначені завданням та процесом анотування. Деякі тексти дійсно неоднозначні, змішані, залежать від контексту або інтерпретуються різними читачами.
Чи може аналіз настроїв виявляти сарказм?
Моделі можуть вивчати деякі патерни, проте сарказм часто залежить від історії мовника, спільних знань та контексту поза текстом. Це залишається поширеним режимом відмови.
Основні джерела












