
Основи ШІ
Як працює класифікація тексту?

 Додайте Unite.AI до бажаних джерел у Google
Класифікація тексту присвоює один або кілька міток документу, повідомленню чи фрагменту тексту. Прикладами є виявлення спаму, маршрутизація намірів, аналіз настроїв, тегування тем, модерація та пріоритизація заявок підтримки.
Виробничий класифікатор — це більше, ніж модель. Він залежить від точної таксономії міток, репрезентативних анотацій, розподілів без витоків, каліброваного правила прийняття рішень та моніторингу зміни мови та поширеності класів.
Ключові висновки
- Визначте мітки та неоднозначні випадки перед вибором архітектури.
- Прості базові моделі «мішок слів» залишаються цінними; попередньо навчені кодувальники додають контекст і перенесення навчання.
- Точність може приховувати низьку якість класів меншини, тому використовуйте метрики, орієнтовані на класи, та аналіз помилок.
- Калібрування ймовірностей, відмова та людський перегляд перетворюють оцінки у більш безпечні рішення.
Визначення таксономії та політики анотації
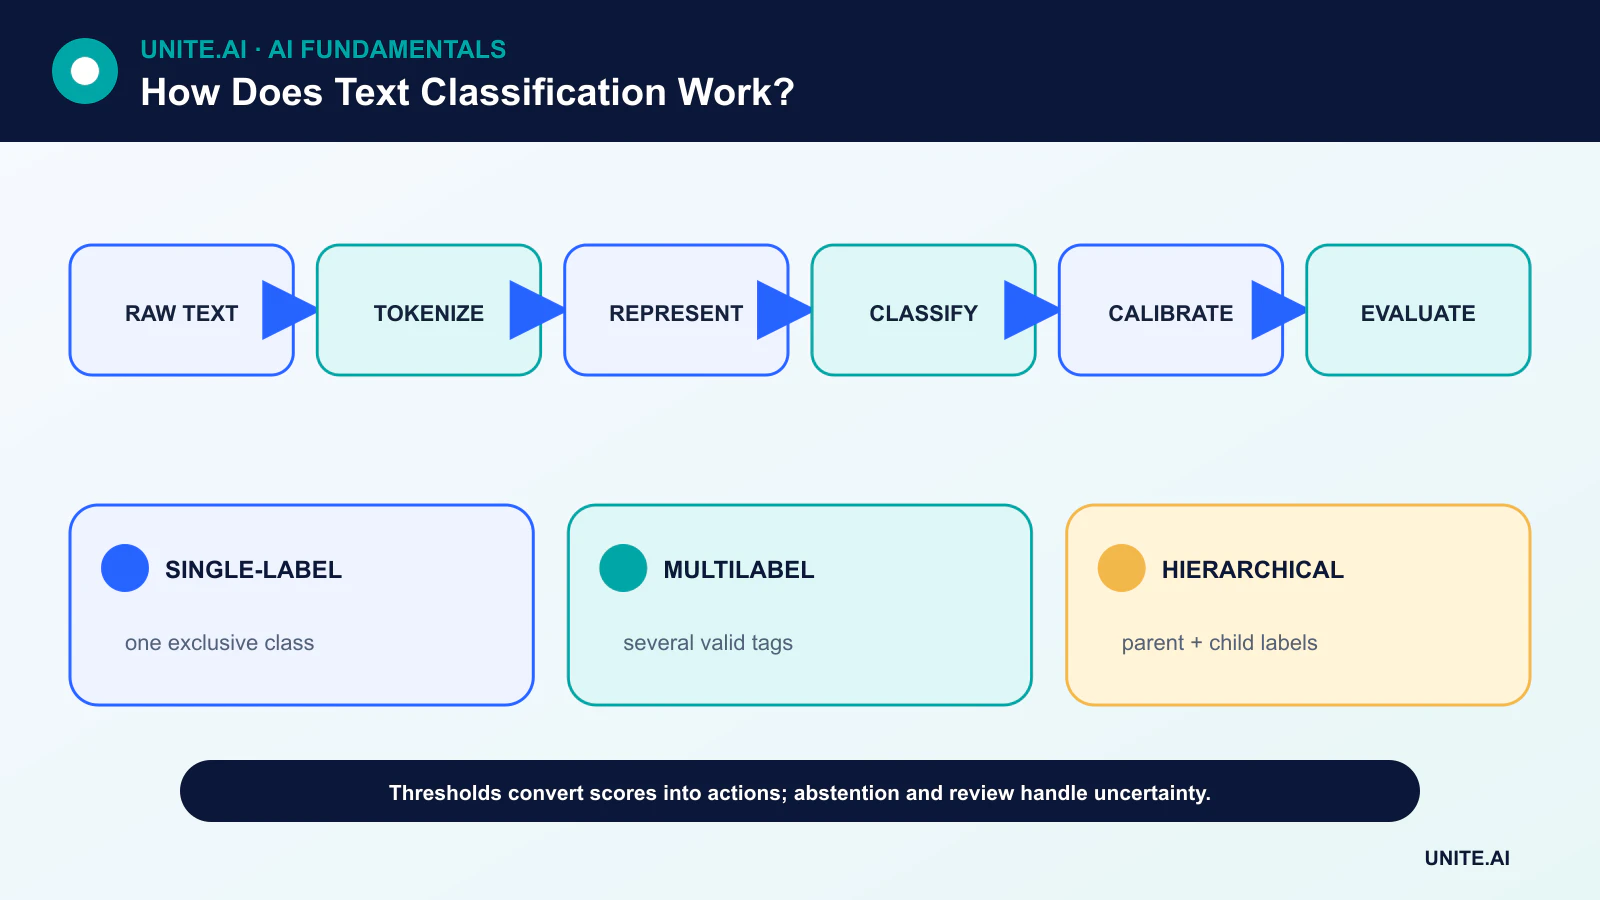
Завдання з однією міткою вибирає один взаємовиключний клас. Завдання з кількома мітками може присвоювати кілька незалежних тегів. Ієрархічні таксономії містять батьківські та дочірні мітки. Це різні навчальні проблеми, які вимагають різних виходів та метрик.
Анотаторам потрібні визначення, позитивні та негативні приклади, правила щодо відсутнього контексту та шлях ескалації. Статистика узгодженості може виявити неясне завдання, проте розбіжність також може відображати справжню неоднозначність, яку система повинна зберігати.
Представлення тексту
Традиційні конвеєри використовують підрахунок токенів, n‑грам та TF‑IDF з лінійними класифікаторами або support vector machines. Вони швидко навчаються, виявляють впливові терміни та забезпечують міцну базу.
Нейронні системи відображають токени у векторні представлення. Попередньо навчені трансформер‑кодувальники використовують увагу для створення контекстуальних представлень і можуть донавчатися на позначених прикладах. Класифікатори з підказками або zero‑shot можуть зменшити початкове маркування, проте їх формулювання міток, версія моделі та калібрування мають оцінюватися у конкретному домені.
Навчання без витоків
Набір даних розділяється на навчальну, валідаційну та фінальну тестову частини. Майже дубльовані документи, повідомлення з однієї розмови або шаблони з одного джерела повинні залишатися в одному розподілі. Для часово‑залежного використання хронологічний розподіл краще відображає розгортання.
Несбалансованість класів можна вирішити за допомогою зважування, ресемплінгу, вибору порогу або додаткових даних. Синтетичні приклади не повинні замінювати перегляд реальних помилок класу меншини і можуть вводити артефакти, які модель навчається занадто легко.
Метрики та калібровані рішення
confusion matrix показує, які мітки плутаються. Точність вимірює, скільки передбачених позитивних випадків правильні; повнота вимірює, скільки справжніх позитивних знайдено. Макро‑середні зважують класи рівно, тоді як мікро‑середні зважують окремі приклади.
Сира оцінка softmax не є автоматично достовірною ймовірністю. Калібрування порівнює впевненість з фактичною правильністю. Команди можуть встановлювати пороги для окремих класів, відмовлятися, коли впевненість низька, та перенаправляти чутливі випадки до ревізора.
Розгортання, багатомовне використання та дрейф
Текст змінюється разом з продуктами, подіями, сленгом та ворожою поведінкою. Моніторинг має відстежувати мову вводу, довжину, патерни поза словником, частоти класів, впевненість та затримані результати. Перенавчання вимагає даних з версіями та набору регресійних важливих прикладів.
Багатомовну продуктивність слід тестувати для кожної мови та діалекту. Переклад усього на одну мову може змінити настрій або сутності; багатомовний кодувальник все ж може працювати нерівномірно, оскільки його попереднє навчання та мітки не є однаково репрезентативними.
Представлення та сімейства класифікаторів
Класифікація тексту відображає документ, речення або послідовність токенів у одну або кілька міток. Визначте, чи мітки взаємовиключні, багатоміткові, ієрархічні, упорядковані чи відкриті. Традиційні конвеєри токенізують текст, створюють ознаки «мішок слів» або TF‑IDF та навчають логістичну регресію, наївний Байєс або лінійний SVM. Нейронні системи вивчають векторні представлення за допомогою згорток, рекурентних мереж або трансформерів. Моделі мови з підказками можуть класифікувати без спеціального навчання, проте обмеження виходу, вартість, дрейф та докази все ще потребують оцінки проти простіших базових моделей.
Попередня обробка залежить від представлення. Перетворення в нижній регістр або видалення пунктуації може знищити сигнали для імен, настроїв, коду чи мови; стеммінг може об’єднувати різні значення. Токенізатори трансформерів працюють із субсловами і мають обмеження довжини, тому стратегія обрізки має значення. Довгі документи можуть вимагати розбиття на частини та агрегації. Зберігайте сирий текст і версію трансформації, а також розділяйте за автором, розмовою, джерелом чи часом, щоб запобігти перетину майже дубльованих та повторюваних шаблонів між навчанням і тестом.
Мітки, метрики та аналіз помилок
Посібник з анотації має визначати область, приклади, неоднозначні випадки та опцію «невідомо» або відмова. Вимірюйте узгодженість і розглядайте розбіжності, а не приховуйте їх більшістним голосуванням. Для незбалансованих класів точність недостатня; повідомляйте точність, повноту, F1, матрицю плутанини, калібрування та навантаження за порогом для кожного класу. Багатоміткові завдання потребують мікро, макро та мітко‑орієнтованих метрик. Оцінюйте мови, діалекти, домени, довжину повідомлень та час. Випадковий розподіл може переоцінювати якість, коли словник або шаблони дрейфують.
Аналіз помилок має розділяти провал представлення, недостатній контекст, неоднозначність міток, рідкісну лексику, заперечення, сарказм та хибні підказки. Використовуйте контрфактичні тести, які змінюють імена, маркери діалекту або нерелевантні метадані, зберігаючи зміст. Перевіряйте помилки з високою впевненістю та відхилені випадки. Модель може навчитися, що канал клієнта або підпис передбачає мітку, а не інтерпретує вміст. Видаліть витоки та перегляньте дані перед простим збільшенням місткості моделі.
Проектування у виробництві
Надавайте фіксований токенізатор і модель з валідацією схеми, обмеженнями довжини, пакетною обробкою та резервним варіантом для непідтримуваної мови або низької впевненості. Моніторте розподіл вводу, частоти міток, калібрування, затримку та результати після перегляду. Захищайте текст, оскільки він може містити особисті, конфіденційні або ворожі інструкції. Для автоматичної модерації, допуску чи маршрутизації забезпечте можливість оскарження та вимірюйте різні помилки. Версіонуйте мітки та пороги згідно бізнес‑політики. Класифікація тексту є надійною лише в межах визначеної системи міток та розподілу даних; плавні пояснення моделі не доводять правильність класифікації.
Практичний приклад: класифікація вхідних запитів підтримки
Команда підтримки визначає взаємовиключні мітки маршрутизації, а також прапорці «терміново», «багатомовно» та «невідомо». Анотатори маркують анонімізовані повідомлення за рекомендаціями щодо змішаних проблем та вимірюють узгодженість. Базова модель TF‑IDF логістична, донавчений кодувальник та модель з підказкою використовують один і той же тестовий набір, сформований за часом. Оцінка включає точність та повноту класу, хибні негативи для термінових, калібрування, валідність схеми, затримку та вартість, при цьому майже дубльовані шаблони групуються, щоб уникнути витоків.
Розгорнутий класифікатор перевіряє мову та довжину, відмовляється при слабких доказах і дозволяє агентам коригувати маршрути. Підказки та повідомлення розглядаються як ненадійні; доступ до інструменту відсутній. Моніторинг відстежує поширеність міток, впевненість, виправлення, час відповіді та нові теми. Політика або зміна продукту оновлює таксономію та дані для перенавчання через перегляд. Система покращує розташування в черзі, проте вона ніколи не виводить емоції чи права клієнта поза межами підтверджених міток.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які найбільше залишаються без обслуговування. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною спроможністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний ревізор міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапне розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має розкривати якість вводу, поведінку виходу, версію моделі або правила, стан залежностей, людські переваги та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часті запитання
Чи є аналіз настроїв завданням класифікації тексту?
Зазвичай так, проте настрій може бути багатомітковим, орієнтованим на аспекти або безперервним, а не лише однією міткою позитивний/нейтральний/негативний.
Коли класифікатор тексту повинен відмовитися?
Коли впевненість низька, текст виходить за межі сфери, відсутній необхідний контекст або вартість неправильного автоматичного дії перевищує вартість перегляду.
Основні джерела












