
Основи ШІ
Що таке KNN (K-Nearest Neighbors)?

 Додайте Unite.AI до бажаних джерел у Google
K-nearest neighbors (KNN) передбачає результат на основі позначених навчальних прикладів, найближчих до запитуваної точки. Для класифікації сусіди голосують за клас. Для регресії їхні цільові значення усереднюються або комбінуються іншим способом.
KNN — це метод, заснований на конкретних прикладах, без узагальнення: під час навчання в основному зберігаються навчальні приклади та, за потреби, індекс пошуку. Це не усуває потребу у розподілі даних на навчальну, валідаційну та тестову вибірки. Оцінка на відкладених даних є необхідною для вибору k, метрики відстані, обробки ознак та правила голосування.
Основні висновки
- KNN передбачає локально; він не розбиває набір даних спочатку на кластери.
- Масштабування ознак є критичним, оскільки відстань визначає, які приклади вважаються сусідами.
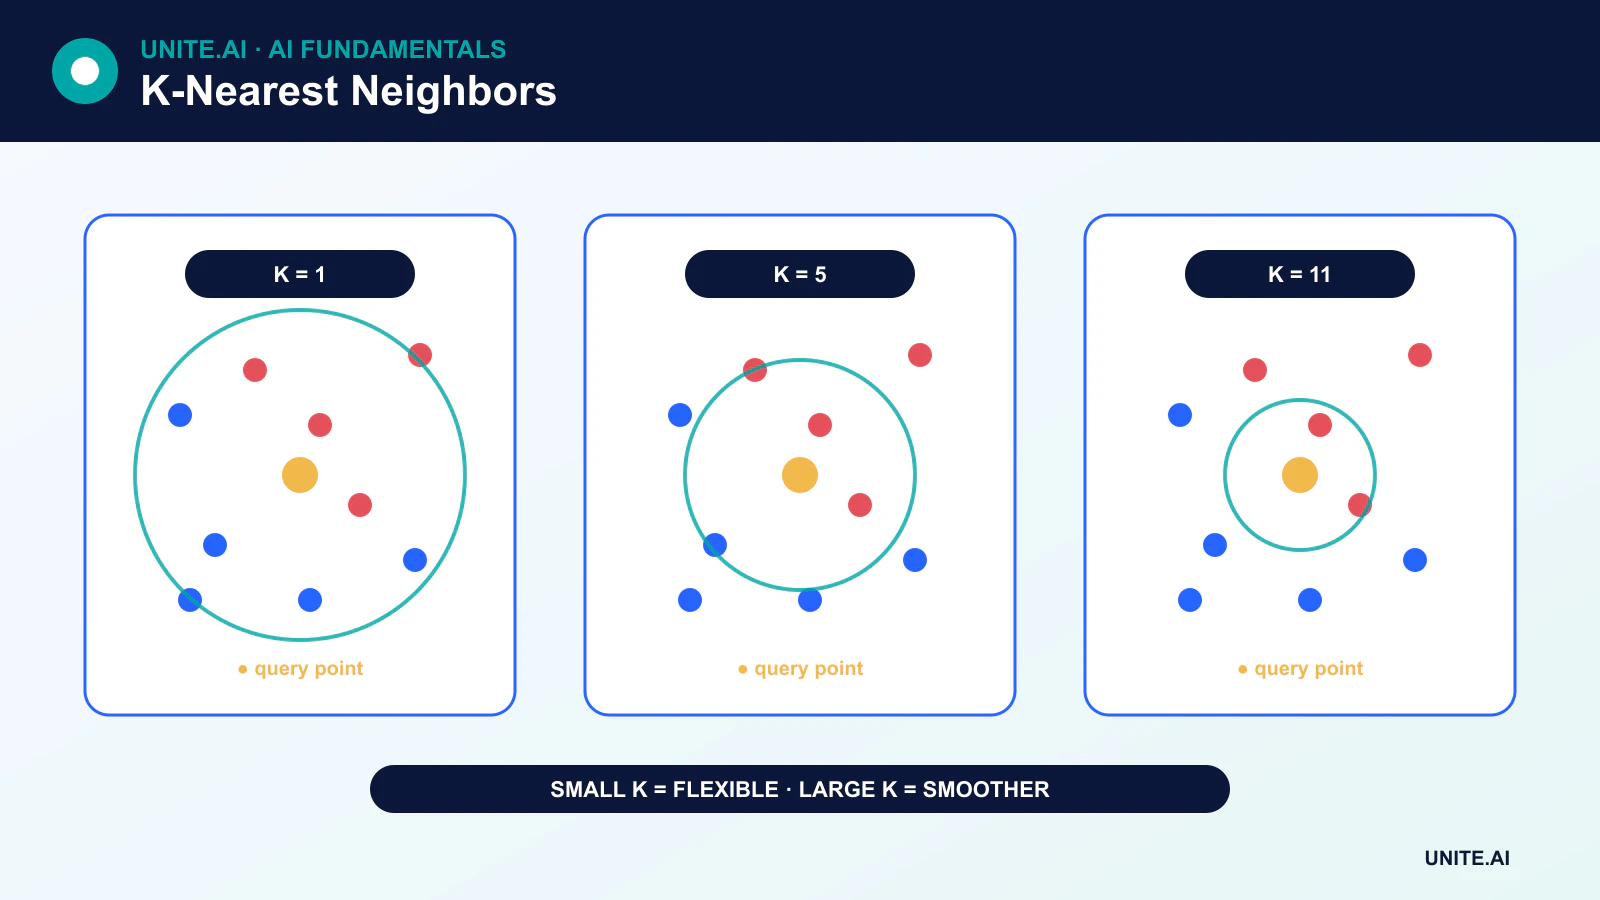
- Невелике k може бути шумним, тоді як велике k може згладжувати локальну структуру.
- Високі розмірності, нерелевантні ознаки, дисбаланс класів та повільний пошук можуть обмежувати продуктивність.
Як працює класифікація KNN
- Представити запит та навчальні приклади в одному просторі ознак.
- Обчислити відстань від запиту до навчальних прикладів.
- Вибрати k найближчих прикладів.
- Передбачити клас більшості або використати голосування з вагами за відстанню.
Голосування з вагами надає ближчим сусідам більший вплив. У випадку нічиїх необхідно мати задокументоване правило, а сусіди на однаковій відстані з різними мітками можуть робити результати залежними від порядку або деталей реалізації.
Регресія KNN
Для регресії передбачення зазвичай є середнім значенням цільових змінних сусідніх прикладів. Вагове врахування відстані може зменшити вплив більш віддалених спостережень. Медіана або стійка агрегація можуть бути корисними, коли локальні цілі містять викиди.
Метрики відстані
Євклідова відстань поширена для неперервних ознак, манхеттенська відстань підсумовує абсолютні різниці, а косинусна відстань орієнтується на напрямок, а не на величину. Інші метрики застосовуються до бінарних, категоріальних, географічних, послідовних або навчальних вбудовуваних даних.
Називати KNN «непараметричним» означає, що він не припускає фіксовану скінченновимірну функціональну форму межі рішення. Проте він передбачає, що обрана репрезентація та метрика роблять близькі точки релевантними одна до одної.
Чому важливе масштабування
Якщо одна ознака змінюється в діапазоні від 0 до 1, а інша — від 0 до 100 000, звичайна евклідова відстань буде домінувати за рахунок другої ознаки. Стандартизація, нормалізація або специфічні для домену перетворення мають бути підготовлені на навчальній частині та застосовані до валідаційних, тестових і виробничих даних.
Нерелевантні ознаки також спотворюють околиці. Вибір ознак, зменшення розмірності або навчені представлення можуть допомогти, проте кожен вибір має бути перевірений без витоку даних.
Вибір k
При k = 1 модель може слідувати шуму та помилково позначеним прикладам. З ростом k передбачення стають плавнішими і менш чутливими до окремих точок. Якщо k стає занадто великим, домінують віддалені класи або регіони, і модель недоадаптується.
Вибирайте k за допомогою крос‑валідації на навчальних даних. Для бінарної класифікації непарне k зменшує, але не усуває нічиї. Ваги класів, стратифіковані розподіли, вибір порогу та відповідні метрики важливі, коли класи дисбалансовані.
Прокляття високої розмірності
У просторах високої розмірності відстані можуть ставати менш інформативними, оскільки приклади розріджені, а найближчі та найдальші відстані стають відносно схожими. KNN може вимагати величезних обсягів даних, щоб підтримувати змістовні локальні околиці. Це називається прокляттям високої розмірності.
Зменшення розмірності або специфічні для завдання вбудовування можуть допомогти, проте геометрію вбудовування слід перевіряти щодо запланованого розуміння схожості.
Продуктивність пошуку
Запит з повним перебором порівнює нову точку з усіма збереженими прикладами. KD‑дерева та ball‑дерева прискорюють деякі точні пошуки, хоча їхня користь зменшується у високих розмірностях. Приблизні індекси найближчих сусідів міняють невеликий спад відгуку на значне підвищення швидкості та економії пам’яті. Ця ідея також лежить в основі векторного пошуку схожості.
Сильні та слабкі сторони
KNN простий, підтримує нерегулярні межі рішення та забезпечує інтуїтивне пояснення на основі прикладів. Однак він може вимагати значної пам’яті, розкривати чутливі навчальні приклади, передбачати повільно та погано працювати, коли відстань не має сенсу. Це корисна базова модель — не метод, який за замовчуванням забезпечує високу точність у більшості задач.
Відстані, околиці та поведінка гіперпараметрів
K‑nearest neighbors зберігає навчальні приклади та передбачає на основі k найближчих за обраною метрикою відстані. Класифікація використовує голосування більшості або з вагами за відстанню; регресія усереднює цілі сусідів. Масштабування є суттєвим, оскільки ознака з великим діапазоном може домінувати над евклідовою відстанню. Категоріальні, розріджені, послідовні або географічні дані можуть вимагати метрик Хеммінга, косинуса, редагування, великого кола або навчальних відстаней. Метрика є припущенням моделі про схожість і її слід перевіряти щодо реального значення близьких випадків.
Невелике k створює гнучкі межі з високою дисперсією та чутливістю до шуму; велике k згладжує передбачення і може стирати структуру меншини. Непарне k лише уникає деяких бінарних нічиїх і не є загальним правилом. Вибирайте k, метрику, ваги, набір ознак та попередню обробку в рамках крос‑валідації. Дисбаланс класів може змусити локальне голосування більшості ігнорувати рідкісні результати, тому слід аналізувати відгук за класами та склад околиць. У високих розмірностях відстані схильні до концентрації, а нерелевантні ознаки погіршують околиці; вибір, зменшення розмірності або навчені вбудовування можуть допомогти.
Індексація, невизначеність та виробничий експлуатаційний процес
Наївний інференс порівнює запит з кожною навчальною точкою. KD‑дерева та ball‑дерева допомагають у підходящих низьковимірних просторах; приблизні індекси найближчих сусідів міняють точність на швидкість та масштабованість. Вимірюйте відгук пошуку сусідів окремо від якості передбачення. Пам’ять включає збережені ознаки, мітки та структури індексу. Оновлення концептуально прості, проте можуть вимагати перебудови індексу, узгодженості версій та поширення видалень. Захищайте чутливі навчальні приклади, оскільки повернення сусідів або відстаней може розкрити записи.
KNN може виводити приклади, що роблять передбачення зрозумілим, проте близькість не означає причинність чи справедливість. Надавайте відстань, маржу голосування та правило утримання, коли околиці розріджені або суперечливі. Слідкуйте за відстанню запиту, мітками сусідів, зсувом ознак, затримкою та підтвердженими результатами. Підтримуйте синхронізацію попередньої обробки та версій індексу, а також тестуйте точні проти приблизних результати після змін. KNN є ефективною локальною базовою та пошуковою методою, коли відстань має сенс; він стикається з труднощами, коли схожість не може бути представлена доступними ознаками.
Практичний приклад: KNN для заміни продукту
Рітейлер представляє продукти за допомогою стандартизованих числових атрибутів, категоріальної сумісності та навчального текстового вбудовування, після чого визначає зважену відстань, перевірену мерчендайзерами. K та ваги обираються на основі майбутніх запусків продуктів, а не випадкових рядків товарів. Оцінка перевіряє релевантність підстановки, несумісні рекомендації, відстань, охоплення категорій та результати для рідкісних товарів. Базова лінія популярності показує, чи локальна схожість додає цінність.
Приблизний індекс тестується проти точних сусідів за відгуком та затримкою. Запити без близького сумісного товару не повертають пропозицію, а лише відсутність рекомендації, а не примусовий сусід. Видалення продуктів та виправлення атрибутів поширюються в індекс через оновлення версій. Моніторинг відстежує розподіл відстаней, порожні результати, переваги та комерційні результати, не плутаючи продажі зі справжньою сумісністю. Чутливі умови постачальників виключаються з пояснень, а повернуті приклади залишаються доказом схожості — а не заявою про еквівалентність продуктів.
Докази впровадження та готовність до експлуатації
Рішення щодо впровадження в продуктивне середовище потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої помилки. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які найбільше піддаються недообслуговуванню. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та відключення. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія повинна виявляти якість вводу, поведінку виводу, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих чутливих даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться незмінною. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткої точки, коли її слід вимкнути або замінити.
Часті запитання
Чи має KNN фазу навчання?
Він потребує мінімального підгонювання параметрів, проте все ж має процес розробки: попередня обробка вивчається на навчальних даних, може бути створений індекс, а k, метрика, ваги та ознаки обираються за допомогою валідації.
Чи є KNN тим же, що K-means?
Ні. KNN — це, перш за все, метод контролюваного локального передбачення. K-means — це неконтрольований алгоритм кластеризації, у якому K є кількістю центрів кластерів.
Основні джерела












