Основи ШІ
Що таке кластеризація k‑середніх?

 Додайте Unite.AI до бажаних джерел у Google
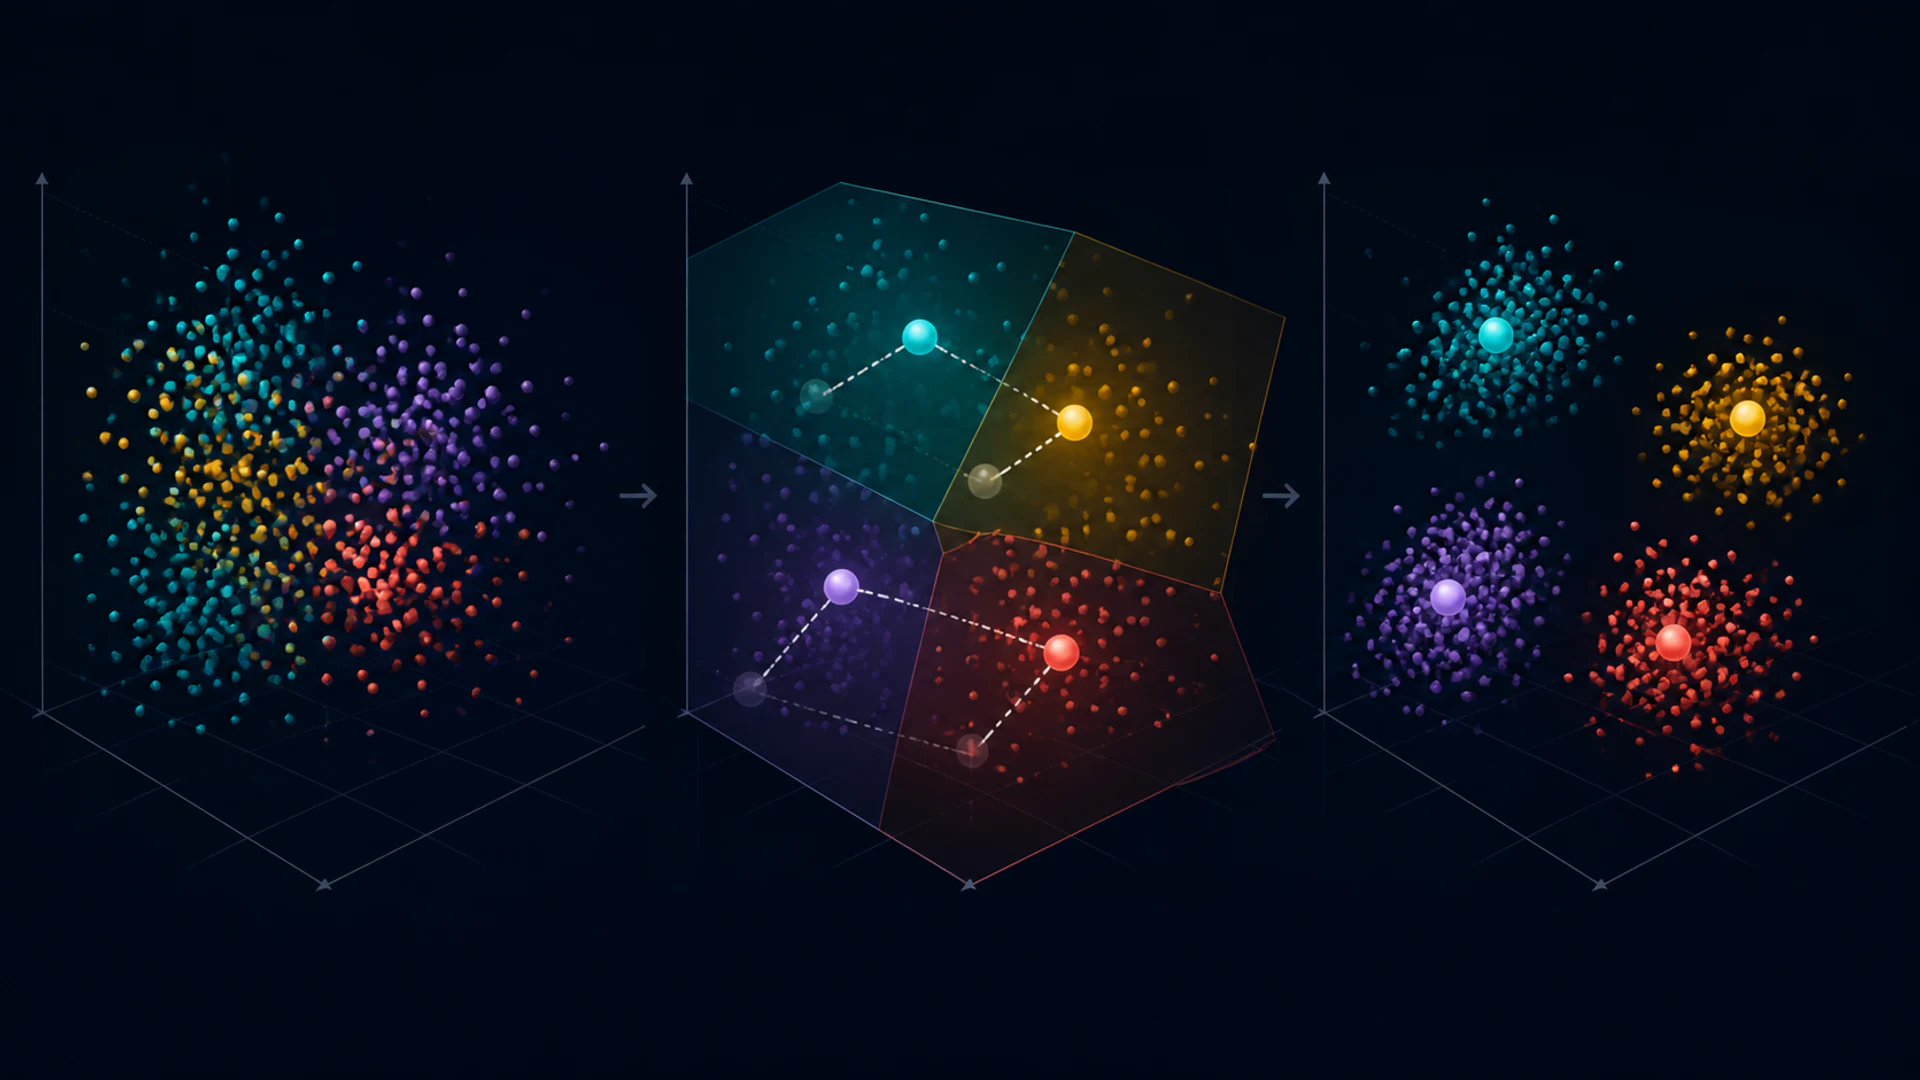
K-means — це алгоритм без нагляду, який розбиває числові спостереження на k кластерів. Він чергує кроки присвоєння кожної точки до найближчого центроїда та переобчислення кожного центроїда як середнього значення його призначених точок.
Алгоритм швидкий і корисний, проте його результат залежить від масштабування, метрики відстані, ініціалізації та обраного k. Кластер — це математичний розподіл, а не автоматично реальна категорія.
Основні висновки
- k‑means мінімізує суму квадратів евклідовської відстані всередині кластера до центроїдів.
- Ініціалізація має значення; k‑means++ розподіляє початкові центроїди і зазвичай покращує результати.
- Стандартизуйте ознаки, коли їхні одиниці чи масштаби мають вносити порівняний внесок.
- k‑means має труднощі з викидами, несферичними кластерами, нерівними густинами та категоріальними даними.
Мета та цикл оновлення
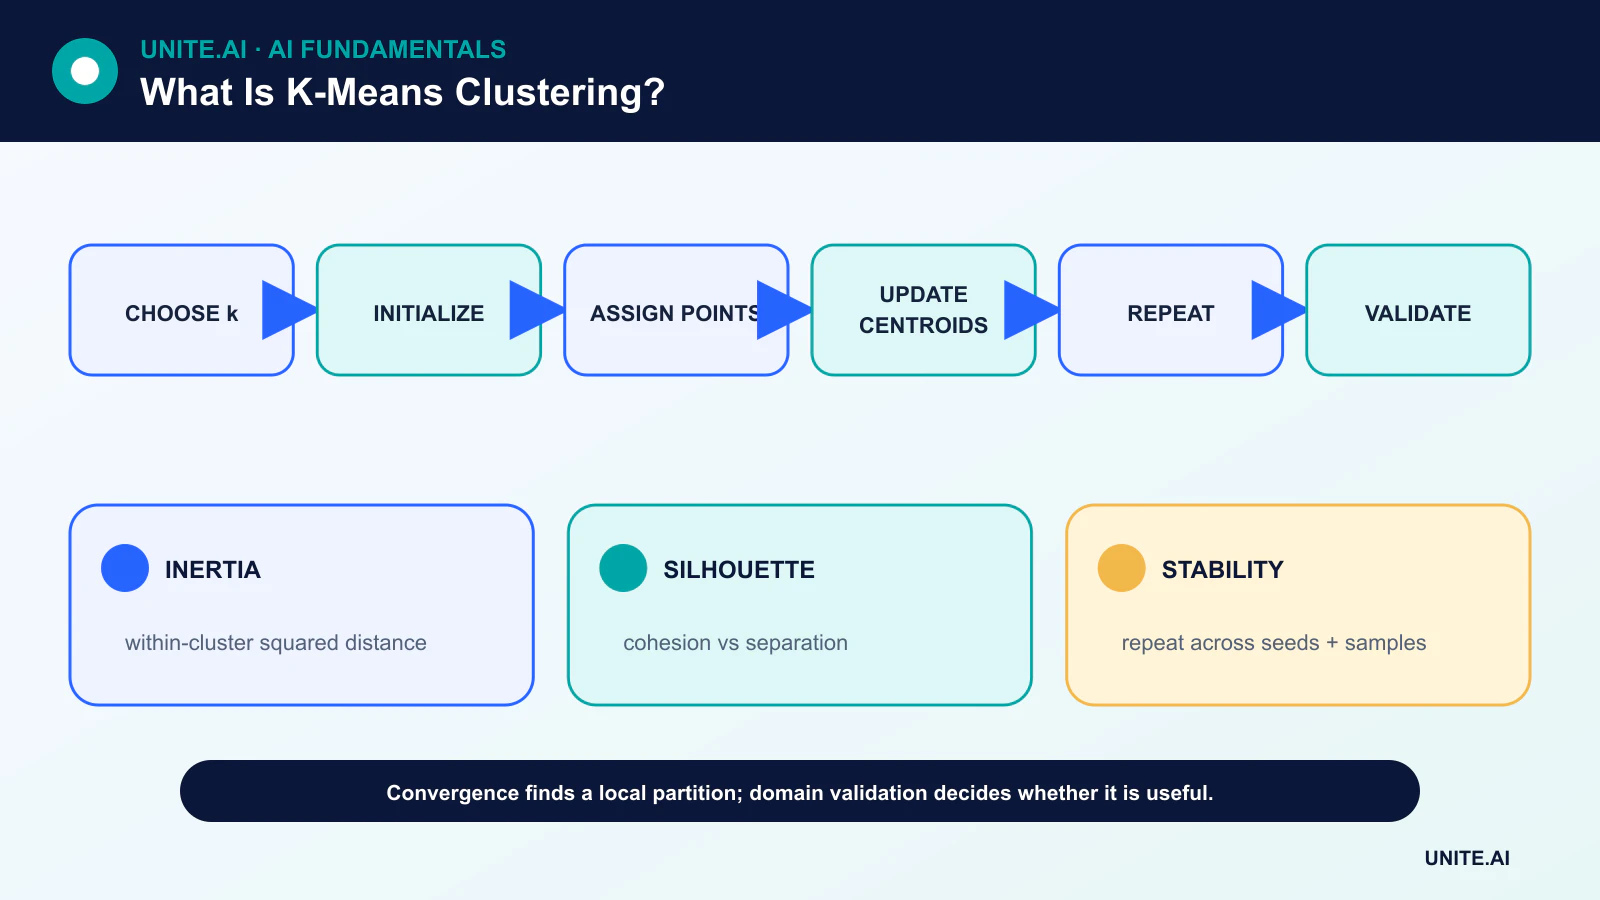
Маючи k центроїдів, крок присвоєння надсилає кожне спостереження до найближчого. Крок оновлення замінює кожен центроїд середнім значенням його призначених спостережень. Сума квадратів всередині кластера не може збільшуватись під час цих кроків, тому процес збігається до локального optimum.
Збіжність не гарантує глобального optimum. Різні початкові центроїди можуть призвести до різних розподілів, саме тому реалізації виконують кілька ініціалізацій і залишають рішення з найнижчою інерцією.
Ініціалізація та k‑means++
Випадковий вибір усіх початкових центроїдів з однієї густої області може дати погане рішення або повільну збіжність. k‑means++ обирає початкові точки з ймовірністю, що залежить від відстані до вже існуючих, що сприяє охопленню всього набору даних.
Кілька запусків залишаються корисними. Записуйте випадкове зерно та кількість ініціалізацій, щоб результати можна було відтворити.
Масштабування та відстань
Квадрат евклідовської відстані робить k‑means чутливим до одиниць виміру. Ознака, виміряна в тисячах, може домінувати над іншою, виміряною в діапазоні від нуля до одиниці. Стандартизація поширена, проте знання домену має вирішувати, чи рівна стандартизована дисперсія відображає рівну важливість.
Викиди можуть відтягнути середнє далеко від типових точок. Робастне масштабування, усічення або методи, засновані на медоїдах, можуть бути кращими. Однакові (one‑hot) категоріальні ознаки створюють геометрію відстані, яка може не відповідати схожості категорій.
Вибір k та валідація кластерів
Інерція зменшується при збільшенні k, тому вона не може сама визначити k. Евристика «ліктя» шукає зменшення покращення. Аналіз силуету порівнює згуртованість і розділення. Стабільність за різними вибірками та зернами додає ще одну перевірку.
Найсильнішою валідацією є корисність для цільового домену. Порівнюйте кластери з відомими результатами, експертною оцінкою або downstream‑завданням, не вдаючись до уявлення, що пост‑хок мітки були виявлені об’єктивно.
Обмеження та альтернативи
k‑means віддає перевагу компактним, приблизно сферичним групам схожого масштабу. Моделі гаусових сумішей представляють ймовірні еліпсоїдальні компоненти; методи типу DBSCAN виявляють густі області та шум; ієрархічна кластеризація створює дерево об’єднань.
Dimensionality reduction може підвищити швидкість або очистити вхідні дані, проте його навчання на всьому наборі даних може змінити питання валідації. Mini‑batch k‑means зменшує обчислення для великих наборів даних за рахунок приблизного оновлення.
Мета, ініціалізація та збіжність
K‑means розбиває числові спостереження на k кластерів, мінімізуючи суму квадратів евклідовської відстані всередині кластера до центроїдів. Алгоритм Ллойда чергує кроки присвоєння кожної точки до найближчого центроїда та переобчислення центроїдів, доки присвоєння або цільова функція не стабілізуються. Він збігається до локального optimum, який не обов’язково є глобальним найкращим. Ініціалізація k‑means++ розподіляє початкові центри і зазвичай покращує результати, проте кілька зерен залишаються важливими. Стандартизуйте ознаки, коли їхні одиниці мають вносити порівняний внесок, бо квадрат відстані підсилює змінні великого масштабу та викиди.
Метод передбачає приблизно компактні, сферичні, схожі за масштабом кластери в евклідовій геометрії. Він має труднощі з довгими маніфольдами, нерівною густотою, категоріальними даними, сильними викидами та вкладеною структурою. Порожні кластери та дублікати точок потребують визначеної обробки. Mini‑batch k‑means масштабується до великих даних за рахунок компромісу в точності. Для розрідженого тексту к‑сферичні к‑means, орієнтовані на косинус, можуть краще відповідати напрямку, тоді як суміші, методи густини, ієрархічна кластеризація чи k‑медоїди кодують інші припущення.
Вибір k та валідація змісту
Криві «ліктя», оцінки силуету, інформаційні критерії у пов’язаних моделях та стабільність можуть інформувати про k, проте жоден з них не відкриває унікально правильне число. Бізнес‑корисність та інтерпретація у домені мають значення. Перенавчайте на різних вибірках та зернах, порівнюйте рух центроїдів і послідовність присвоєння, а також валідуйте кластери на незалежних результатах, які не використовувалися при їх формуванні. Двовимірна проекція може спотворювати розділення, тому аналізуйте відстані та приклади у вихідному або валідаційному просторі представлення.
Кластери — це описові групи, створені обраними ознаками та метрикою; вони не є природними типами чи причинними сегментами. Профілі, побудовані на тих самих змінних, що використовуються для кластеризації, можуть бути циклічними. Використовуйте відкладені атрибути та якісний огляд, і перевіряйте, чи кластери в основному відтворюють географію, джерело даних або чутливі ознаки. Маленькі кластери можуть бути аномаліями або артефактами. Назва кластера не змушує кожного його учасника відповідати мітці.
Розгортання та обслуговування
Зберігайте разом масштабування, порядок ознак, центроїди, визначення відстані та мітки кластерів. Для нових точок моніторте відстань до призначеного центроїда та частку точок, що значно виходять за межі навчальної підтримки; надавайте стан «невідомо» замість примусової приналежності до кластера. Слідкуйте за розміром кластерів, центроїдами та релевантністю результатів у часі. Перенавчання змінює ідентичність кластерів, тому картографуйте або версіюйте downstream‑правила, а не беззвучно використовуйте старі назви. k‑means — корисна базова модель компресії та сегментації, коли його геометрія відповідає питанню, а не універсальний двигун відкриттів.
Практичний приклад: сегментація клієнтів за допомогою k‑means
Компанія зі підпискою стандартизує ознаки використання за фіксованим вікном, видаляє ідентифікатори акаунтів і тестує k за різними зернами. Оцінюються стабільність, силует та бізнес‑результати на відкладеній вибірці, а команди продукту також аналізують представницькі та граничні акаунти. Вони виявляють, що один кластер — це просто нові клієнти з коротшим періодом спостереження, тому тривалість обробляється окремо. k‑means порівнюється з ієрархічними та густинними альтернативами, а не вважається автоматично підходящим. Вправа розглядається як неконтрольоване навчання, а не виявлення міток.
Сегменти керують дослідженням та експериментами з повідомленнями, а не правом на участь чи ціною. Нові акаунти, що далеко від усіх центроїдів, отримують призначення «невідомо». Масштабування, ознаки, центроїди та назви версіюються, а перенавчання відображає нові кластери на старі лише за наявності доказів. Моніторинг відстежує розмір кластера, відстань та релевантність результатів. Чутливі атрибути та проксі‑змінні аудитується, і команда уникає опису кластерів як природних типів особистості, коли це лише математичні розподіли вибраної поведінки.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базу та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, пошкоджені або відсутні дані, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які можуть залишитися без належного обслуговування. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Записуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг шляхом навмисного внесення збоїв. Операційна телеметрія має виявляти якість вхідних даних, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних чутливих даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Поширені запитання
Чи є k‑means контрольованим чи неконтрольованим?
Він є неконтрольованим, оскільки отримує лише ознаки та обрану кількість кластерів, а не цільові мітки.
Чи класифікує k‑means нові дані?
Після навчання нову точку можна призначити до найближчого центроїда. Це призначення до кластера, а не обов’язково передбачення класу у контрольованому режимі.
Основні джерела