
Основи ШІ
Що таке автокодер?

 Додайте Unite.AI до бажаних джерел у Google
Автокодер — це нейронна мережа, навченa відтворювати свій вхід. Енкодер перетворює вхід у латентне представлення; декодер перетворює це представлення назад у відтворення. Навчання мінімізує втрату відтворення, іноді з додатковими обмеженнями.
Повне копіювання вхідних даних не обов’язково корисне. Архітектура або цільова функція повинна створювати вузьке місце, додавати шум, накладати розрідженість або іншим чином запобігати тривіальній ідентичній відображенню, щоб латентний код захоплював корисну структуру.
Основні висновки
- Енкодер стискає або перетворює вхід; декодер відтворює його з латентного коду.
- Недостатньо повне вузьке місце, шум або регуляризація спонукають модель вивчати структуру, а не копіювати.
- Помилка відтворення може використовуватись для виявлення аномалій, проте аномалії не обов’язково мають високу помилку.
- Варіаційні автокодери навчають ймовірнісну латентну модель і відрізняються від детермінованих автокодерів.
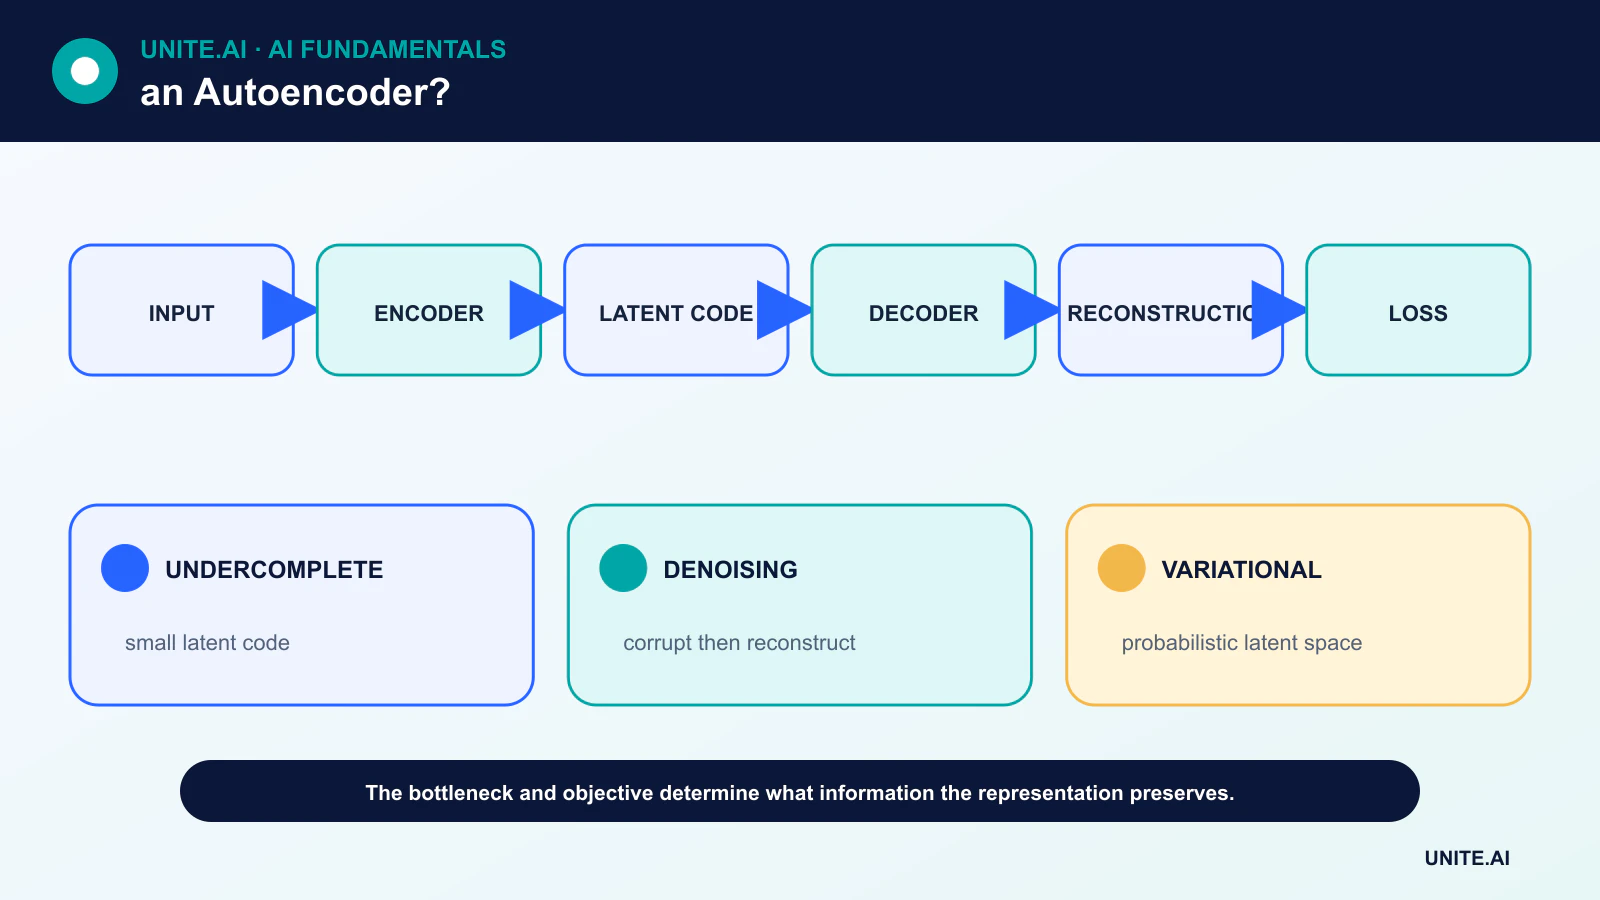
Енкодер, латентний простір та декодер
Для входу x енкодер створює латентний код z = f(x), а декодер створює відтворення x̂ = g(z). Втрата порівнює x і x̂, наприклад за допомогою середньоквадратичної помилки для неперервних значень або правдоподібності, що підходить до даних.
Латентна розмірність може бути меншою за розмірність входу, створюючи недостовірний автокодер. Глибока мережа також може навчатися нелінійним представленням, розширюючи ідею, що лежить в основі зменшення розмірності.
Поширені варіанти автокодерів
Розріджений автокодер штрафує розповсюджену активацію. Автокодер з шумозаглушенням отримує пошкоджений вхід і відтворює чисту версію. Контрактний автокодер штрафує чутливість коду до невеликих змін вхідних даних.
Варіаційний автокодер (VAE) кодує параметри ймовірнісного розподілу, вибирає латентне значення та балансує відтворення з регуляризаційним членом, що формує латентний простір. Це підтримує генерацію вибірок, але змінює цільову функцію та інтерпретацію.
Навчання та запобігання тривіальним рішенням
Автокодери використовують зворотне поширення, як інші нейронні мережі. Мережа з надмірною місткістю може запам’ятовувати приклади навчання або вивчати майже ідентичну функцію. Розмір вузького місця, пошкодження, штрафи та валідація на невідомих даних обмежують це.
Вибір функції втрат має значення. Піксельна втрата може давати розмиті відтворення зображень, тоді як перцептивні втрати успадковують припущення іншої мережі. Найкраща метрика відтворення не обов’язково є найкращим виміром семантичної схожості.
Застосування та обмеження
Автокодери можуть навчатися ознакам, подавляти шум у сигналах, стискати дані, ініціалізувати моделі та створювати латентні змінні для візуалізації. Для виявлення аномалій модель, навчена на нормальних даних, може присвоювати вищу помилку відтворення незвичайним входам.
Такий підхід може не спрацювати, коли автокодер також добре відтворює аномалії або коли безпечна варіація важче відтворюється, ніж цільова аномалія. Пороги потребують мічених або ретельно перевірених валідаційних даних, а помилку слід моніторити за підгрупами та умовами експлуатації.
Автокодери порівняно з іншими генеративними моделями
Детермінований автокодер не автоматично є ймовірнісною генеративною моделлю. VAE визначають структурований латентний розподіл; GANs навчають генератор проти дискримінатора; дифузійні моделі вивчають процес шумозаглушення.
Вибір залежить від того, чи мета — відтворення, представлення, правдоподібність, якість зразка, керованість чи оцінка аномалій. Менша модель, орієнтована на конкретне завдання, часто практичніша, ніж великий генератор зображень.
Цілі енкодер‑декодер та латентні представлення
Автокодер навчає енкодер, який перетворює вхід x у латентний код z, та декодер, який відтворює x з z. Якщо місткість не обмежена, модель може вивчити ідентичне відображення без корисної структури. Вузькі місця, регуляризація, пошкодження, розрідженість або архітектурні обмеження змушують представлення зберігати обрану інформацію. Функція втрат відтворення визначає, що вважається схожим: середньоквадратична помилка сприяє середній точності пікселів, тоді як перцептивні або специфічні для модальності втрати підкреслюють різні ознаки. Низька втрата не гарантує семантичного значення.
Недостатньо повні автокодери обмежують розмірність латентного простору. Автокодери з шумозаглушенням відтворюють чисті дані з пошкодженого входу. Розріджені варіанти штрафують активацію; контрактні варіанти штрафують чутливість. Варіаційні автокодери навчають ймовірнісний латентний розподіл, поєднуючи відтворення з членом дивергенції, що дозволяє генерувати вибірки, але змінює цільову функцію. Конволюційні, послідовні, графові та трансформерні автокодери кодують структуру модальності. Вибирайте розмір латенту та регуляризацію через валідацію нижчого рівня, а не лише за привабливими двовимірними графіками.
Виявлення аномалій, стискання та оцінка
Для виявлення аномалій навчайте модель на репрезентативних нормальних даних і оцінюйте помилку відтворення або ймовірність латенту, проте іноді аномалії можуть добре відтворюватись, а рідкісні нормальні випадки — погано. Вибирайте пороги за міченими або переглянутими валідаційними випадками, повідомляйте про відгук на рівні подій та хибні тривоги, і тестуйте зміни в режимі експлуатації. Порівнюйте зі простими статистичними та однокласовими базовими моделями. Для стискання підраховуйте повний кодек — включаючи розмір моделі, квантування, метадані та обчислення декодування — і порівнюйте якість при однаковому бітрейті з усталеними кодеками.
Якість представлення можна оцінювати за допомогою лінійних проб, стабільності кластеризації, пошуку, відтворення та downstream‑завдань, кожне з яких відповідає на інше питання. Уникайте витоку даних під час навчання енкодера та вибору порогів. Перевіряйте, які ознаки ігнорує функція втрат і чи залишаються чутливі атрибути закодованими. Стиснений латентний простір не автоматично анонімізується; інверсія та виведення атрибутів можуть відновити приватну інформацію. Згенеровані відтворення можуть виглядати правдоподібно, змінюючи при цьому критичні деталі.
Розгортання та моніторинг
Версіонуйте енкодер і декодер разом, перевіряйте числові зміни після експорту та зберігайте масштабування входу. Моніторьте розподіл відтворень, дрейф латенту, порогові сповіщення та підтверджені результати. У промисловому моніторингу адаптуйте модель до режиму роботи, щоб нормальні переходи не розглядалися як відмови. Для медичного або наукового відтворення ніколи не представляйте згенеровану деталь як виміряне доказ без валідації та походження. Автокодери — це гнучкі навчальники представлень, проте обмеження та втрата — а не назва архітектури — визначають, яка інформація зберігається, відкидається або створюється штучно.
Практичний приклад: автокодер для аномалій насосів
Недостатньо повний автокодер навчає вікна вібрації на основі перевіреної здорової роботи насосів за різними навантаженнями та температурами. Його порівнюють зі статистичними порогами та однокласовими методами, а поріг відтворення вибирають на основі переглянутих нормальних переходів та відомих несправностей. Оцінка використовує відгук подій, час попередження, кількість хибних тривог на годину експлуатації та результати за кожним насосом, а не випадкові вікна, які розміщують суміжні зразки у навчальній та тестовій вибірках.
Виробнича модель адаптується до стану експлуатації та показує інженерам залишкові патерни. Висока помилка викликає інспекцію; вона не діагностує деталь і не зупиняє насос автоматично. Відключення датчика, обрізка та невідоме навантаження створюють явно недійсні стани. Моніторинг відстежує розподіл відтворень, підтвердження тривог та стан датчиків. Коли технічне обслуговування або зміна обладнання змінює базову лінію, стара модель залишається доступною, поки кандидат навчається на переглянутих даних і перевіряється проти історичних інцидентів.
Докази впровадження та готовність до експлуатації
Виробниче рішення потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, середовище експлуатації, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої відмови. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, неправильний або відсутній вхід, зсув розподілу, відключення залежностей, неправильне використання та групи або середовища, які найбільше ризикують бути недообслуговуваними. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та завершення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має виявляти якість входу, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги тривог і відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує задокументованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Часті запитання
Чи є автокодери безвтратним стисканням?
Зазвичай ні. Вони, як правило, навчаються створювати втратні представлення, специфічні для завдання та розподілу, і потребують навченого декодера для відтворення даних.
Чи можна інтерпретувати кожне вузьке місце?
Ні. Компактний код може бути корисним, навіть якщо кожен його вимір не відповідає зрозумілому людині концепту.
Основні джерела












