Основи ШІ
Що таке комп’ютерний зір?

 Додайте Unite.AI до бажаних джерел у Google
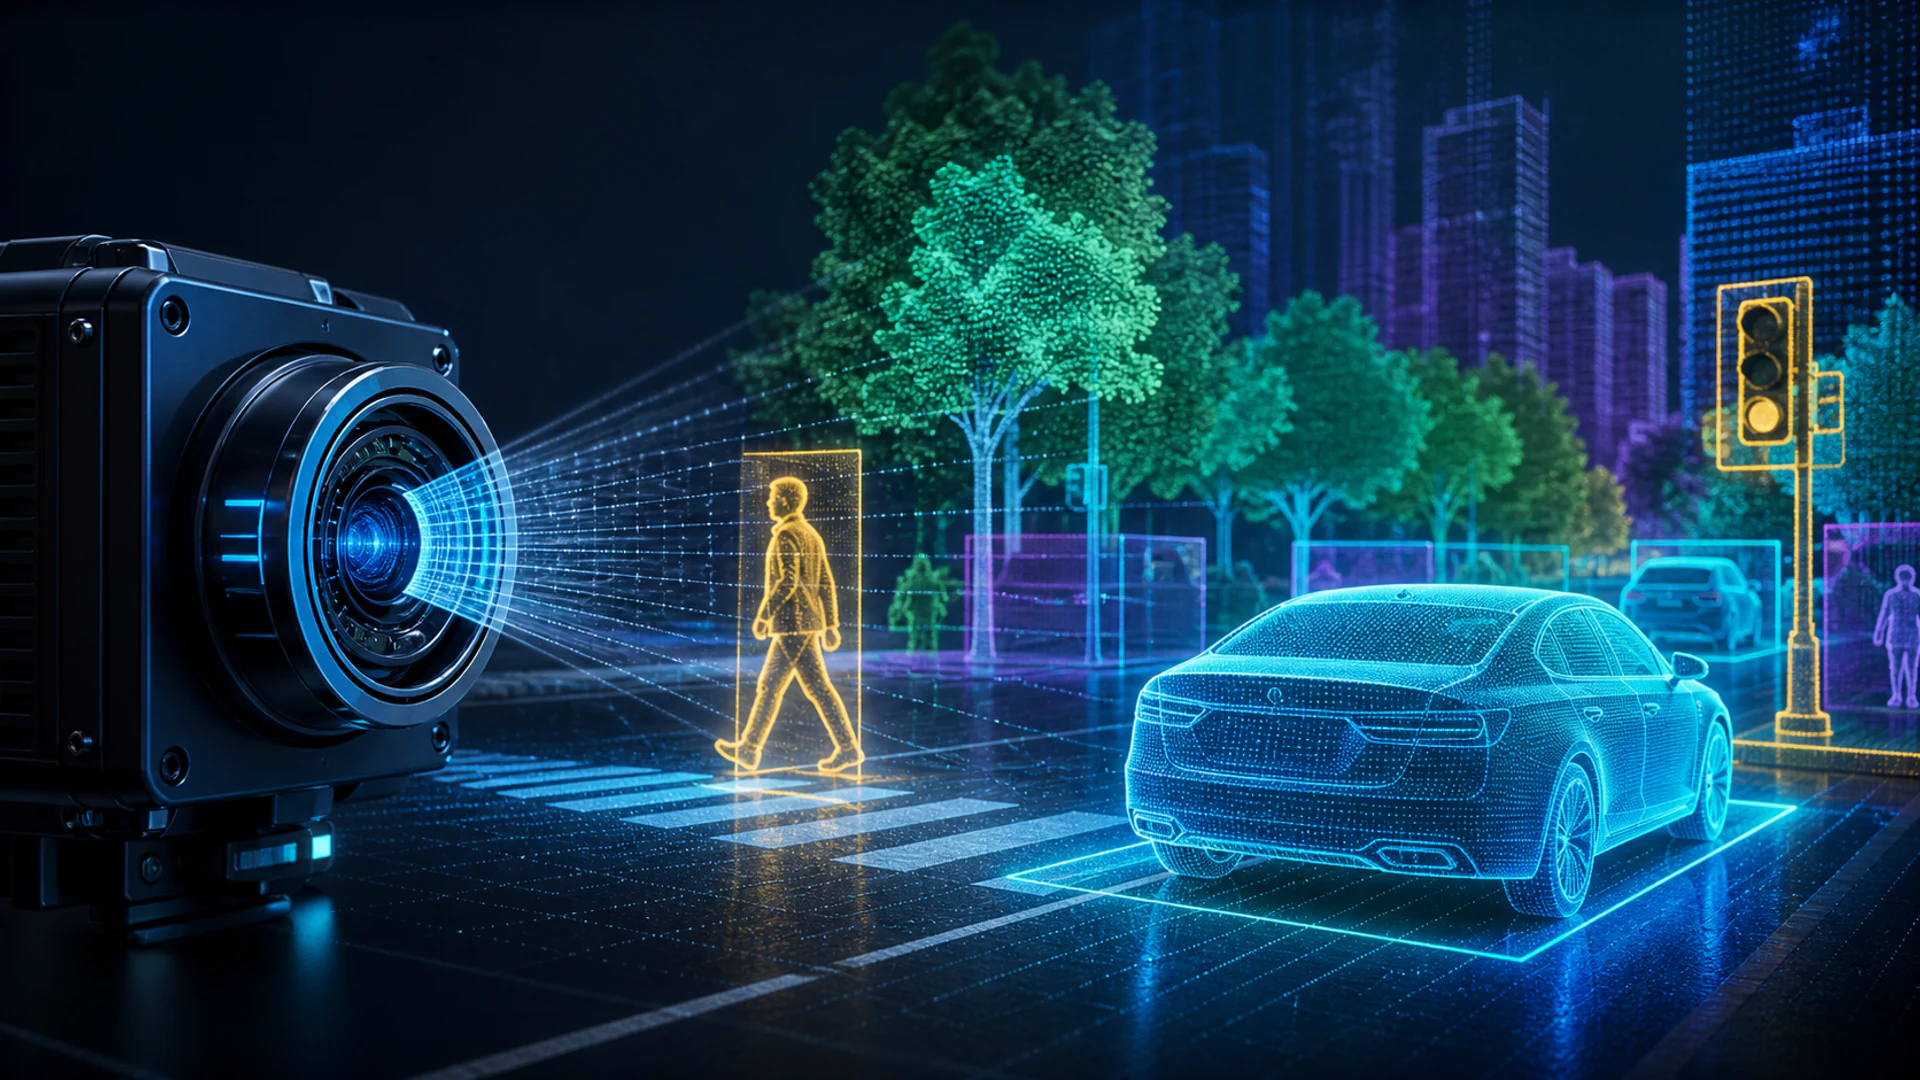
Комп’ютерний зір — це галузь, що створює системи, які отримують корисну інформацію з зображень та відео. Модель зору може класифікувати ціле зображення, виявляти об’єкти, позначати кожен піксель, розпізнавати текст, оцінювати позу, відстежувати рух або поєднувати візуальний вміст з мовою.
Сучасні системи зору не просто копіюють початковий процес виявлення контурів, характерний для людського сприйняття. Вони навчаються створювати специфічні для завдання представлення даних, часто використовуючи згорткові нейронні мережі, трансформери зору або мультимодальні фундаментальні моделі.
Основні висновки
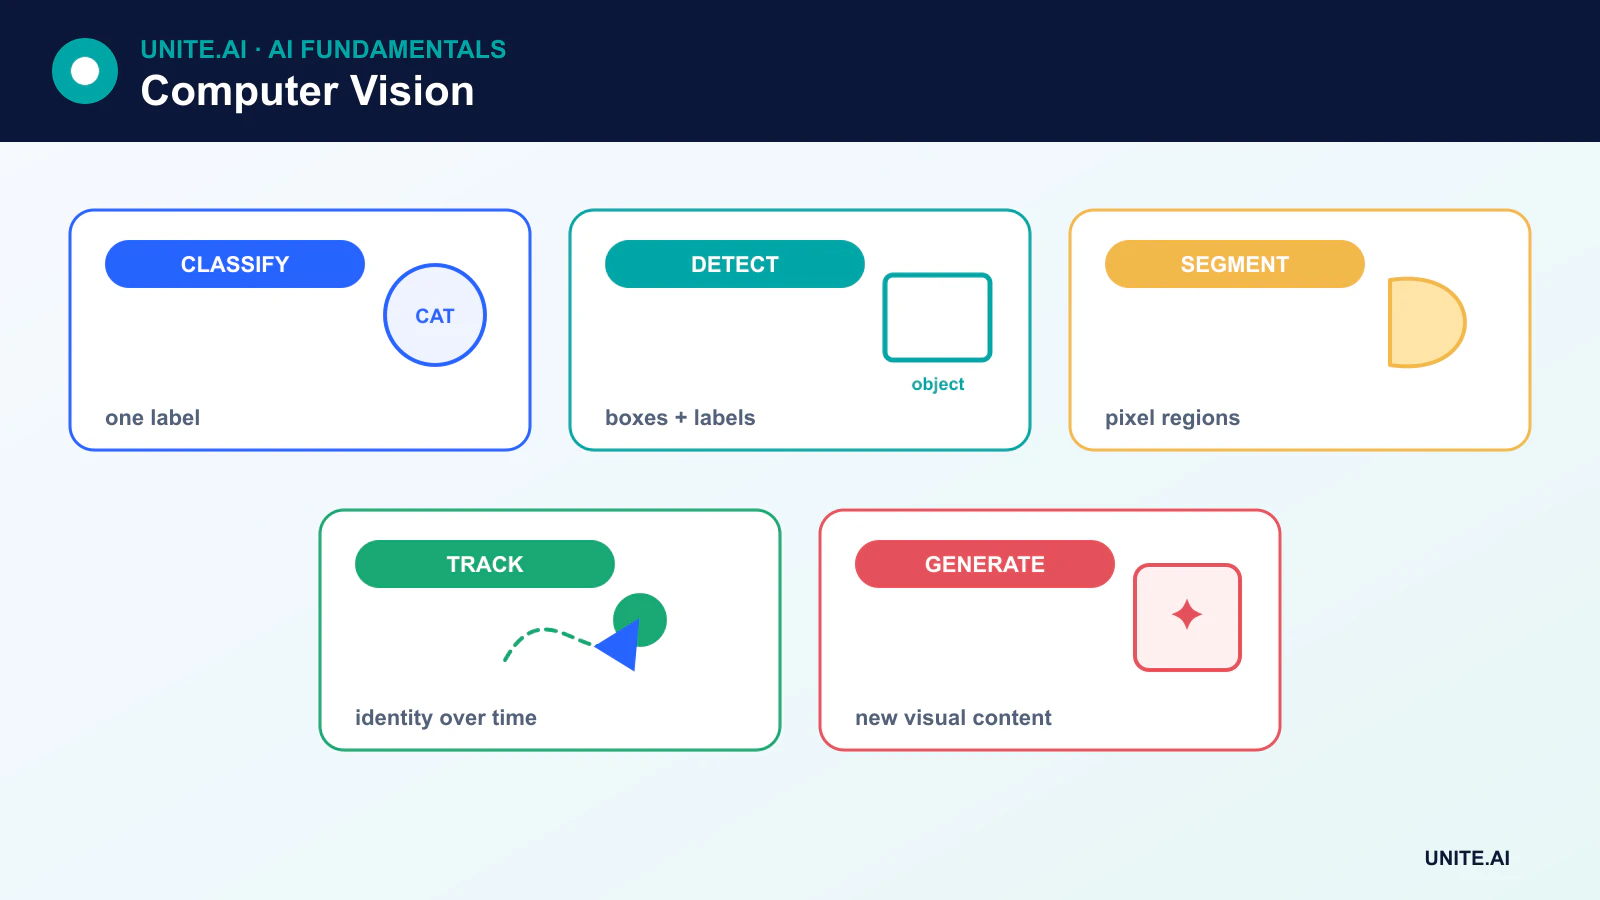
- Класифікація, виявлення, сегментація, OCR, відстеження та генерація — це різні завдання комп’ютерного зору.
- CNN‑и вбудовують локальність та спільне використання ваг; трансформери зору застосовують увагу до патчів зображення.
- Мітки можуть надходити від людей, слабкого нагляду, синтетичних даних або самонавчальних цілей.
- Тільки точність недостатня: важливі стійкість, затримка, конфіденційність, упередженість та витрати на помилки.
Основні завдання комп’ютерного зору
- Класифікація зображень призначає одне або кілька міток зображенню. Дивіться як працює класифікація зображень.
- Виявлення об’єктів передбачає категорії та обмежувальні рамки для декількох об’єктів.
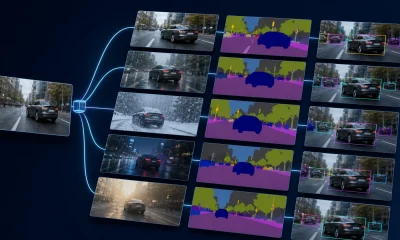
- Семантична сегментація позначає кожен піксель за класом, тоді як інстанційна сегментація розділяє окремі об’єкти.
- Оптичне розпізнавання символів (OCR) виявляє та транскрибує текст.
- Оцінка поз передбачає ключові точки тіла або об’єкта.
- Відстеження пов’язує виявлення між кадрами відео.
- Генерація та редагування зображень створює або трансформує візуальний контент, часто використовуючи моделі дифузії.
Як зображення стають вхідними даними моделі
Цифрове зображення вже є числовими даними: тензором, що містить значення пікселів у просторових вимірах та каналах. Попередня обробка може змінювати розмір, нормалізувати, обрізати або розширювати зображення. Відео додає часовий вимір, а медичні та наукові зображення можуть додавати глибину, довжину хвилі чи інші модальності.
Класичний комп’ютерний зір використовував ручно розроблені ознаки країв, кутів та текстур. Сучасні глибокі моделі зазвичай навчаються ознакам спільно з завданням, хоча класичні методи залишаються корисними, коли даних мало, правила добре зрозумілі або обчислювальні ресурси обмежені.
CNN‑и та вивчені локальні ознаки
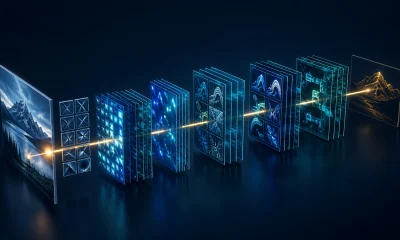
CNN застосовує вивчені ядра до локальних околиць. Перші шари реагують на локальні шаблони, тоді як пізніші блоки комбінують їх у представлення, релевантні завданню. Операції пулінгу або кроку зменшують просторову роздільність, а залишкові зв’язки полегшують оптимізацію глибоких мереж.
Сучасний CNN‑класифікатор часто використовує глобальний пулінг замість великої кількості повністю зв’язаних шарів. Детектори та мережі сегментації додають спеціалізовані головки або декодерні шляхи, які зберігають просторову інформацію.
Трансформери зору та фундаментальні моделі
Трансформер зору розбиває зображення на патчі, кодує їх та застосовує увагу для моделювання їхніх взаємозв’язків. Трансформери ефективно масштабуються з великими наборами даних та попереднім навчанням, тоді як CNN часто забезпечують більш міцні вбудовані припущення та ефективність у менших масштабах.
Мультимодальні моделі вирівнюють зображення з текстом, дозволяючи користувачам шукати, створювати підписи, відповідати на питання або керувати сегментацією за допомогою мови. Ці моделі розширюють можливості, але також успадковують недоліки широких веб‑масштабних даних, включаючи стереотипи, захищений авторським правом матеріал та нерівномірне охоплення населення та середовищ.
Мітки, самонавчання та синтетичні дані
Створення обмежувальних рамок, масок, ключових точок та підписів може бути дорогим. Самонавчальне навчання отримує цілі безпосередньо з зображень, тоді як слабкий нагляд використовує шумні або непрямі мітки. Синтетичні дані можуть додати рідкісні сценарії, проте розриви у симуляції можуть завадити перенесенню результатів синтетики у реальний світ.
Якість анотації повинна вимірюватися. Неоднозначні мітки, непослідовні межі та відсутність об’єктів встановлюють межу продуктивності і можуть приховувати помилки в підгрупах.
Як оцінюються системи зору
Для класифікації використовуються метрики, такі як точність, precision, recall, F1 та калібрування. Для виявлення зазвичай застосовують Intersection over Union та середню точність (mAP). Сегментація використовує Intersection over Union або показники у стилі Dice. Відстеження додає метрики ідентичності та траєкторії.
Метрика повинна відповідати умовам розгортання. Модель може добре показати себе на підготовленому бенчмарку, але провалитися в дощ, низьке освітлення, незвичні кути камери, нові пристрої або незнайомі популяції. Оцінка має включати зміни розподілу, атакуючі умови та операційну затримку.
Конфіденційність, упередженість та розгортання
Обличчя, номерні знаки, будинки, медичні сканування та відео в робочому середовищі можуть розкривати конфіденційну інформацію. Збір та зберігання мають базуватися на визначеній правовій та етичній основі, з контролем доступу та мінімізацією даних. Аналіз обличчя та біометрична ідентифікація вимагають особливої уваги, оскільки помилки та спостереження можуть завдати нерівномірної шкоди.
Розгортання на краю (edge) може знизити затримку та обсяг передаваних даних. Edge AI, квантування, обрізка та спеціалізовані прискорювачі можуть зробити системи зору практичними на камерах, транспортних засобах, роботах та мобільних пристроях, проте компресію треба переоцінювати щодо точності та упередженості.
Від пікселів до візуальних завдань
Комп’ютерний зір перетворює зображення або відео у результати завдань, таких як класифікація, виявлення, сегментація, відстеження, поза, глибина, оптичний потік або розпізнавання тексту. Визначення завдання визначає анотацію: мітка зображення не може навчити точному локалізуванню, а обмежувальна рамка не може повністю описати маску сегментації. Геометрія камери, об’єктиви, експозиція, освітлення, рух, компресія та точка зору формують розподіл даних. Визначте робоче середовище та наслідки помилок перед вибором моделі, оскільки колекція зображень для бенчмарку може не представляти розгорнутий сенсор чи сцену.
Конвеєр декодує та орієнтує медіа, змінює розмір або розбиває його на плитки, нормалізує значення, застосовує аугментацію, що зберігає мітки, запускає модель і пост‑обробляє логіти, рамки, маски або траєкторії. Детектори об’єктів використовують пороги впевненості та подавлення; трекери пов’язують виявлення у часі; сегментація може вимагати морфологічного очищення. Зберігайте перетворення координат, щоб результати відповідали оригінальному зображенню. Розділяйте дані за особою, камерою, локацією або сеансом захоплення, щоб уникнути майже ідентичних кадрів у навчальному та тестовому наборах.
Оцінка, упередженість, конфіденційність та операції
Метрики мають відповідати завданню та використанню. Для класифікації потрібні precision та recall для кожного класу; виявлення використовує Intersection over Union та середню точність за порогами; сегментація — IoU або показники у стилі Dice; відстеження додає зміни ідентичності; затримка та тривалість пропущених подій важливі для відео. Подавайте результати за освітленням, відстанню, пристроєм, оклюзією, кольором шкіри, віком та іншими релевантними умовами. Перевіряйте калібрування та помилки з високою впевненістю. Синтетичні або аугментовані дані можуть заповнювати прогалини, але потребують порівняння з реальними даними розгортання та не повинні витікати тестові сцени.
Зір може збирати дані про присутніх, локації, біометрію та чутливу поведінку. Мінімізуйте захоплення та зберігання, забезпечуйте безпеку потоків, обмежуйте вторинне використання та надавайте повідомлення або згоду, коли це потрібно. Тестуйте атакуючі патчі, повтори, оклюзію, відмови камери та зміни домену. Слідкуйте за станом сенсорів, статистикою вхідних даних, швидкістю виходу та підтвердженими результатами; залишайте людський контроль для важливих рішень. Розмиття або кадрування може зменшити експозицію, але й видалити докази. Високий лабораторний бал не виправдовує заяви про ідентичність, емоції чи наміри поза межами підтвердженого завдання.
Практичний приклад: виявлення пішоходів на перетині складу
Камери стежать за обмеженим перетином транспортних засобів, і модель виявляє людей, а не ідентифікує їх. Дані охоплюють день і ніч, погодні умови, одяг, оклюзію, користувачів інвалідних візків, позиції камер та порожні сцени, розділені за сеансами запису. Детектор оцінюється за відгуком подій, хибними тривогами, локалізацією, часом попередження та продуктивністю на відстані. Інженерія безпеки визначає максимальну допустиму затримку та незалежні фізичні контролі.
Попередження зору може сповільнити транспортний засіб, проте аварійне зупинення та бар’єри не залежать від навченої моделі. Перешкоди камери, завислі кадри, втрата мережі та тайм‑аут моделі створюють явні помилки. Зберігання необробленого відео мінімізується, а доступ реєструється. Моніторинг стежить за станом сенсорів, частотою тривог, розглянутими інцидентами та майже пропущеними випадками за умовами. Будь-яке переміщення камери або зміна планування викликає повторну валідацію, оскільки схожа на вигляд зображення не гарантує однакову геометрію чи ризик.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, робоче середовище, вхідні та вихідні дані, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній вхід, зміни розподілу, відмову залежностей, неправильне використання та групи чи середовища, які, ймовірно, залишаться без належного обслуговування. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний ревізор міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія повинна розкривати якість вхідних даних, поведінку виходу, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору непотрібних конфіденційних даних. Визначте пороги тривоги та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переоцінюйте щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення чи цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Поширені запитання
Чи є комп’ютерний зір тим же, що розпізнавання зображень?
Ні. Розпізнавання зображень зазвичай означає класифікацію або ідентифікацію. Комп’ютерний зір також включає локалізацію, сегментацію, вимірювання, відстеження, реконструкцію, генерацію та розуміння візуальної інформації.
Чи бачить система зору так, як людина?
Ні. Модель обробляє числові вхідні дані згідно зі своєю архітектурою та ціллю навчання. Вона може перевершити людей у вузькому бенчмарку, але зазнає невдач при невеликих змінах, які людина легко обробляє.
Основні джерела