
Основи ШІ
Що таке зворотне поширення?

 Додайте Unite.AI до бажаних джерел у Google
Зворотне поширення — це алгоритм, який використовується для обчислення того, як змінюється втрата нейронної мережі щодо її навчальних параметрів. Він застосовує правило ланцюгового диференціювання у зворотному напрямку через операції, записані під час прямого проходу.
Зворотне поширення обчислює градієнти; воно саме по собі не визначає оновлення. Оптимізатор, такий як стохастичний градієнтний спуск або AdamW, використовує ці градієнти для зміни ваг, зсувів і інших навчальних параметрів.
Ключові висновки
- Прямий проход формує проміжні значення та генерує передбачення.
- Функція втрат перетворює передбачення та ціль у скалярну навчальну мету.
- Зворотне поширення використовує локальні похідні та правило ланцюга для ефективного обчислення градієнтів параметрів.
- Сучасні фреймворки реалізують автоматичне диференціювання у режимі зворотного проходу над обчислювальним графом.
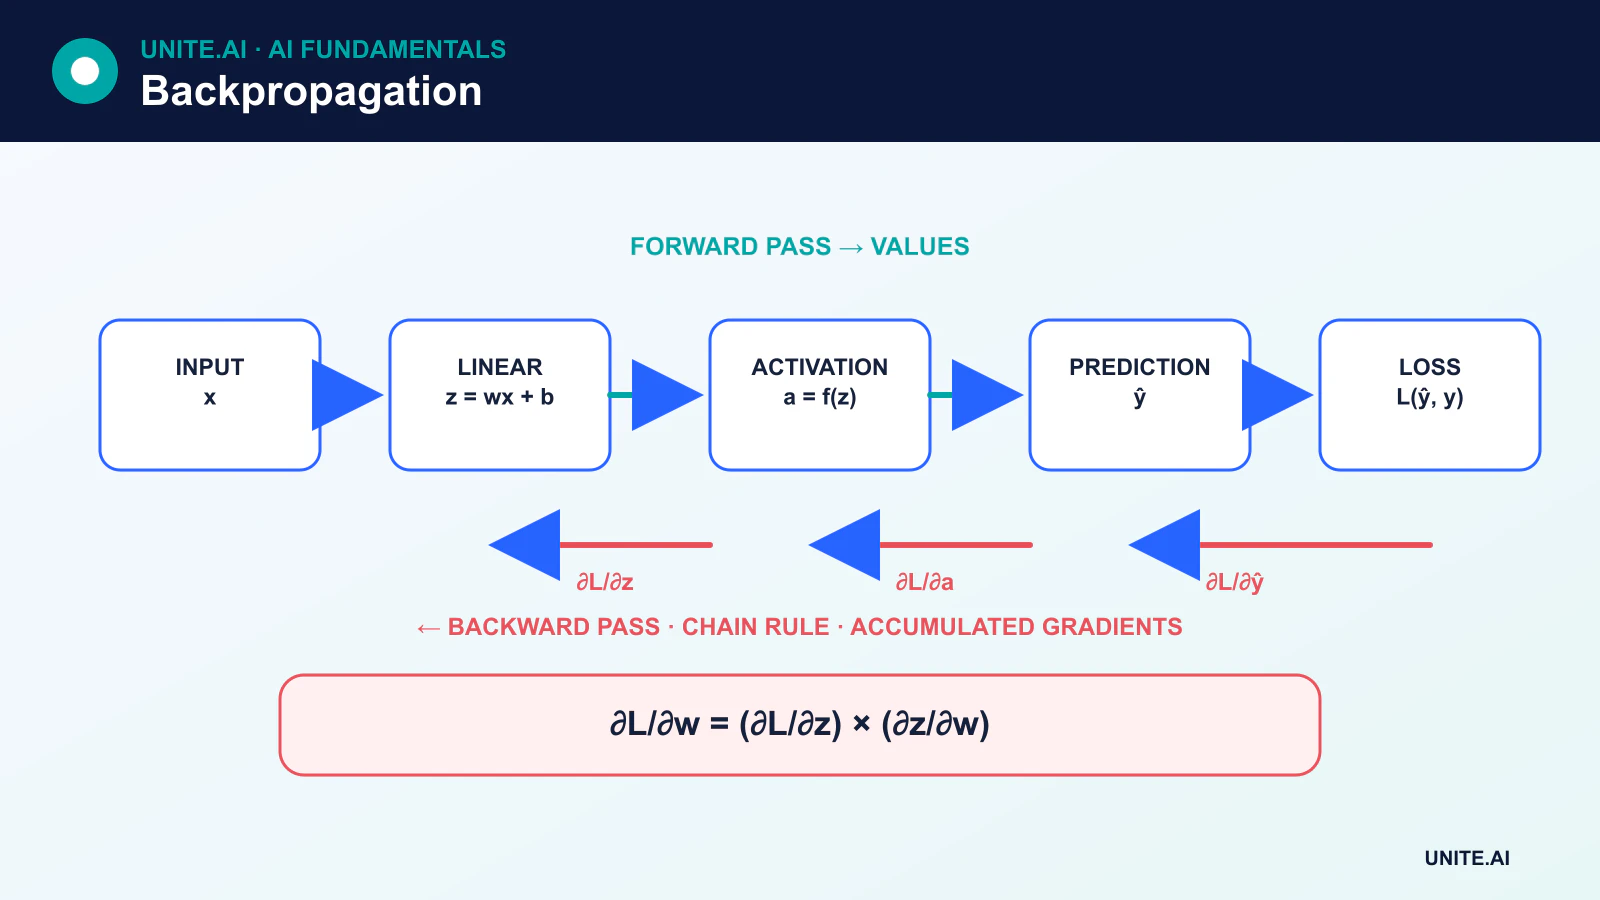
Прямий проход
Розглянемо просту одиницю:
z = wx + bŷ = activation(z)
Вхід — це x, а w і b — навчальні параметри ваги та зсуву. Зсуви зазвичай змінюються під час навчання так само, як і ваги. Мережа комбінує багато подібних операцій, а також нормалізацію, увагу, згортки, залишкові зв’язки або інші диференційовані блоки.
Прямий проход виконує ці операції та генерує передбачення. Функція втрат, наприклад крос-ентропія або середньоквадратична помилка, вимірює ціль. Найкраща функція втрат залежить від завдання та інтерпретації виходу.
Правило ланцюга
Якщо функція втрат L залежить від проміжного значення z, а z залежить від параметра w, правило ланцюга дає:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Глибока мережа містить багато шляхів. Зворотне поширення проходить обчислювальний граф у зворотному напрямку, накопичуючи внески, коли значення впливає на втрату через більше ніж один шлях. Результатом є градієнт для кожного навчального параметра, який брав участь у прямому обчисленні.
Невеликий числовий приклад
Припустимо, ŷ = wx + b, де x = 2, w = 3, а b = 1. Передбачення дорівнює 7. Якщо цільове значення 5 і функція втрат L = ½(ŷ – y)², тоді:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Оптимізатор може тоді перемістити w і b у напрямку негативного градієнту. Ця формула специфічна для обраної лінійної одиниці та функції квадратичної помилки; універсальне правило зворотного поширення — це правило ланцюга над фактичним графом, а не одне фіксоване «помилкове» рівняння.
Зворотне поширення проти градієнтного спуску
Градієнтний спуск — це метод оптимізації. Зворотне поширення надає необхідні градієнти. Крок навчання зазвичай включає:
- Очистити або скинути накопичені градієнти.
- Виконати прямий проход.
- Обчислити втрату.
- Виконати зворотний проход.
- Застосувати оновлення оптимізатора.
Розділення цих понять полегшує розуміння моменту, AdamW, накопичення градієнтів та навчання зі змішаною точністю.
Автоматичне диференціювання
Фреймворки, такі як PyTorch, записують операції та будують граф під час прямого проходу. Автоматичне диференціювання у режимі зворотного проходу потім ефективно обчислює векторно-Якобіанні добутки від виходів до параметрів. Це більш загальне, ніж ручне кодування похідних для фіксованої мережі, і є фундаментальним для сучасних фреймворків глибокого навчання.
Деякі операції не диференційовані або мають нестабільні похідні. Фреймворки визначають субградієнти або документовані конвенції у певних випадках, проте практикам все ж потрібно розуміти відокремлені тензори, операції «на місці» та числову точність.
Зникаючі та вибухаючі градієнти
Повторне множення через багато шарів або часових кроків може зробити градієнти надзвичайно малими або великими. Зникаючі градієнти уповільнюють навчання у ранніх шарах; вибухаючі градієнти дестабілізують оновлення. Активації сімейства ReLU, ретельна ініціалізація, залишкові зв’язки, нормалізація, гейтовані рекурентні зв’язки та обрізка градієнтів допомагають, проте жоден з них не є універсальним вирішенням.
Перевірка градієнтів
Перевірка градієнтів за скінченними різницями порівнює аналітичний або автоматичний градієнт з чисельною апроксимацією. Це повільно, але корисно для налагодження користувацьких операцій. Моніторинг норм градієнтів та виявлення NaN або нескінченних значень може виявити нестабільність під час навчання.
Правило ланцюга через обчислювальний граф
Зворотне поширення ефективно обчислює градієнти скалярної втрати щодо кожного диференційованого параметра. Прямий проход записує проміжні значення в обчислювальний граф. Починаючи з втрати, автоматичне диференціювання у зворотному режимі застосовує правило ланцюга, множачи локальні похідні та накопичуючи внески там, де шляхи з’єднуються. Для шару y=f(x,w) чутливість вгору до y комбінується з частковими похідними, щоб отримати чутливості для x і w. Зворотне поширення обчислює градієнти; оптимізатор вирішує, як змінюються параметри.
Простий афінний шар генерує y=Wx+b. Градієнт для W — це зовнішній добуток градієнту, що надходить з вищого рівня, і входу, градієнт для b — сума значень з вищого рівня, а градієнт входу множиться на транспоновану матрицю ваг. Активації додають покоординатні похідні. Згортка, нормалізація, увага та рекурентне повторне використання слідують тому ж принципу графу, але вимагають правильних форм тензорів, трансляції, маскування та спільного використання параметрів. Фреймворки звільняють збережені активації після зворотного проходу, якщо їх не утримують, тому пам’ять часто зростає зі збільшенням розміру пакету, глибини та довжини послідовності.
Помилки градієнтів, верифікація та інженерна практика
Добутки багатьох похідних можуть зникати або вибухати. Активації типу ReLU, ретельна ініціалізація, нормалізація, залишкові зв’язки, гейтування та обрізка градієнтів вирішують різні механізми. Насичені активації та недиференційовані операції можуть блокувати корисні сигнали; скорочене зворотне поширення обмежує історію послідовності; змішана точність може під overflow без масштабування втрат. Вибухаючі градієнти — це симптом, тому обрізка має супроводжуватись дослідженням швидкості навчання, даних, архітектури та числових помилок, а не їх приховуванням.
Перевіряйте користувацькі операції за допомогою перевірки градієнтів скінченними різницями на малих входах подвійної точності, уникаючи недиференційованих точок. Перевіряйте норми градієнтів, NaN, неактивні параметри та чи досягають градієнти очікуваних модулів. Намірено очищайте накопичені градієнти та розрізняйте поведінку під час навчання та оцінки для dropout та нормалізації. Контрольні точки переобчислюють активації для економії пам’яті; розподілене навчання має послідовно агрегувати градієнти. Зменшення втрати під час навчання показує, що існує шлях оптимізації, а не те, що градієнти концептуально правильні, дані без витоків або модель узагальнює.
Практичний приклад: верифікація користувацького нейронного шару
Інженер реалізує диференційований спектральний шар для аудіо‑мережі. Маленький тест подвійної точності порівнює автоматичні градієнти з центральними скінченними різницями по входах і параметрах, виключаючи точки, де операція навмисно недиференційована. Форми, трансляція, заповнення та перетворення комплексного у реальне розглядаються окремо. Тест верифікує накопичені градієнти, коли параметр використовується повторно, і підтверджує, що замасковані аудіофрейми не генерують градієнт.
Під час навчання панелі інструментів відстежують норми градієнтів і активацій, NaN, неактивні параметри та масштабування втрат. Навмисно пошкоджений пакет підтверджує, що валідація виявляє не скінченний вихід до оновлення оптимізатора. Змішана точність та експортовані реалізації порівнюються з еталоном. Тести відновлення контрольних точок включають стан оптимізатора та випадковий порядок. Шар не приймається лише тому, що загальна втрата зменшується; одиничні градієнти, числова стабільність та подальша генералізація повинні надати послідовні докази.
Докази впровадження та готовність до експлуатації
Рішення про впровадження потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, входи, виходи, залежності, власника та наслідки кожного важливого збою. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректні або відсутні входи, зсув розподілу, відмову залежностей, неправильне використання та групи або середовища, які, ймовірно, залишаються без підтримки. Оцінюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, витратами ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та відсторонення. Використовуйте поетапний розгортання, зберігайте безпечний резерв і перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія повинна виявляти якість входу, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться стабільною. Переглядайте знову, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання чи цілі. Підтримувана система також потребує документованого відновлення, навчання на інцидентах, процедур видалення та зберігання, а також чіткої точки, коли її слід вимкнути або замінити.
Часті запитання
Чи оновлює зворотне поширення ваги?
Зворотне поширення обчислює градієнти. Оптимізатор застосовує оновлення, використовуючи ці градієнти, свою швидкість навчання та, можливо, стан, такий як моментум або адаптивні моменти.
Чи є зворотне поширення біологічно реалістичним?
Стандартне зворотне поширення — це інженерний алгоритм і не вважається детальною моделлю навчання в біологічних мозках. Історична нейронна аналогія не повинна розглядатися як біологічна еквівалентність.
Основні джерела












