
Основи ШІ
Що таке розпізнавання розмовної мови (CSR)?

 Додайте Unite.AI до бажаних джерел у Google
Розпізнавання розмовної мови (CSR) розширює автоматичне розпізнавання мови (ASR), виходячи за межі окремих транскрипцій, використовуючи контекст діалогу, сигнали чергування, інформацію про мовця та обробку з низькою затримкою. Мета – підтримувати живу взаємодію, у якій важливі слова, таймінг, переривання та попередні репліки.
CSR – це нова назва продукту та досліджень, а не єдиний стандартизований клас моделей. Потужна система поєднує потокове ASR з визначенням кінцевих точок, обробкою мовців, контекстуальним мовним моделюванням, станом діалогу та політикою відповіді, а потім оцінює досвід від початку до кінця.
Основні висновки
- Потокове розпізнавання генерує попередні гіпотези та коригує їх у міру надходження нових аудіо даних.
- Визначення кінцевих точок та передбачення чергування окремі від точності транскрипції.
- Історія розмови та «гарячі слова» можуть покращити розпізнавання, але також поширювати раніше допущені помилки.
- Оцінюйте затримку, переривання, мовців, акценти, шум, конфіденційність та завершення завдань — а не лише рівень помилок у словах.
Від ASR до живого діалогу
Традиційне ASR перетворює аудіо в текст. Розмовна система повинна вирішувати, коли слухати, коли репліка завершена, чи спрямована мова до системи, і як відновитися, коли її транскрипція або відповідь неправильна.
Потокові моделі обробляють кадри інкрементально та створюють часткові транскрипції. Низька затримка підвищує реактивність, проте передчасне фіксування може збільшити кількість виправлень чи помилок. Додатку потрібна політика щодо стабільного та попереднього тексту.
Чергування, накладання та мовці
Тривалість тиші сама по собі є слабким сигналом кінцевої точки. Лексичне завершення, інтонація, таймінг, погляд та стан діалогу можуть допомогти передбачити, чи користувач утримує чи віддає слово. Переривання (barge‑in) дозволяє користувачеві перервати синтезовану мову, не втрачаючи контекст.
Накладання голосів та діаризація залишаються складними. Системи мають зберігати невизначеність щодо мовця, уникати приписування висловлювання неправильній особі та забезпечувати шлях виправлення — особливо для записів, що використовуються в охороні здоров’я, фінансах чи юридичній сфері.
Контекстуальне розпізнавання
Попередні репліки можуть уточнювати імена та посилання; списки «гарячих слів» можуть схилити розпізнавання в бік термінів галузі. Моделі мовлення можуть кодувати аудіо‑ та текстовий контекст у спільному механізмі підказок або уваги.
Контекст також може підкріпити помилкову попередню транскрипцію або протікати інформацію між сесіями. Обмежте історію поточним завданням, розділяйте довірені метадані та мову користувача, і використовуйте контекст трансформера з чіткими правилами збереження та доступу.
Оцінка та відповідальне впровадження
Повідомляйте про потоковий рівень помилок слів, затримку першого токену та фіналізації, частоту виправлень, помилки кінцевих точок, успішність переривання (barge‑in), приписування мовців та завершення завдань. Тестуйте реальні мікрофони, шум, акценти, перемикання мов, інвалідність та емоційно заряджену мову.
Голосові дані можуть ідентифікувати або розкривати конфіденційну інформацію. Застосовуйте згоду, мінімізацію, шифрування, обмеження зберігання та людський перегляд. Підключайте згенеровані відповіді до засобів безпеки чат‑бота, оскільки точна транскрипція не робить відповідь правильною чи уповноваженою.
Від акустичного входу до стану розмови
Система розмовного розпізнавання захоплює аудіо, виконує обробку сигналу, виявляє мову, розпізнає слова або семантичні одиниці, за потреби ідентифікує мовців та оновлює стан діалогу. Потокові системи генерують часткові гіпотези до завершення вимови. Ці гіпотези можуть змінюватися, тому наступні компоненти повинні розрізняти попередні та остаточні результати.
Виявлення голосової активності та визначення кінцевих точок вирішують, коли починається мова і коли користувач закінчив. Фіксовані пороги тиші не працюють з повільними мовцями, фоновим шумом та паузами на роздуми. Моделі чергування можуть використовувати слова, інтонацію, погляд та контекст діалогу, проте вони мають балансувати швидку реакцію та недопущення переривання мовця.
Діаризація відповідає на питання, хто говорив коли; розпізнавання мовця оцінює ідентичність; розділення джерел ізолює накладені голоси. Це різні завдання з різними ризиками. На засіданнях, у охороні здоров’я та обслуговуванні клієнтів правильне приписування слів правильній особі може бути так само важливим, як і рівень помилок у транскрипції.
Контекст, накладання, емоції та відновлення взаємодії
Контекст розмови розв’язує займенники, еліпсис, виправлення, галузеві терміни та посилання на попередні репліки. Система може поєднувати акустичні докази з історією діалогу та отриманими знаннями, проте попередній контекст може також схилити розпізнавання до неправильного очікування. Зберігайте аудіо‑докази та впевненість, щоб контекст не стиха переписував невизначеність.
Натуральна розмова включає зворотні сигнали, переривання, хибні стартові фрази, сміх, перемикання мов та одночасну мову. Відповідальний агент потребує обробки переривань (barge‑in): зупинити або знизити вихід, захопити нову мову користувача, визначити, чи змінює переривання намір, і відновитися без дублювання чи втрати дії.
Інтонація та паралінгвістичні сигнали можуть вказувати на наголос чи невпевненість, проте виведення емоцій, стану здоров’я чи наміру з голосу схильне до помилок і залежить від культури. Використовуйте такі оцінки обережно, розкривайте їх за потреби і не приймайте важливих рішень на підставі неперевіреної емоційної мітки.
Оцінка, конфіденційність та проектування у виробництві
Рівень помилок слів залишається корисним, проте оцінка розмови має також вимірювати приписування мовців, точність сутностей, успішність семантичних завдань, стабільність часткових гіпотез, затримку кінцевих точок, успішність переривань, відновлення та частоту виправлень користувачем. Сегментуйте за акцентом, мовою, пристроєм, шумом, накладанням, стилем мовлення та умовами мережі.
Потокова архітектура потребує обмежених буферів, зворотного тиску, повторного підключення, номерів послідовності та явної фіналізації. Тримайте окремими бюджети затримки моделі та діалогу, відстежуйте кожен етап і тестуйте погіршені мережі. Коли система ініціює дії, підтверджуйте інтенцію високого впливу та робіть повтори ідемпотентними, щоб повторне аудіо або повторне підключення не дублювали транзакції.
Мова містить ідентифікаційну, змістову, середовищну та інформацію про оточуючих. Мінімізуйте зберігання, шифруйте передачу та сховище, контролюйте доступ, визначайте правила видалення та розрізняйте аудіо від отриманих транскриптів і векторних представлень. Забезпечте видимі індикатори запису та альтернативи, коли відсутня згода. Локальна модель може зменшити передачу даних, проте все одно потребує дозволу та контролю життєвого циклу.
Практичний приклад: голосовий агент, що обробляє переривання та виправлення
Абонент каже: «Забронювати вівторок — ні, середу після обіду», коли агент уже починає відповідати після слова «вівторок». Потокове розпізнавання випускає змінювані часткові транскрипції, визначення кінцевих точок виявляє продовження мови, а переривання (barge‑in) зупиняє виведення. Стан діалогу позначає попередню дату як замінену, а не створює два запити. Підтвердження сутності зосереджується на виправленій даті та часі, при цьому система зберігає впевненість та докази для остаточної інтерпретації.
Архітектура розділяє захоплення аудіо, виявлення мови, потокове розпізнавання, обробку мовців, політику діалогу, виконання інструменту та синтез. Номери послідовності та фіналізація запобігають перезапису остаточної транскрипції пізніми частковими результатами. Інструмент бронювання приймає структурований запит, перевіряє авторизацію та доступність і використовує ключ ідемпотентності. Наслідкова бронювання читається назад і підтверджується перед виконанням; повторне підключення не може тихо повторити його.
Тестування поєднує точність слів та сутностей із затримкою кінцевих точок, успішністю переривань, обробкою виправлень, приписуванням мовців, завершенням завдань та рівнем дублювання дій. Сценарії охоплюють шум, накладання, акценти, перемикання мов, повільну мову, допоміжні пристрої, слабкі мережі та синтетичні атаки. Зберігання аудіо мінімізується та розкривається, дані оточуючих обробляються явно, а користувачі можуть переключитися на текст або живу людину. Розмовний інтелект вимірюється безпечним відновленням та результатом, а не лише точністю транскрипції.
Практичний чек‑лист впровадження
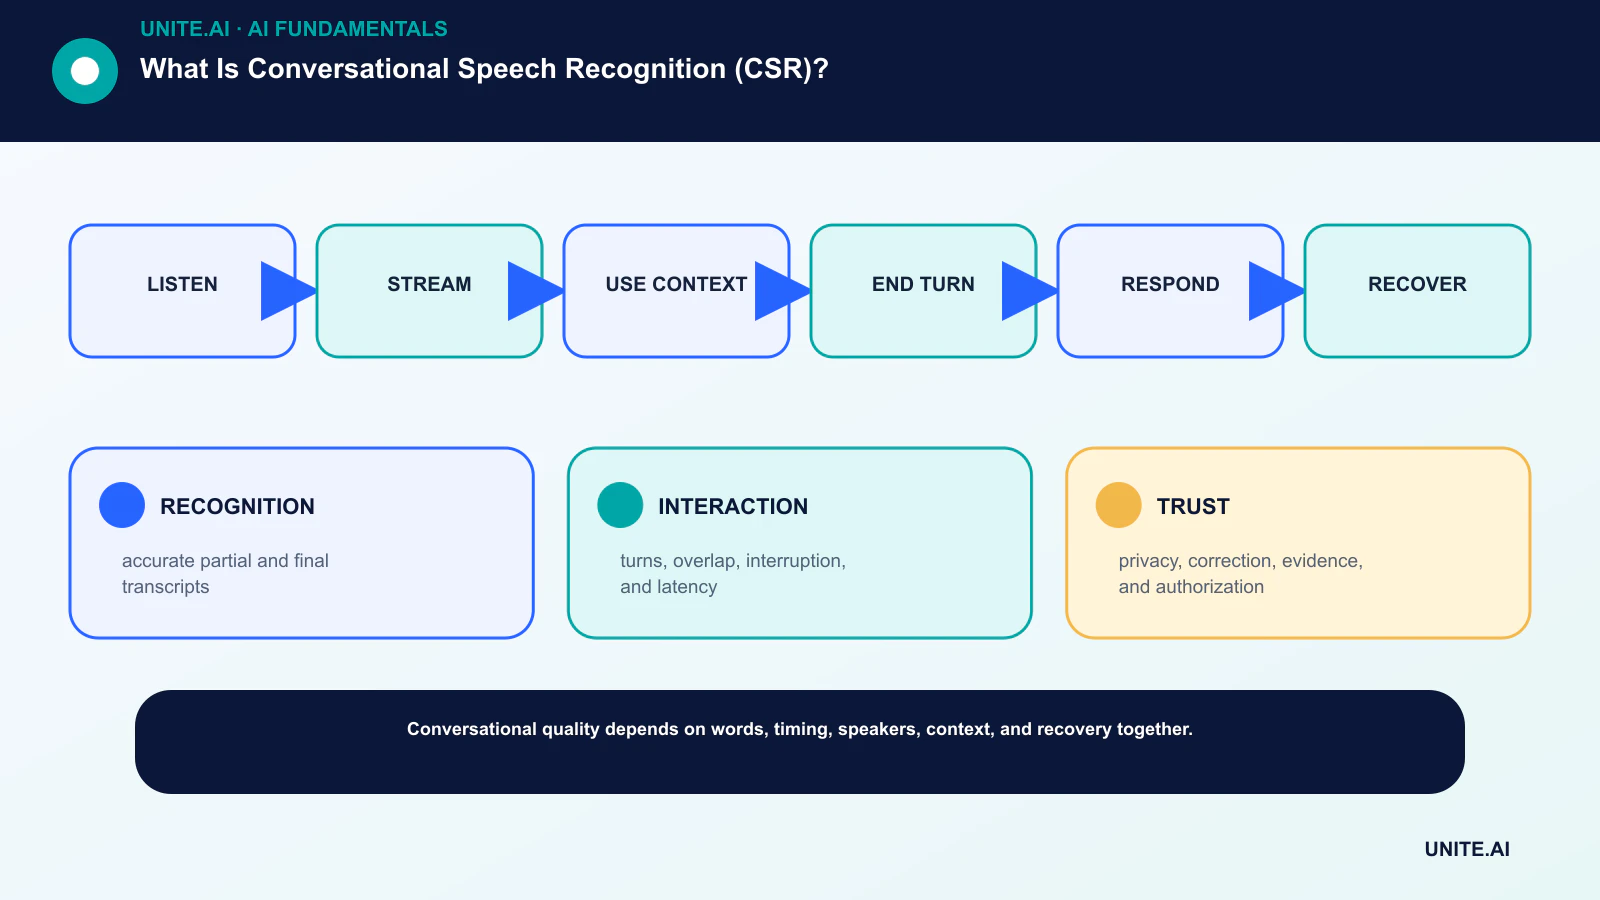
Перетворіть концепцію у визначений, тестований робочий процес: слухати → потоково → використовувати контекст → завершити чергу → відповісти → відновити. Призначте відповідального, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте типові відмови та визначте моніторинг, відкат і перегляд перед розширенням сфери. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності за участю людей, які створюють, експлуатують, захищають та підлягають впливу системи. Тестуйте звичайні випадки, граничні умови, відмови залежностей та зловживання; зберігайте докази та невирішені ризики. Визначте, хто може затвердити випуск, змінити поріг, перевизначити вихід або зупинити роботу. Перегляньте рішення після надходження реальних даних, оскільки технічно успішний пілот не гарантує надійної роботи в масштабі.
- РОЗПІЗНАВАННЯ: точні часткові та остаточні транскрипції.
- ВЗАЄМОДІЯ: чергування, накладання, переривання та затримка.
- ДОВІРА: конфіденційність, виправлення, докази та авторизація.
Часті запитання
Чи відрізняється CSR від ASR?
ASR — це компонент перетворення мови в текст. CSR використовує ASR разом із контекстом діалогу, таймінгом, обробкою мовців та кінцевих точок, а також політиками взаємодії для живої розмови.
Чи нижчий рівень помилок слів гарантує кращого голосового агента?
Ні. Система може точно транскрибувати, але при цьому переривати користувачів, реагувати повільно, помилково приписувати висловлювання іншим мовцям або виконувати неправильну дію. Потрібні метрики взаємодії від початку до кінця.
Основні джерела












