
Fondamenti di IA
Che cos’è l’apprendimento automatico?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Apprendimento automatico (ML) è un ramo dell’intelligenza artificiale in cui un sistema apprende schemi dai dati così da poter effettuare previsioni, classificazioni, raccomandazioni o decisioni senza che uno sviluppatore scriva una regola separata per ogni caso possibile. Il risultato non è una macchina che “pensa” come una persona. È un modello statistico che mappa gli input a output utili e può essere valutato su dati non visti durante l’addestramento.
L’apprendimento automatico è inserito nel più ampio campo dell’IA, mentre apprendimento profondo è una famiglia di metodi di machine learning basati su reti neurali a più strati. Questa distinzione è importante: non tutti i sistemi di IA usano il ML e non tutti i problemi di ML richiedono una rete neurale.
Key takeaways
- Il ML apprende una relazione dagli esempi invece di basarsi solo su regole scritte a mano.
- Un modello utile deve generalizzare a nuovi dati, non limitarsi a memorizzare il set di addestramento.
- Apprendimento supervisionato, non supervisionato, semi-supervisionato, auto-supervisionato e di rinforzo risolvono diversi tipi di problemi.
- Qualità dei dati, progettazione della valutazione e monitoraggio sono importanti quanto l’algoritmo.
How machine learning works
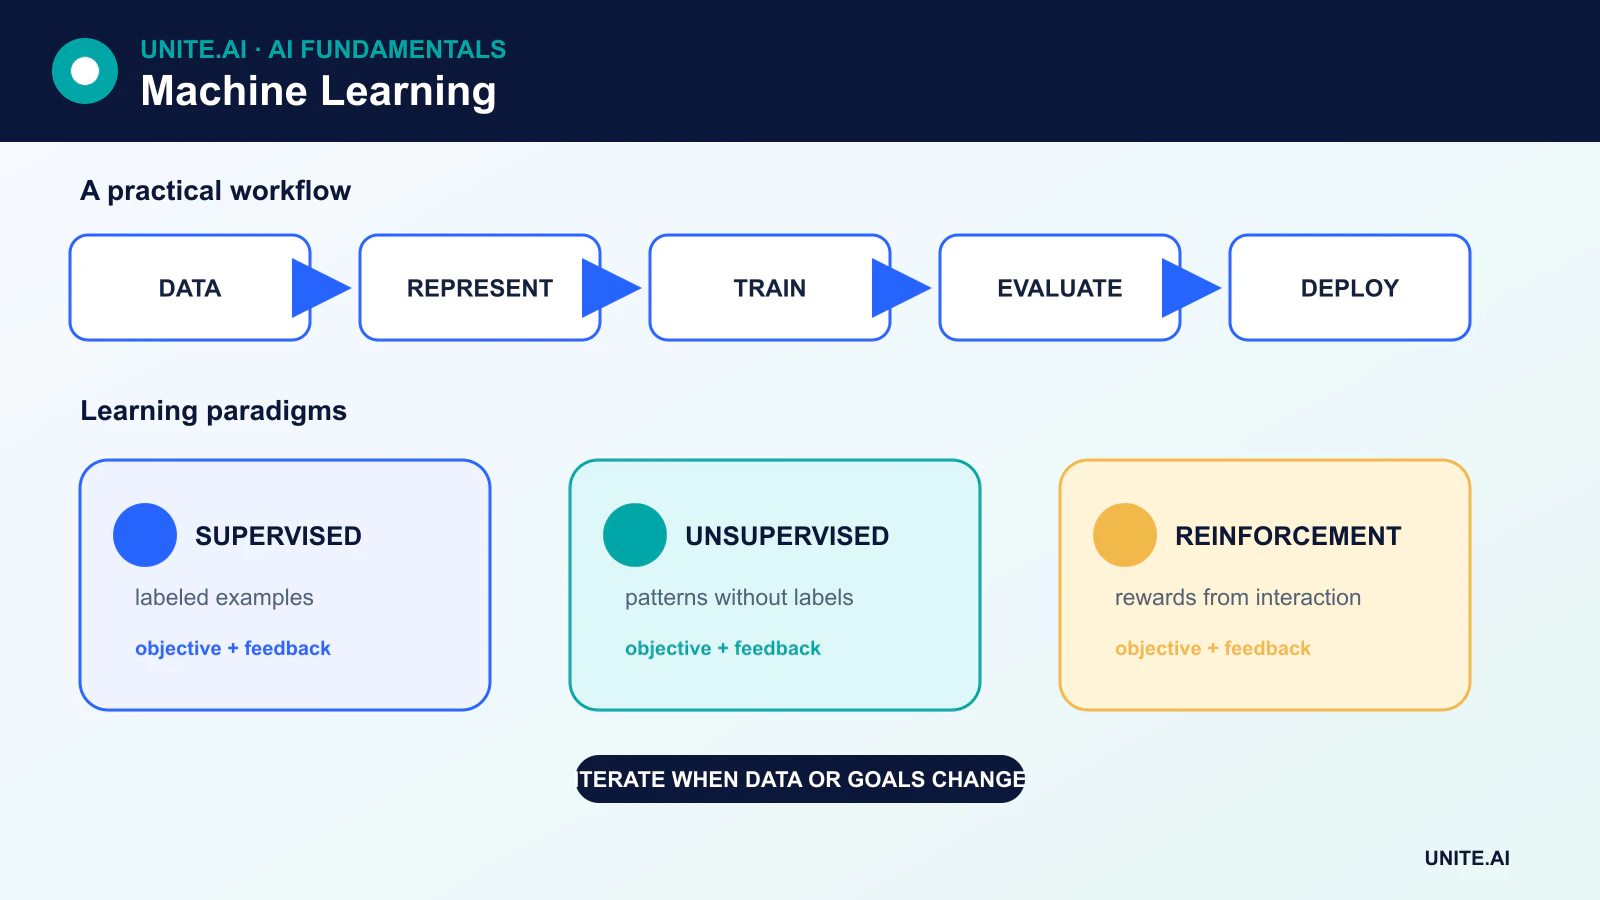
La maggior parte dei progetti di ML può essere compresa come una sequenza di sei fasi:
- Definire il compito. Decidere cosa il sistema dovrebbe prevedere o scoprire e cosa significhi il successo nell’applicazione reale.
- Raccogliere e preparare i dati. Pulire i record, gestire i valori mancanti, creare caratteristiche utili e documentare la provenienza dei dati.
- Dividere i dati. Un set di addestramento è usato per adattare il modello, un set di validazione aiuta a selezionare le impostazioni e un set di test fornisce una stima finale su dati non toccati.
- Addestrare il modello. Un algoritmo regola i parametri del modello per ridurre una funzione di perdita o soddisfare un altro obiettivo di apprendimento.
- Valutare la generalizzazione. Le metriche devono riflettere il compito, il bilanciamento delle classi, i costi degli errori e la popolazione su cui il modello opererà.
- Distribuire e monitorare. I dati del mondo reale possono cambiare, quindi i team monitorano il drift, il degrado delle prestazioni, i bias e i guasti operativi.
Le variabili fornite a un modello sono comunemente chiamate caratteristiche. Nell’apprendimento supervisionato, la risposta desiderata è chiamata etichetta o obiettivo. I parametri appresi da un modello codificano una relazione tra le caratteristiche e l’output; non sono un database di regole esplicite.
The main learning paradigms
Supervised learning
In apprendimento supervisionato, gli esempi includono sia gli input sia i target noti. Un modello di classificazione prevede categorie, ad esempio se una transazione è fraudolenta. Un modello di regressione prevede un valore continuo, come la domanda energetica prevista.
Gli algoritmi supervisionati più comuni includono alberi decisionali, macchine a vettori di supporto, K-nearest neighbors, regressione lineare e logistica, alberi potenziati a gradiente e reti neurali. Una soglia di classificazione come 0,5 è una decisione scelta dopo che il modello produce un punteggio o una probabilità; non è una proprietà immutabile della regressione logistica.
Unsupervised learning
L’apprendimento non supervisionato lavora con dati che non includono etichette di target. L’obiettivo può essere trovare cluster, rilevare osservazioni anomale, stimare una distribuzione o creare una rappresentazione a dimensione inferiore. Un cluster è un gruppo suggerito da una regola di similarità; non è automaticamente una classe reale significativa.
Esempi includono clustering K-means, analisi delle componenti principali, stima della densità e alcune forme di autoencoder. Un autoencoder impara a ricostruire il proprio input attraverso una rappresentazione compressa. Non crea automaticamente etichette di verità a terra.
Semi-supervised and self-supervised learning
Apprendimento semi-supervisionato combina un piccolo set etichettato con un più ampio set non etichettato. Apprendimento auto-supervisionato crea un segnale di addestramento dai dati stessi — ad esempio prevedendo parole mascherate o abbinando due viste trasformate della stessa immagine. L’auto-supervisione è centrale in molte moderne pipeline di transformer e di modelli di base perché può utilizzare grandi collezioni di testo, immagini, audio o video senza che una persona etichetti ogni esempio.
Reinforcement learning
In apprendimento per rinforzo, un agente compie azioni in un ambiente e riceve ricompense o costi. L’obiettivo è apprendere una politica che massimizzi la ricompensa cumulativa attesa. Questo differisce dall’apprendimento supervisionato perché l’azione corretta non è fornita per ogni stato, e un’azione può influenzare quali dati l’agente incontrerà successivamente.
Training, validation, and generalization
Un modello che performa bene sui propri esempi di addestramento può comunque fallire su nuovi dati. Questo fallimento è noto come overfitting. I team lo riducono tramite capacità del modello adeguata, regolarizzazione, cross‑validation, data augmentation, prevenzione di leakage e un set di test realmente indipendente.
Non esiste una singola metrica per ogni compito di ML. La classificazione può richiedere precisione, recall, F1, calibrazione o una misura ponderata per costi invece della semplice accuratezza. La regressione può usare errore medio assoluto, radice dell’errore quadratico medio o una perdita specifica del dominio. Il clustering necessita di forme diverse di valutazione interna o esternamente validata. La metrica dovrebbe riflettere ciò che un errore significa per l’utente o l’organizzazione.
Machine learning algorithms are tools, not guarantees
Un algoritmo porta con sé assunzioni. I modelli lineari assumono una forma particolare di relazione. K-nearest neighbors assume che la distanza selezionata rappresenti una similarità significativa. Naive Bayes assume che le caratteristiche siano condizionatamente indipendenti dato la classe. Gli alberi decisionali partizionano lo spazio delle caratteristiche usando regole di split apprese; le loro foglie contengono previsioni basate su gruppi di osservazioni di addestramento piuttosto che su una singola osservazione ciascuna.
La scelta del modello dipende quindi dalla dimensione dei dati, dal tipo di caratteristiche, dai requisiti di latenza, dalle necessità di interpretabilità e dal costo degli errori. Un modello più semplice può superare un modello più grande quando i dati sono limitati o le restrizioni operative favoriscono velocità e trasparenza.
Where machine learning is used
Il ML supporta ranking di ricerca, raccomandazioni, previsioni, rilevamento di anomalie, traduzione, riconoscimento vocale, visione artificiale, manutenzione predittiva, rilevamento di frodi e analisi scientifica. Le stesse tecniche possono anche amplificare bias storici, esporre informazioni sensibili o comportarsi in modo imprevedibile sotto shift di distribuzione. Una distribuzione responsabile richiede documentazione, supervisione umana dove opportuno, test di sicurezza e monitoraggio continuo.
From problem definition to a valid machine-learning experiment
Un progetto di machine learning dovrebbe iniziare con una decisione e un risultato misurabile, non con un algoritmo. Definire l’unità di previsione, il target, il tempo di osservazione, il tempo di decisione, le caratteristiche disponibili e il costo di ogni errore. Per un modello di churn, ad esempio, usare eventi registrati dopo la cancellazione introdurrebbe una perdita di informazione. Stabilire una regola semplice o una baseline statistica, quindi dividere i dati per tempo, cliente, località o altro confine che rifletta il deployment. Divisioni casuali delle righe possono collocare osservazioni quasi identiche nei set di addestramento e test, producendo un punteggio fuorviante.
L’ingegneria delle caratteristiche converte i record grezzi in rappresentazioni utilizzabili dal modello, ma ogni caratteristica necessita di provenienza e garanzia di disponibilità. Normalizzare, costruire vocabolari, imputare e ridurre la dimensionalità solo sui dati di addestramento, per poi applicare la trasformazione appresa a validazione e test. La cross‑validation stima la variazione tra campioni; un set di test finale non toccato supporta la decisione di rilascio. Selezionare metriche in base alle conseguenze: precisione e recall per errori di classificazione squilibrati, calibrazione quando le probabilità guidano azioni, e misure ponderate per costi o utilità quando gli errori hanno effetti operativi differenti.
Deployment, monitoring, and responsible operation
L’inferenza in produzione ripete l’intera trasformazione effettuata in fase di addestramento e restituisce una previsione entro i vincoli di latenza, throughput e disponibilità. Impacchettare il preprocessing con il modello, convalidare gli schemi di input, versionare gli artefatti e confrontare i risultati tra implementazioni offline e di serving. Scegliere una soglia usando la capacità operativa e il trade‑off di errore piuttosto che defaultare a 0,5. Rilasciare tramite valutazione shadow, una coorte limitata o un esperimento con metriche di guardrail. Mantenere un fallback deterministico e un percorso di rollback per guasti di dipendenze o comportamenti inaccettabili.
Monitorare la qualità dell’input, il drift delle caratteristiche, la distribuzione delle previsioni, la calibrazione, gli esiti per sottogruppi, latenza, costo e le etichette confermate quando arrivano. Il drift è un segnale da investigare, non una prova automatica che il retraining aiuterà. Il retraining richiede dati revisionati, test riproducibili, approvazione e confronto con il modello corrente. Documentare usi previsti e non validi, diritti sui dati, privacy, sicurezza, override umano e ricorso dove le persone sono coinvolte. Il machine learning è un sistema decisionale mantenuto; il file del modello è solo un componente sostituibile.
Worked example: predicting equipment failure
Un produttore definisce una previsione per macchina‑giorno: se un guasto verificato si verificherà entro sette giorni usando solo i dati di telemetria disponibili all’inizio di quel giorno. Divide per macchina e tempo, confronta con regole basate su età e soglie, adatta il preprocessing sui dati di addestramento e valuta recall degli eventi, falsi allarmi, tempo di preavviso, calibrazione e capacità di manutenzione. La sostituzione dei sensori e le chiusure programmate sono modellate come contesto operativo anziché trattate come osservazioni ordinarie.
Il modello prima gira in modalità shadow. Gli avvisi mostrano la telemetria contributiva e l’incertezza, ma i manutentori decidono se ispezionare. I risultati e le cause confermate diventano etichette governate; l’assenza di un ordine di lavoro non è assunta come assenza di guasto. Un rollout a tappe utilizza limiti di avviso e un fallback manuale, mentre il monitoraggio traccia salute dei sensori, drift di input, precisione revisionata, tempi di inattività e manutenzione non necessaria. Il retraining avviene solo dopo che la revisione dei dati e delle soglie dimostra un probabile miglioramento rispetto al sistema attualmente distribuito.
Implementation evidence and operational readiness
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e la conseguenza di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testare casi ordinari, condizioni limite, input malformati o mancanti, shift di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più probabilmente sottoserviti. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere evidenza da un prototipo attraente.
Prima del lancio, assegnare autorità per rilascio, eccezioni, modifiche, rollback e ritiro. Utilizzare un rollout a tappe, preservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare qualità dell’input, comportamento dell’output, versione del modello o della regola, salute delle dipendenze, override umani e risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di avviso e un responsabile della risposta, quindi rivedere le evidenze reali dopo il deployment anziché assumere che le prestazioni offline persistano. Rivalutare ogniqualvolta fonti dati, utenti, modelli, fornitori, politiche, hardware o obiettivi cambiano. Un sistema mantenuto necessita anche di documentazione su recupero, apprendimento da incidenti, procedure di cancellazione e conservazione, e un punto chiaro in cui debba essere disattivato o sostituito.
Primary references












