
Fondamenti di IA
Modelli di Machine Learning Pronti all’Uso vs. Personalizzati

 Aggiungi Unite.AI alle tue fonti preferite su Google
Scegliere una soluzione di machine learning raramente è una semplice decisione di comprare o costruire. Il vero continuum va da un’API ospitata o da un modello confezionato, passando per il prompting, il recupero e il fine‑tuning, fino a un’architettura completamente personalizzata addestrata su dati specifici dell’organizzazione.
L’opzione migliore è l’approccio meno complesso che soddisfa un requisito di prodotto verificato. Un modello personalizzato può offrire controllo e differenziazione, ma comporta anche un obbligo continuo di gestire pipeline di dati, valutazioni, monitoraggio, sicurezza, aggiornamenti e rollback.
Punti chiave
- Iniziare con un compito misurabile, una baseline non‑ML e soglie di accettazione.
- Valutare i modelli candidati su dati privati rappresentativi piuttosto che solo sui punteggi dei benchmark pubblici.
- Includere i costi di integrazione, latenza, revisione, riaddestramento e incidenti nel costo totale di proprietà.
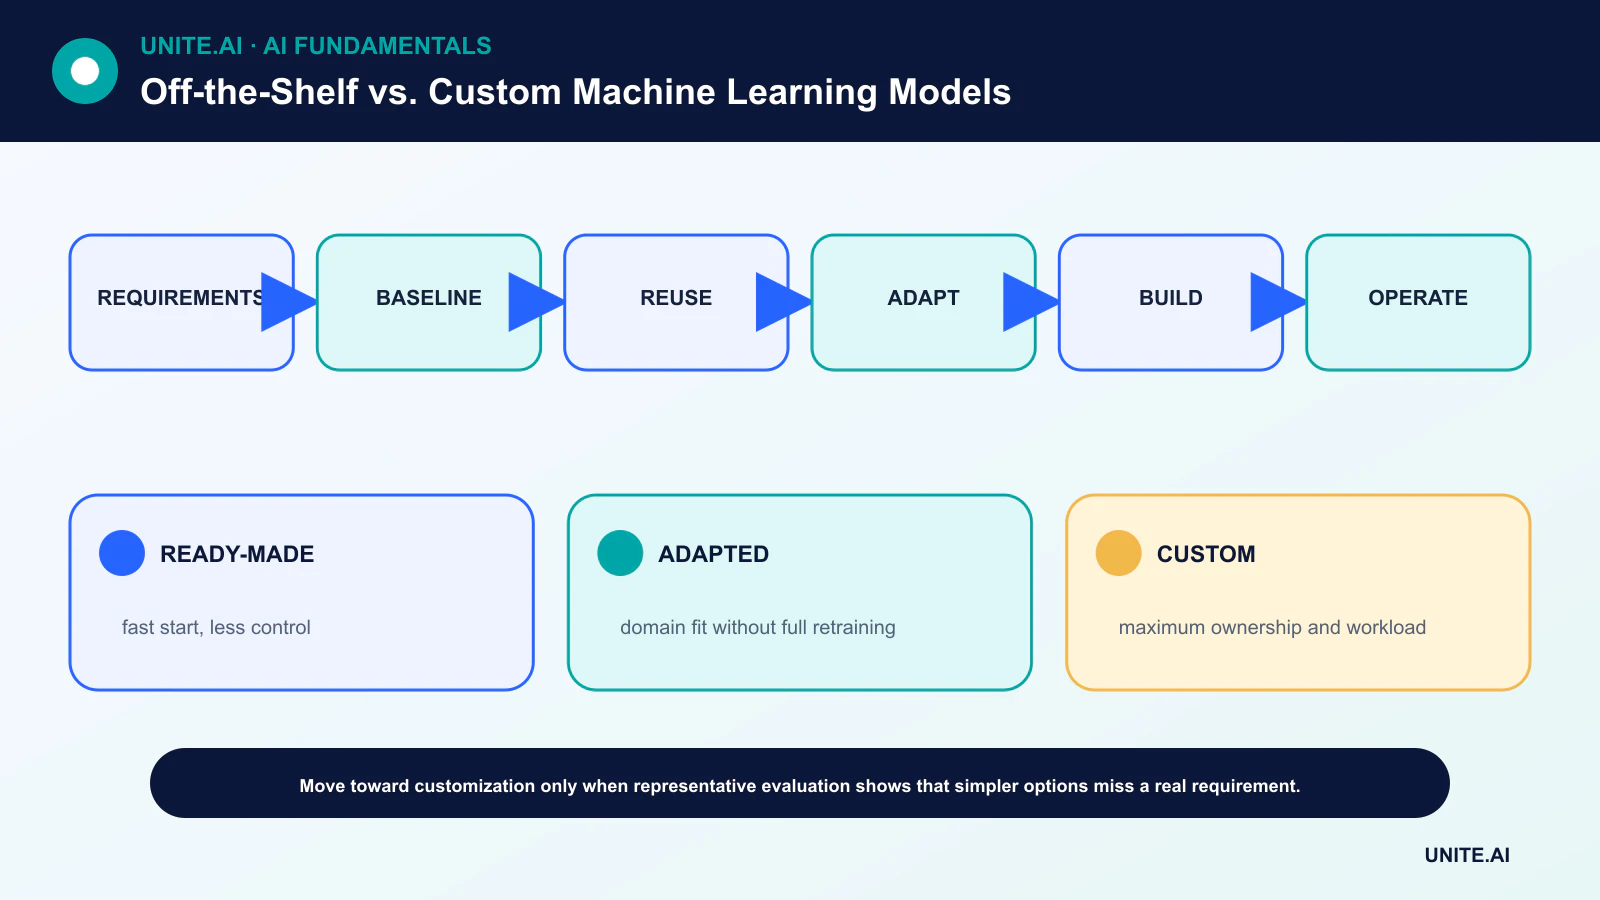
- Preferire fasi reversibili: baseline, recupero o prompting, fine‑tuning, quindi addestrare da zero solo quando le evidenze lo supportano.
Definire la decisione prima di scegliere un modello
Specificare l’utente, la decisione, l’input, l’output, i costi di errore, il budget di latenza, il modello di traffico e il percorso di escalation. Determinare se una regola deterministica o un sistema di ricerca risolve una parte sufficiente del problema. Le Regole di ML di Google raccomandano baseline semplici e un’infrastruttura affidabile prima di modellare in modo complesso.
Creare un set di valutazione offline che rifletta la produzione, includendo casi rari e avversari. Quando le decisioni influenzano le persone, definire controlli di sottogruppo e regole di revisione umana. Queste barriere rendono i confronti concreti invece di trasformare la scelta dell’architettura in una preferenza.
Il continuum di riuso e adattamento
Un’API ospitata offre integrazione rapida e scalabilità gestita, ma un controllo limitato sugli internals del modello, versioni e gestione dei dati. Un modello preaddestrato aperto aumenta il controllo del deployment. Il recupero o il prompt engineering può aggiungere contesto di dominio senza modificare i pesi.
Il fine‑tuning o gli adattatori a efficienza parametrica possono specializzare il comportamento. L’addestramento da zero è giustificato solo quando i dati, l’obiettivo, la scala o i requisiti di proprietà non possono essere soddisfatti tramite il riuso. Il transfer learning spesso cattura la maggior parte del valore con significativamente meno dati e calcolo.
Qualità, controllo e lock-in
Misurare la qualità del compito, la calibrazione, la latenza, il throughput, la disponibilità e la coerenza dei fallimenti. Un modello fornito da un vendor può migliorare automaticamente ma può anche cambiare comportamento; un modello auto‑ospitato può essere fissato ma richiede al team di gestire aggiornamenti e vulnerabilità.
I termini contrattuali dovrebbero affrontare la conservazione dei dati, l’uso per l’addestramento, l’elaborazione regionale, la proprietà intellettuale, i livelli di servizio, i percorsi di esportazione e la deprecazione. La portabilità migliora quando l’applicazione separa gli adattatori specifici del modello dalla logica di business e conserva artefatti di valutazione riproducibili.
Privacy, sicurezza e operazioni
Mappare ogni flusso di dati e confine di minaccia. Input sensibili possono richiedere una rete privata, inferenza on‑premise o edge AI. L’auto‑hosting non rende automaticamente un sistema sicuro; trasferisce la responsabilità di sicurezza e conformità all’operatore.
La proprietà della produzione include osservabilità, controlli di drift, monitoraggio degli abusi, risposta agli incidenti e rollback. Il team operativo deve poter rispondere a quale modello, prompt, versione dei dati e politica hanno prodotto un risultato.
Usare prove a tappe, non ideologia
Eseguire un benchmark a tempo limitato con lo stesso dataset e criteri di accettazione su tutte le opzioni. Stimare il tempo di ingegneria, l’annotazione, l’uso di acceleratori, le tariffe del vendor, il lavoro di revisione, i costi dei fallimenti e la cadenza prevista dei cambiamenti.
Scegliere il candidato più semplice che supera le barriere, quindi rivalutare man mano che i requisiti o i prezzi cambiano. La personalizzazione è preziosa quando produce un beneficio misurato o un controllo necessario — non solo perché un modello su misura suona strategicamente importante.
Requisiti e confronto dei costi totali
Un modello pronto all’uso, un’API o un sistema confezionato fornisce capacità predefinite con supporto del vendor e una più rapida implementazione iniziale. Un modello personalizzato è addestrato o sostanzialmente adattato per un compito specifico, dati e ambiente operativo. La scelta inizia con i requisiti: risultato target, qualità per sottogruppo e casi limite, latenza, throughput, disponibilità, spiegabilità, residenza dei dati, controllo degli aggiornamenti, integrazione, sicurezza e conseguenza dei fallimenti. Un benchmark o demo generico non può rispondere se un prodotto soddisfa tali requisiti.
Il costo totale include valutazione, preparazione dei dati, etichettatura, integrazione, licenze o utilizzo, infrastruttura, monitoraggio, revisione, risposta agli incidenti, aggiornamenti e uscita. Il pronto all’uso riduce l’ingegneria iniziale ma può generare costi variabili, lock‑in, cambiamenti di comportamento e osservabilità limitata. Lo sviluppo personalizzato aggiunge responsabilità di dati e MLOps e può comunque dipendere da pesi preaddestrati e vendor. Il costo del modello dovrebbe essere misurato per compito completato con la qualità richiesta, non per token o singola esecuzione di addestramento.
Valutazione, approvvigionamento e adattamento
Costruire un set di test privato rappresentativo prima della selezione del vendor e far girare ogni candidato con prompt, pre‑elaborazione, soglie e limiti operativi identici. Includere casi ambigui, avversari, non supportati, multilingue e ad alta conseguenza. Misurare accuratezza, calibrazione, latenza, costo, rifiuto, sicurezza e impatto sul flusso di lavoro umano. Testare interruzioni dell’API, limiti di velocità, comportamento regionale e cambiamento di versione. Le affermazioni del vendor richiedono documentazione per addestramento, diritti, privacy, conservazione, sub‑processori, sicurezza, supporto e notifica di incidenti.
Le opzioni di adattamento formano uno spettro: configurazione, recupero, prompting, fine‑tuning, aggiornamenti a efficienza parametrica, testate personalizzate o addestramento da zero. Usare il metodo meno complesso che soddisfa le evidenze. Il recupero è appropriato per conoscenza che cambia frequentemente; il tuning può modellare formato o comportamento di dominio; il codice deterministico dovrebbe gestire regole esatte. Convalidare i sistemi combinati perché un modello di base forte può comunque fallire a causa di recupero scadente, permessi o integrazione.
Pianificazione del ciclo di vita e dell’uscita
I prodotti ospitati possono cambiare o scomparire, mentre i modelli personalizzati diventano debito tecnico senza proprietari. Monitorare le dipendenze di versione, il comportamento e i risultati, definire trigger di riaddestramento o rivalutazione e mantenere il rollback. Conservare i dati e le interfacce necessarie per migrare, negoziare cancellazione ed esportazione, ed evitare di esporre lo schema proprietario di un vendor in tutta l’applicazione. La scelta migliore può essere ibrida: capacità commerciale per compiti di routine e componenti personalizzate dove le prestazioni di dominio, il controllo o il rischio creano valore duraturo.
Esempio pratico: scegliere un modello di estrazione documenti
Un’azienda crea un set di test privato di fatture provenienti da fornitori, lingue, scansioni, scrittura a mano e casi limite, quindi confronta un’API gestita, un modello preaddestrato aperto, un modello adattato e una baseline basata su regole. Valuta l’accuratezza dei campi, l’errore monetario, i documenti non supportati, la latenza, il throughput, la privacy, la residenza, l’integrazione e il costo per fattura elaborata correttamente. Le demo dei vendor e i benchmark pubblici non sostituiscono questa valutazione comparata.
L’ibrido selezionato utilizza un servizio OCR commerciale con validazione locale e revisione umana per bassa confidenza o importi elevati. I contratti definiscono la conservazione, i sub‑processori, gli aggiornamenti e la cancellazione; l’architettura conserva i file sorgente e un percorso di uscita. Un periodo di shadow rileva lacune di schema e fornitori. Il monitoraggio separa OCR, estrazione, validazione e correzioni dei revisori. Se il comportamento del vendor cambia, il team può congelare, passare o spostare più lavoro al proprio componente personalizzato senza riscrivere il flusso di lavoro finanziario.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti destinati, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ciascun fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima del fine‑tuning. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a tappe, conservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile della risposta, quindi esaminare le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i vendor, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Quando dovrebbe un team addestrare un modello da zero?
Quando le opzioni preaddestrate o ospitate non possono soddisfare i requisiti convalidati e il team dispone di dati proprietari sufficienti, capacità di calcolo, competenza e capacità operativa a lungo termine.
Un modello pronto all’uso è privo di manutenzione?
No. L’integrazione, la valutazione, i cambiamenti di versione, il monitoraggio, i controlli di privacy e il comportamento di fallback rimangono responsabilità dell’adottante.
Riferimenti principali











