Fondamenti di IA
Che cos’è l’apprendimento per trasferimento?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Transfer learning riutilizza la conoscenza appresa per un problema per migliorare l’apprendimento su un problema correlato. Invece di inizializzare ogni parametro in modo casuale, un professionista parte da un modello o una rappresentazione preaddestrata e lo adatta a un compito target.
Questo approccio è particolarmente utile quando il dataset target è piccolo, l’etichettatura è costosa o il preaddestramento richiede più capacità di calcolo di quanto il team target possa giustificare. Addestrare un modello da zero è l’alternativa al transfer learning, non una tipologia di transfer learning.
Punti chiave
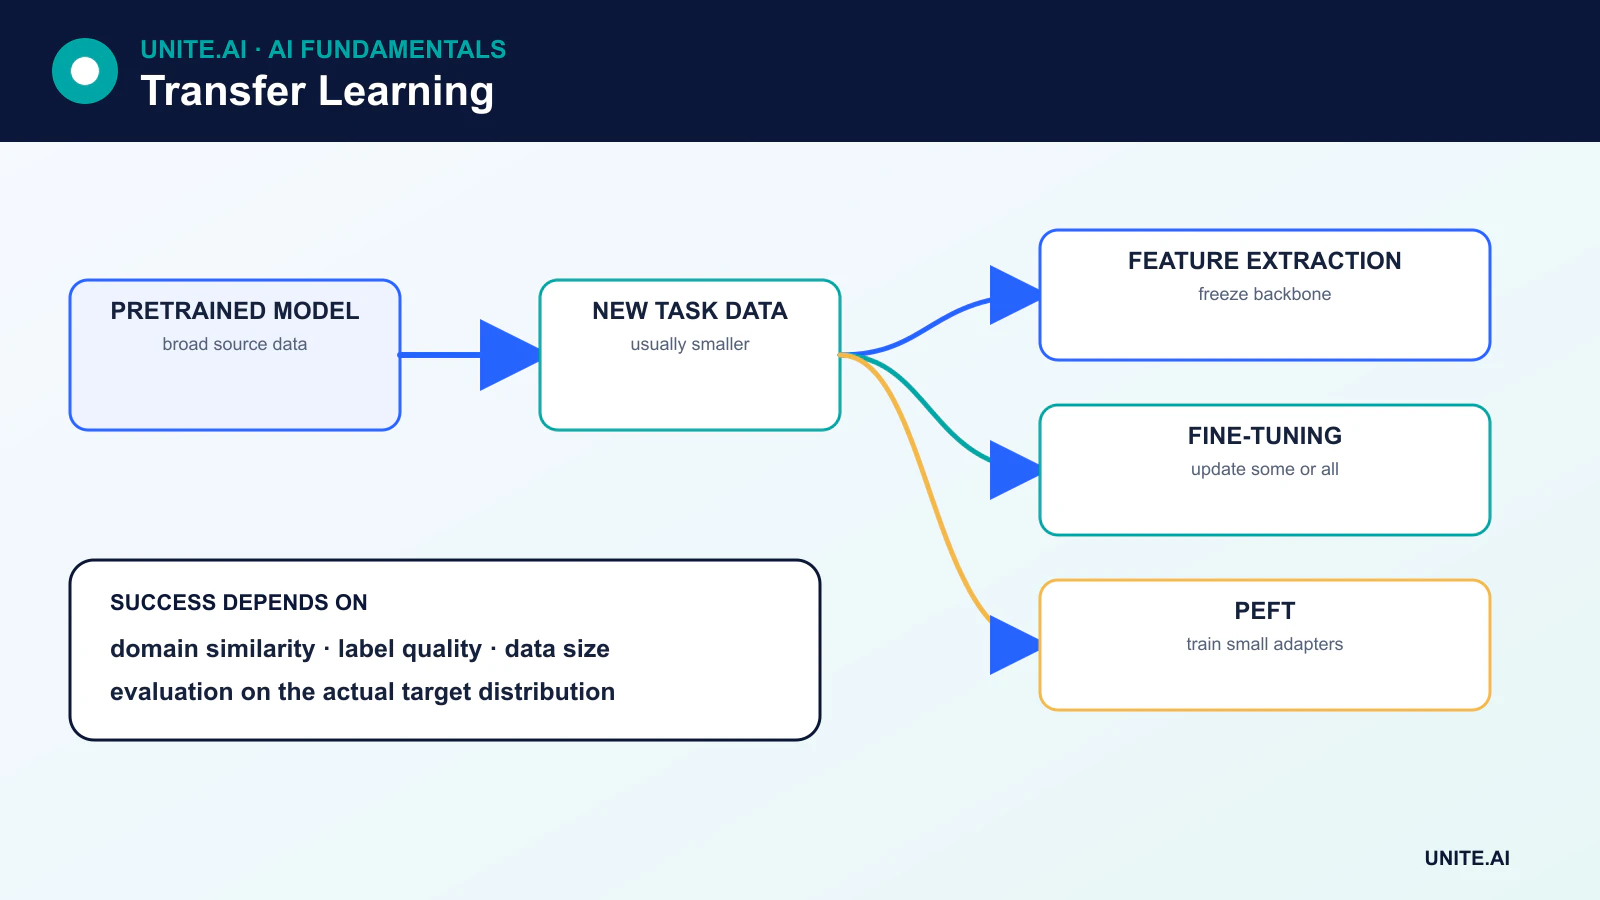
- L’estrazione di caratteristiche mantiene congelata la base preaddestrata e addestra una nuova testa specifica per il compito.
- La messa a punto aggiorna alcuni o tutti i parametri preaddestrati usando dati del dominio target.
- I metodi efficienti in termini di parametri, come gli adapter e LoRA, aggiornano una piccola frazione del modello.
- Il trasferimento può fallire quando i domini di origine e destinazione differiscono, le licenze sono in conflitto o il modello di origine contiene bias inappropriati.
Perché il transfer learning funziona
I modelli spesso apprendono rappresentazioni utili al di là dei dati esatti su cui sono stati addestrati. I primi strati di un modello di immagine possono catturare pattern locali riutilizzabili; un modello linguistico può apprendere sintassi, semantica e ampie associazioni tramite predizione auto-supervisionata. Un compito target può basarsi su queste rappresentazioni invece di riapprendere tutto da esempi limitati.
Il beneficio dipende dalla somiglianza tra i compiti di origine e destinazione, dalla scala e dalla qualità del preaddestramento e dal modo in cui il modello viene adattato. Il riuso non è garantito: le caratteristiche trasferite possono essere irrilevanti o addirittura dannose.
Estrazione di caratteristiche
Nell’estrazione di caratteristiche, la base preaddestrata è congelata, quindi i suoi parametri non cambiano. Il suo output diventa l’input per un nuovo classificatore, regressore o altra testa specifica per il compito. Viene addestrata solo la nuova testa.
Questo è veloce e efficiente in termini di dati, e riduce il rischio di distruggere rappresentazioni preaddestrate utili. Può anche sottoadattarsi quando il dominio target differisce notevolmente dal preaddestramento. Strati come la normalizzazione batch richiedono cure speciali perché le loro statistiche memorizzate e il comportamento di addestramento possono influenzare l’adattamento anche quando la maggior parte dei pesi è congelata.
Messa a punto
Fine-tuning aggiorna i parametri preaddestrati sui dati target. Un flusso di lavoro comune è:
- Caricare il modello preaddestrato e sostituire o aggiungere la testa di output.
- Congelare la base e addestrare la nuova testa.
- Scongelare i layer selezionati — o l’intero modello — e continuare con un tasso di apprendimento più piccolo.
- Validare per overfitting, dimenticanza e prestazioni nel dominio target.
Non esiste una regola universale secondo cui solo gli ultimi strati debbano essere affinati. La scelta migliore dipende dall’architettura, dalla dimensione dei dati target, dalla somiglianza dei domini, dagli strati di normalizzazione, dalla memoria e dalla capacità di calcolo. Il fine-tuning completo può offrire più capacità ma richiede più risorse e può causare dimenticanza catastrofica.
Messa a punto efficiente in termini di parametri
I grandi transformer rendono costoso il fine-tuning completo. Il fine-tuning efficiente in termini di parametri (PEFT) modifica o aggiunge un piccolo insieme di parametri lasciando congelata la maggior parte del modello di base.
- Adapters inseriscono piccoli moduli addestrabili nella rete.
- LoRA rappresenta gli aggiornamenti dei pesi con matrici a basso rango, riducendo i parametri addestrabili e la memoria dell’ottimizzatore.
- Prompt e prefix tuning apprendono input continui specifici per il compito o prefissi interni.
Il PEFT può memorizzare molteplici adattamenti di compiti su un unico modello di base, sebbene il servizio di inferenza, la compatibilità degli adapter e la gestione dei pesi uniti richiedano ancora una progettazione attenta.
Transfer learning attraverso diversi tipi di dati
I classificatori di immagini tipicamente partono da modelli preaddestrati su grandi dataset di immagini. I sistemi linguistici partono da un modello di base e lo adattano tramite fine-tuning supervisionato, ottimizzazione delle preferenze, recupero o utilizzo di strumenti. I modelli di voce, audio, proteine e multimodali seguono schemi analoghi.
Il trasferimento può avvenire anche senza modificare il modello originale. Un modello congelato può generare embedding per un classificatore a valle, un sistema di ricerca di similarità vettoriale o una pipeline di recupero.
Domain shift e trasferimento negativo
Domain shift si verifica quando gli input target differiscono dai dati di origine. Un modello di immagini mediche, ad esempio, può incontrare apparecchiature, popolazioni o protocolli di acquisizione assenti dal preaddestramento. Negative transfer significa che il riuso peggiora le prestazioni target rispetto a un adeguato baseline da zero.
I team dovrebbero confrontare le strategie di adattamento, valutare sottogruppi significativi e mantenere un set di test del dominio target. Se il compito di origine è poco corrispondente, un modello più piccolo e specifico al dominio può superare un modello più grande e generico.
Licenze, provenienza e sicurezza
Un modello scaricabile non è automaticamente sicuro da distribuire. Verificare la licenza, gli usi consentiti, le divulgazioni dei dati di addestramento, le limitazioni della model card e la catena di dipendenze. I modelli possono riprodurre bias, memorizzare dati sensibili o contenere codice serializzato maligno. Utilizzare formati affidabili, analizzare gli artefatti e caricare pesi non attendibili in un ambiente isolato.
Quando utilizzare il transfer learning
Il transfer learning è una buona scelta di default quando esiste un modello preaddestrato pertinente e i dati target sono limitati. Addestrare da zero può essere preferibile quando il dominio è altamente specializzato, la licenza è incompatibile, le dimensioni del modello superano i limiti di distribuzione o un compito semplice non trae beneficio da una grande rappresentazione preaddestrata. La decisione dovrebbe essere validata empiricamente piuttosto che assunta in base alla scala del modello.
Cosa si trasferisce e come adattarlo
Il transfer learning riutilizza le rappresentazioni apprese su un compito o dataset di origine per un compito target. Nella visione, le prime caratteristiche catturano spesso bordi e texture; nel linguaggio, i modelli preaddestrati codificano pattern statistici tra token e contesti. Il trasferimento funziona quando le rappresentazioni di origine contengono informazioni rilevanti per il target, ma differenze di dominio, etichette, modalità e acquisizione possono generare trasferimento negativo. Iniziare con una baseline preaddestrata, esaminare la licenza di addestramento e la documentazione, e confrontarla con l’addestramento di un piccolo modello specifico per il target da zero.
L’estrazione di caratteristiche congela lo scheletro e addestra una nuova testa; il fine-tuning parziale scongela i layer selezionati; il fine-tuning completo aggiorna l’intero modello. I metodi efficienti in termini di parametri aggiungono adapter o aggiornamenti a basso rango, riducendo i parametri addestrabili ma non necessariamente la memoria di inferenza. Utilizzare un tasso di apprendimento più basso per i pesi preaddestrati, preservare il comportamento di normalizzazione e evitare la dimenticanza catastrofica con schedule, regolarizzazione, rehearsal o aggiornamenti vincolati quando necessario. Selezionare checkpoint sui dati di validazione target e testare più seed poiché i piccoli dataset target generano alta varianza.
Compromessi tra dati, valutazione e distribuzione
I dati target dovrebbero rappresentare le condizioni di distribuzione e i sottogruppi importanti, non solo essere un campione etichettato per comodità. Suddividere per soggetto, origine, tempo o luogo per evitare che esempi correlati attraversino le partizioni. Testare sia in condizioni in-domain che spostate. Confrontare le varianti congelate, parzialmente sintonizzate e completamente sintonizzate in termini di qualità, calibrazione, costo di addestramento, latenza e robustezza. Un miglioramento nel punteggio medio può nascondere una perdita su classi rare ereditate dal bias di origine. Esaminare esempi di fallimento per scorciatoie specifiche dell’origine, lacune lessicali o differenze di sensori.
Tracciare il modello di base, i pesi, il tokenizer o il preprocessing, l’adapter, i dati e la licenza come un unico grafo di dipendenze. I modelli di base ospitati possono cambiare comportamento; i pesi aperti possono introdurre responsabilità di catena di fornitura e patching. Validare l’artefatto unito o esportato e analizzare i file del modello da fonti non attendibili. In produzione, monitorare il drift del target e le prestazioni, e mantenere la possibilità di ripristinare sia l’adattamento sia la versione di base. Il transfer riduce i dati target necessari; non elimina l’etichettatura, la valutazione, la privacy o l’expertise di dominio.
Esempio pratico: adattare un modello di visione a una nuova clinica
Una clinica adatta un encoder di imaging preaddestrato per classificare la qualità delle immagini prima della revisione diagnostica. Verifica la licenza del modello di origine e la modalità prevista, raccoglie i dispositivi locali e le condizioni di acquisizione, e suddivide per paziente. Le varianti di feature congelata, adapter, fine-tuning parziale e completo sono confrontate con una piccola baseline locale. Le metriche includono recall di classe, calibrazione, comportamento dei sottogruppi, computazione e sensibilità a dispositivo, sito e artefatti rari.
Il modello adattato non può effettuare una diagnosi e indirizza le immagini a bassa confidenza o non supportate ai tecnologi. La validazione di esportazione conferma il preprocessing locale e l’equivalenza numerica. Le versioni di modello, adapter, dispositivo e dataset sono collegate nel registro. Il monitoraggio rileva nuovi scanner, cambiamenti di protocollo e drift dell’output, mentre campioni periodicamente revisionati stimano le prestazioni reali. Un aggiornamento del modello di origine è trattato come una nuova dipendenza che richiede validazione; il transfer learning non giustifica automaticamente il riutilizzo di evidenze precedenti.
Evidenze di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni errore importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima del tuning. Testare casi ordinari, condizioni limite, input malformati o mancanti, shift di distribuzione, interruzione di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, preservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi rivedere le evidenze del mondo reale dopo la distribuzione anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto richiede anche procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui debba essere disattivato o sostituito.
Riferimenti principali