Fondamenti di IA
Che cos’è il Meta‑Learning?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Meta‑learning addestra un sistema su una distribuzione di compiti in modo che possa adattarsi a un nuovo compito correlato usando dati o calcolo limitati. Spesso viene riassunto come “imparare a imparare”, ma l’obiettivo tecnico è più preciso: ottimizzare l’apprendente affinché l’esperienza sui compiti precedenti migliori l’adattamento a quello successivo.
Il meta‑learning si sovrappone al few‑shot learning e al transfer learning, ma i termini non sono intercambiabili. “Few‑shot” descrive la quantità di dati target; “transfer” descrive il riutilizzo; il meta‑learning rende esplicitamente l’adattamento tra compiti parte dell’addestramento.
Punti chiave
- Il meta‑training utilizza molti compiti, non solo molti esempi indipendenti.
- Un episodio N‑way K‑shot contiene N classi e K esempi di supporto etichettati per classe.
- I metodi basati su gradiente, su metriche, su memoria e gli ottimizzatori appresi si adattano in modi diversi.
- Le prestazioni dipendono fortemente dal fatto che i compiti di meta‑training assomiglino al compito target.
Compiti, set di supporto e set di query
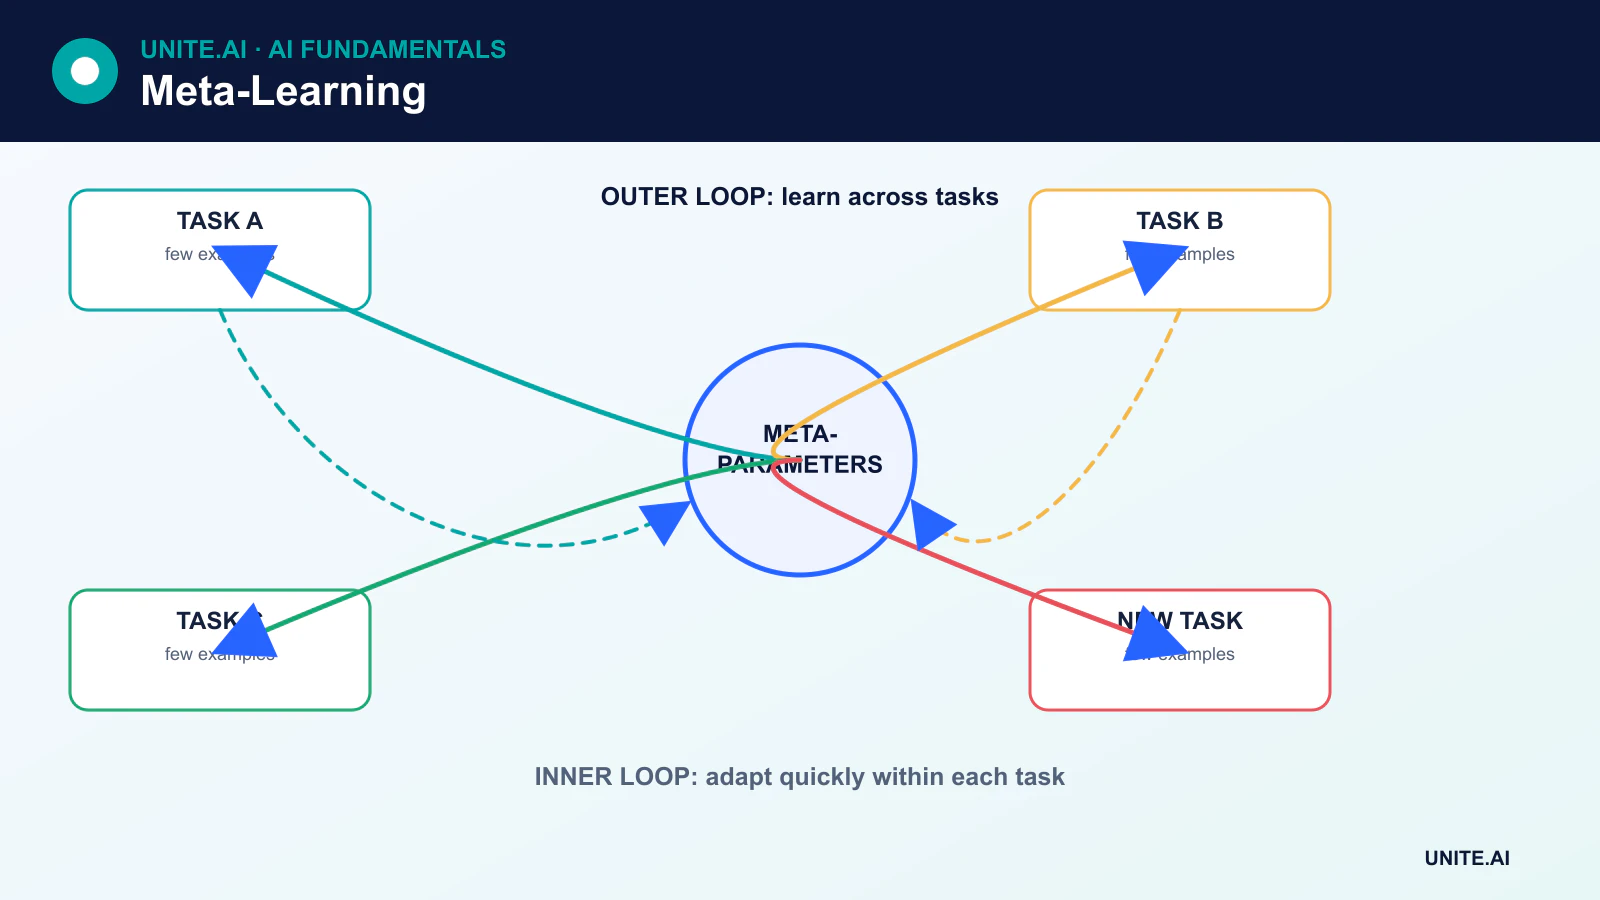
Un dataset di meta‑learning è organizzato in compiti. Nella classificazione few‑shot, un episodio può essere 5‑way 1‑shot: cinque classi, un esempio di supporto etichettato per classe, e esempi di query aggiuntivi usati per valutare l’adattamento. Un compito 5‑way 5‑shot ha cinque esempi di supporto per ciascuna delle cinque classi, non cinque esempi in totale.
Durante il meta‑training, l’apprendente si adatta ripetutamente su un set di supporto e viene valutato su un set di query. L’obiettivo esterno migliora le future prestazioni di query attraverso i compiti. La meta‑validazione regola le scelte su compiti separati, e il meta‑testing valuta compiti o classi realmente non visti.
Meta‑learning basato su gradiente
Model‑Agnostic Meta‑Learning (MAML) apprende un’inizializzazione da cui un piccolo numero di passi di gradiente produce buone prestazioni su un nuovo compito. Il ciclo interno adatta i parametri del modello usando i dati di supporto. Il ciclo esterno aggiorna l’inizializzazione condivisa usando la perdita di query su compiti campionati.
MAML non è limitato alla classificazione; può essere applicato a regressione e al reinforcement learning quando modello e compito sono differenziabili. Reptile offre un approccio di primo ordine più semplice che sposta i parametri verso soluzioni adattate al compito senza calcolare il meta‑gradiente completo di MAML.
Meta‑learning basato su metriche
I metodi basati su metriche apprendono un embedding in cui gli esempi della stessa classe sono vicini e le classi diverse sono separate. Una rete prototipica media gli embedding di supporto per formare un prototipo per classe, quindi classifica le query in base alla distanza da tali prototipi.
Le reti di tipo Matching e Siamese utilizzano meccanismi di similarità correlati. Questi metodi non si limitano a verificare se un modello “raggiunge una metrica target”; la distanza o la rappresentazione appresa è parte integrante della procedura di previsione.
Metodi basati su memoria e ottimizzatori appresi
I sistemi basati su memoria usano uno stato ricorrente o basato sull’attenzione per memorizzare informazioni sul compito corrente. Gli ottimizzatori appresi ricevono gradienti o segnali di addestramento in ingresso e apprendono come aggiornare un altro modello. Questi metodi possono scoprire regole di adattamento, ma aggiungono parametri, calcolo e un ulteriore livello di potenziale overfitting.
Meta‑learning e apprendimento in‑contesto
I grandi transformer possono adattare il loro output a partire da esempi forniti in un prompt senza aggiornare i pesi. Questo è chiamato apprendimento in‑contesto. Somiglia al comportamento del meta‑learning, e i dati di addestramento possono favorire l’inferenza del compito, ma un apprendente in‑contesto non è automaticamente addestrato con un obiettivo episodico classico di meta‑learning.
Dove il meta‑learning è utile
Le possibili applicazioni includono personalizzazione, robotica, riconoscimento a risorse limitate, compiti scientifici con poche misurazioni e adattamento rapido a nuovi ambienti. Il meta‑learning è più interessante quando sono disponibili molti compiti sorgente correlati ma i dati del compito target sono scarsi.
Limitazioni
Il meta‑learning può essere computazionalmente costoso perché l’addestramento annida l’adattamento all’interno dell’ottimizzazione. I risultati sono sensibili alla costruzione dei compiti, a perdite tra supporto e query, all’architettura e al cambiamento di dominio. Un modello addestrato su compiti ristretti e omogenei può adattarsi male al di fuori di quella distribuzione.
Le comparazioni dovrebbero includere i tradizionali baseline di transfer‑learning e multitask. Una rappresentazione pre‑addestrata solida seguita da un fine‑tuning standard può essere più semplice e più efficace di un algoritmo dedicato al meta‑learning.
Compiti, adattamento e struttura di ottimizzazione interno‑esterno
Il meta‑learning si addestra su una distribuzione di compiti affinché un apprendente possa adattarsi a un nuovo compito con dati o aggiornamenti limitati. Cada episodio campiona un compito, divide gli esempi in un set di supporto usato per l’adattamento e un set di query usato per la valutazione, e aggiorna la conoscenza condivisa tra gli episodi. I metodi basati su metriche apprendono un embedding e una regola di confronto; i metodi basati su ottimizzazione apprendono l’inizializzazione o il comportamento di aggiornamento; i metodi basati su memoria e modello si condizionano sugli esempi del compito. La distribuzione dei compiti è il vero dato di addestramento e deve assomigliare ai futuri problemi di adattamento.
Nel model‑agnostic meta‑learning, un ciclo interno adatta i parametri sugli esempi di supporto e un ciclo esterno ottimizza le prestazioni sugli esempi di query dopo l’adattamento. I gradienti di ordine superiore possono essere costosi; le approssimazioni di primo ordine scambiano fedeltà per costo. Le reti prototipiche rappresentano ogni classe mediante il centroide del set di supporto e classificano in base alla distanza. Questi metodi assumono che la geometria delle classi, i passi di adattamento e la costruzione degli episodi riflettano il deployment. Un metodo può apparire capace di apprendere rapidamente sfruttando etichette fisse, artefatti di acquisizione o sovrapposizioni tra dataset sorgente.
Valutazione, baseline e limitazioni nel mondo reale
Separare i compiti di addestramento, validazione e test — non solo gli esempi — per misurare l’adattamento a compiti realmente non visti. Riportare accuratezza o perdita in funzione del numero di shot e dei passi di adattamento, intervalli di confidenza tra i compiti, calcolo, memoria e sensibilità alla composizione del set di supporto. Confrontare con transfer learning, fine‑tuning di un modello pre‑addestrato, nearest neighbors e un modello addestrato congiuntamente su tutti i dati sorgente. Molti apparenti guadagni del meta‑learning si riducono quando i baseline ricevono backbone, augmentazione e tuning equivalenti.
Le implementazioni reali necessitano di un modo per riconoscere quando un nuovo compito si trova al di fuori della distribuzione di meta‑training. Esempi di supporto scarsi o etichettati erroneamente possono provocare fallimenti rapidi e sicuri. Limitare l’entità degli aggiornamenti, convalidare i modelli adattati, preservare un fallback e proteggere i dati di adattamento da avvelenamento. Tracciare modello di base, campionatore di compiti, seed degli episodi e codice di adattamento. Il meta‑learning è utile per famiglie ricorrenti di problemi con pochi dati, ma non crea una capacità di apprendimento generale da esempi arbitrari e non elimina la necessità di valutazioni specifiche di dominio.
Esempio pratico: adattamento few‑shot tra macchine
Un produttore considera ogni tipo di macchina come un compito e meta‑addestra una rappresentazione di anomalie su molte macchine con risultati di manutenzione verificati. Le macchine di test sono completamente escluse dall’addestramento dei compiti. Per una nuova macchina, un piccolo set di supporto copre i normali modi operativi anziché minuti arbitrari di dati. Il meta‑learning viene confrontato con un encoder pre‑addestrato congelato, nearest neighbors e il classico fine‑tuning usando gli stessi esempi di supporto e la stessa potenza di calcolo.
La valutazione ripete numerose selezioni di supporto e riporta recall degli eventi, falsi allarmi, tempo di adattamento e varianza. Il sistema si astiene quando il set di sensori o la dinamica della nuova macchina ricade al di fuori della distribuzione dei compiti. Gli aggiornamenti di adattamento sono limitati e revisionati prima di influenzare la manutenzione. Le etichette di supporto e l’identità della macchina sono protette da avvelenamento, e ogni modello adattato conserva la sua versione base e gli esempi. L’adattamento rapido è accettato solo se supera costantemente il transfer più semplice in presenza di cambiamenti realistici del compito.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni al contorno, input malformati o mancanti, cambiamento di distribuzione, interruzione di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a fasi, preservare un fallback sicuro e verificare il monitoraggio con guasti inseriti deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi rivedere le evidenze reali dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui disattivarlo o sostituirlo.
Domande frequenti
Il prompting few‑shot è meta‑learning?
Il prompting few‑shot è una tecnica di adattamento in‑contesto. Può mostrare comportamenti associati all’apprendimento attraverso più compiti, ma non è addestrato automaticamente con episodi di supporto/query o con un ciclo esplicito di meta‑ottimizzazione.
Qual è il più grande rischio del meta‑learning?
Una discrepanza tra i compiti di meta‑training e il compito target può far apparire l’adattamento rapido molto efficace in un benchmark ma fallire in produzione. Le divisioni dei compiti e la provenienza dei dati sorgente devono essere verificate con la stessa attenzione delle tradizionali divisioni train/test.
Riferimenti principali