
Fondamenti di IA
Cos’è la discesa del gradiente?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Gradient descent è un metodo di ottimizzazione che regola i parametri del modello per ridurre una funzione obiettivo. Nell’addestramento delle reti neurali, tale obiettivo è solitamente una perdita calcolata sui campioni. Il gradiente indica la direzione di massima crescita locale, quindi la discesa del gradiente compie un passo nella direzione opposta.
Il gradiente descrive la sensibilità locale; la sua magnitudine non è una misura diretta della velocità con cui un modello “impara”. Il progresso reale dipende anche dal tasso di apprendimento, dalla curvatura, dal rumore, dalla parametrizzazione, dallo stato dell’ottimizzatore e dai dati.
Punti chiave
- Backpropagation calcola i gradienti, mentre la discesa del gradiente li utilizza per aggiornare i parametri.
- L’ottimizzazione mini-batch è l’approccio pratico standard per il deep learning.
- Il tasso di apprendimento controlla la scala dell’aggiornamento e può seguire una programmazione anziché ridursi dopo ogni passo.
- Momentum, AdamW, clipping e normalizzazione affrontano diversi problemi di ottimizzazione.
La regola di aggiornamento di base
Per il vettore di parametri θ, il tasso di apprendimento η e la perdita L:
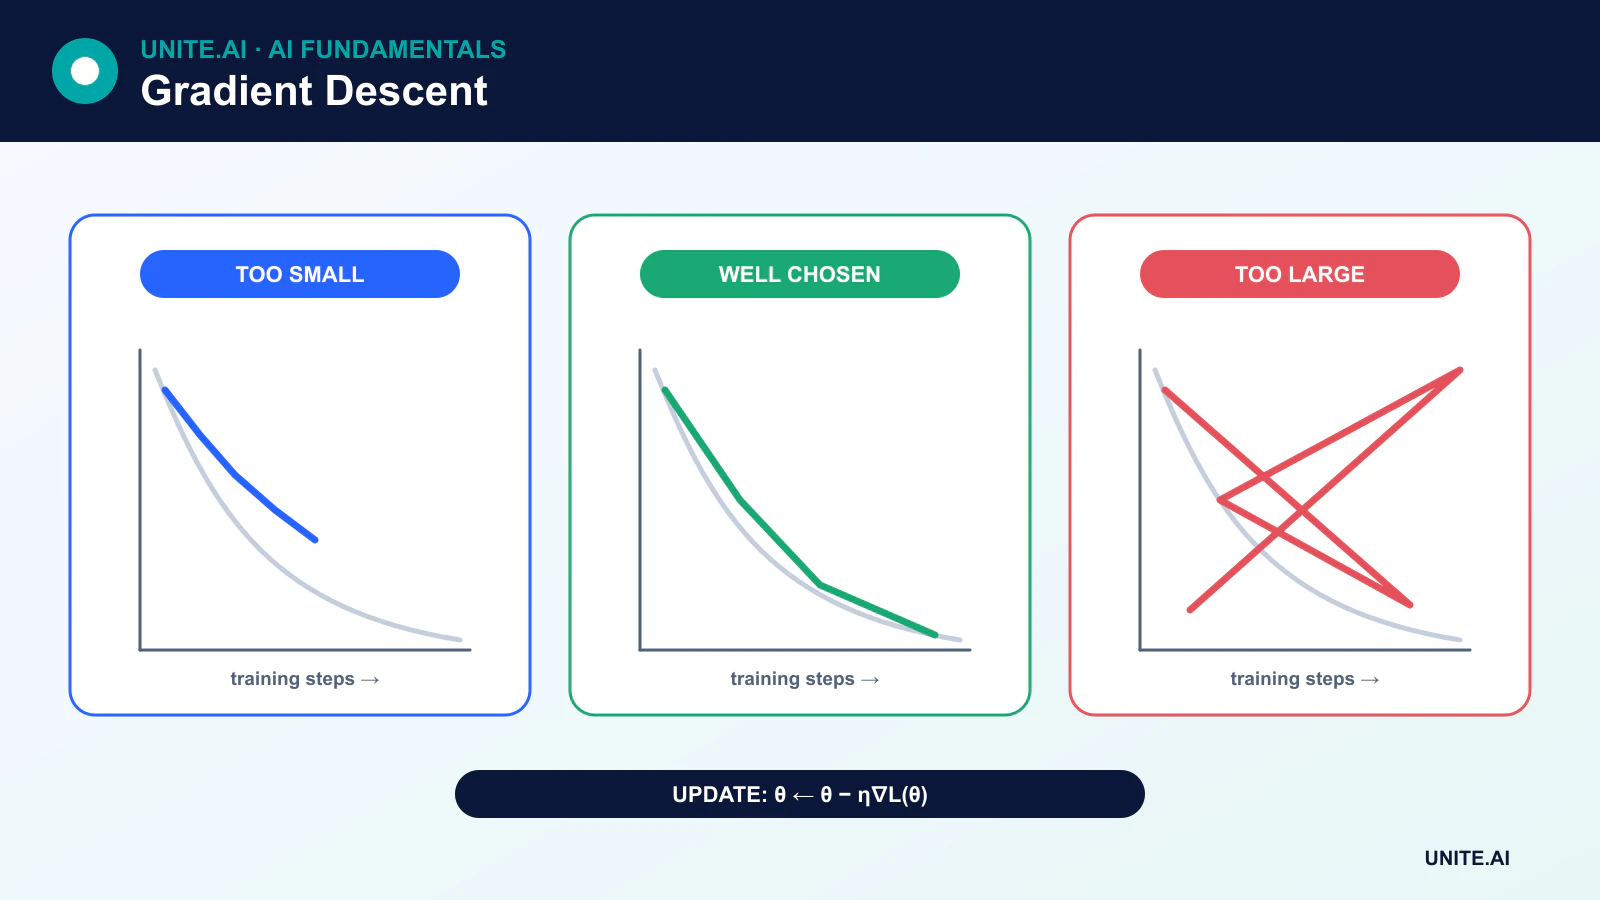
θ ← θ - η∇L(θ)
θ ← θ - η∇L(θ)
Il gradiente ∇L(θ) contiene una derivata parziale per ogni parametro. Sottraendolo si scende localmente. Un punto stazionario ha gradiente zero, ma può essere un minimo, un massimo, un punto sella o una regione piatta. Le superfici di perdita del deep learning sono non convexe, quindi l’addestramento non garantisce di trovare un minimo globale unico o una perdita zero.
Metodi batch, stocastico e mini-batch
Discesa del gradiente batch
La discesa del gradiente batch calcola il gradiente usando l’intero set di addestramento per ogni aggiornamento. La stima è stabile ma può essere costosa in termini di tempo e memoria, e un singolo aggiornamento può sottoutilizzare gli acceleratori moderni.
Discesa del gradiente stocastica
La discesa del gradiente stocastica pura utilizza un esempio selezionato casualmente per aggiornamento. I suoi gradienti sono rumorosi, il che può favorire l’esplorazione della superficie di perdita, ma le operazioni su singolo esempio possono essere inefficienti su hardware parallelo.
Discesa del gradiente mini-batch
L’addestramento mini-batch stima il gradiente da un sottoinsieme di esempi. Bilancia il rumore statistico con operazioni matriciali efficienti ed è l’approccio usuale nel deep learning. La dimensione del batch influisce su memoria, throughput, rumore del gradiente, normalizzazione e talvolta sulla generalizzazione.
Scelta del tasso di apprendimento
Un tasso troppo grande può superare regioni utili o causare divergenza. Un tasso troppo piccolo può rendere l’addestramento impraticabilmente lento o bloccare in regioni piatte. La scala ottimale dipende dall’ottimizzatore, dalla dimensione del batch, dal modello, dall’inizializzazione e dall’obiettivo.
Le programmazioni possono riscaldarsi gradualmente, decrescere a tappe, seguire una curva coseno o rispondere ai progressi di validazione. Il tasso non deve necessariamente ridursi monotonicamente dopo ogni aggiornamento. I warm restart e le programmazioni cicliche aumentano deliberatamente il tasso durante parti dell’addestramento.
Momentum
Il momentum mantiene una media mobile esponenziale dei gradienti passati. Può accelerare il progresso lungo direzioni coerenti e ridurre l’oscillazione su direzioni ripide e strette. Il momentum in stile Nesterov valuta o approssima il gradiente dopo aver guardato avanti lungo la direzione del momentum.
Ottimizzatori adattivi
RMSProp scala gli aggiornamenti usando una media mobile dei gradienti al quadrato. Adam combina momenti di primo ordine simili al momentum con una scala basata sul secondo momento. AdamW separa il decadimento del peso dall’aggiornamento adattivo del gradiente ed è ampiamente usato per i transformer.
Gli ottimizzatori adattivi spesso rendono più semplice l’addestramento iniziale, ma non sono automaticamente superiori per ogni modello o obiettivo finale di generalizzazione. I confronti tra ottimizzatori richiedono programmazioni corrispondenti e una sintonizzazione attenta.
Clipping e accumulo del gradiente
Il clipping del gradiente limita la norma o i valori di un gradiente per ridurre l’impatto dei gradienti esplosivi, specialmente in addestramenti ricorrenti o instabili. L’accumulo del gradiente somma i gradienti di diversi batch più piccoli prima di un aggiornamento, approssimando un batch efficace più grande quando la memoria è limitata.
Monitoraggio dell’ottimizzazione
Monitora la perdita di addestramento e di validazione, le metriche del compito, il tasso di apprendimento, le norme dei gradienti, le norme dei parametri e gli errori numerici. Una perdita di addestramento in calo con peggioramento delle prestazioni di validazione indica overfitting, non un successo di ottimizzazione che dovrebbe proseguire automaticamente.
L’ottimizzazione minimizza l’obiettivo assegnato. Una perdita bassa non dimostra che i dati, la metrica o il comportamento nel mondo reale siano adeguati. Perdite di dati, etichette scadenti e un obiettivo non allineato possono produrre un modello ben ottimizzato ma dannoso.
Geometria dell’ottimizzazione e regole di aggiornamento
La discesa del gradiente aggiorna i parametri nella direzione opposta al gradiente di una perdita. La discesa full‑batch utilizza ogni esempio di addestramento per passo; la discesa stocastica ne usa uno; i metodi mini‑batch stimano il gradiente da un sottoinsieme e dominano il deep learning. Il tasso di apprendimento determina la scala del passo. Troppo piccolo spreca calcolo o blocca; troppo grande oscilla o diverge. Il momentum accumula una direzione mobile, mentre metodi adattivi come Adam scalano le coordinate usando i momenti del gradiente. I loro diversi bias impliciti possono produrre modelli con perdita di addestramento simile ma diversa capacità di generalizzazione.
Le superfici di perdita nelle reti neurali contengono regioni piatte e acute, punti sella, simmetrie e direzioni mal condizionate. La scalatura delle caratteristiche, la normalizzazione, l’inizializzazione, le connessioni residuali e il precondizionamento modificano la geometria percepita dall’ottimizzatore. Le programmazioni possono riscaldarsi, decrescere, ciclarsi o reagire a plateau. Il decadimento del peso è distinto dal semplice aggiungere una penalità L2 in alcuni ottimizzatori adattivi. La dimensione del batch influisce su rumore, memoria, parallelismo e regime del tasso di apprendimento, quindi i confronti tra ottimizzatori richiedono budget di addestramento corrispondenti e una sintonizzazione attenta.
Diagnosi, riproducibilità e arresto
Monitora la perdita di addestramento e di validazione, le metriche del compito, le norme di gradienti e parametri, il tasso di apprendimento, il throughput e gli avvisi numerici. La divergenza può derivare da batch corrotti, etichette non valide, precisione mista instabile o una riduzione della perdita errata. I plateau possono indicare capacità insufficiente, attivazioni sature, caratteristiche scadenti, regolarizzazione eccessiva o un problema di programmazione. L’overfitting richiede più dati, augmentazione, regolarizzazione o early stopping, non una affermazione che l’ottimizzatore abbia fallito. Ispeziona gli errori rappresentativi e confronta una baseline semplice prima di aumentare la complessità dell’addestramento.
La riproducibilità richiede semi, ordine dei dati, codice, configurazione, versioni hardware e di libreria, sebbene alcuni kernel di acceleratore rimangano nondeterministici. Salva i checkpoint con lo stato dell’ottimizzatore e del scheduler affinché l’addestramento possa riprendere in modo coerente. Seleziona un checkpoint basato su criteri di validazione fissati in anticipo e riserva un set di test intatto. Nell’addestramento distribuito, conferma la dimensione efficace del batch, la media dei gradienti e la gestione dei worker falliti. L’ottimizzazione minimizza l’obiettivo scelto sui dati disponibili; non garantisce probabilità calibrate, ragionamento causale, equità, sicurezza o utilità nel mondo reale.
Esempio pratico: ottimizzare un ottimizzatore per un modello linguistico
Un team fissa tokenizer, ordine dei dati, modello, batch efficace e budget di token di addestramento, poi confronta SGD con momentum e AdamW su programmazioni di tasso di apprendimento difendibili. Warm‑up, decay, weight decay, clipping e precisione vengono registrati. Ogni candidato esegue diversi semi, e la validazione utilizza una porzione temporale tenuta da parte più valutazioni di compito. Throughput ed energia sono riportati insieme alla perdita così che un ottimizzatore leggermente migliore non venga scelto a costo sproporzionato.
Le diagnosi rivelano se l’instabilità proviene da uno shard di dati, da una dimensione del passo eccessiva, da underflow o dall’architettura del modello. I checkpoint preservano lo stato dell’ottimizzatore e del scheduler e vengono ripresi in un test. La scelta finale si basa sulla qualità e robustezza della validazione, non sulla minima perdita di addestramento. Un set di test sigillato viene eseguito una volta dopo la selezione. L’inferenza in produzione è calibrata e monitorata separatamente perché il successo dell’ottimizzatore durante il pre‑training non garantisce un comportamento sicuro o veritiero.
Prove dell’implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testa casi ordinari, condizioni al limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile di risposta, poi rivedi le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disattivato o sostituito.
Domande frequenti
La discesa del gradiente raggiunge sempre il minimo globale?
No. Per obiettivi convessi, condizioni appropriate forniscono forti garanzie. Gli obiettivi delle reti profonde sono non convessi, e gli ottimizzatori pratici solitamente cercano una soluzione utile piuttosto che dimostrare di aver trovato il minimo globale unico.
Perché un gradiente zero può essere fuorviante?
Un gradiente zero o molto piccolo può indicare un minimo, un massimo, un punto sella, saturazione o un plateau piatto. Le diagnosi di addestramento devono considerare la storia della perdita, la curvatura, la scala dei parametri e le prestazioni di validazione.
Riferimenti principali












