
Fondamenti di IA
Cos’è il Deep Learning?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Deep learning è una famiglia di metodi di machine learning che utilizza reti neurali con più strati di elaborazione per apprendere rappresentazioni utili dei dati. Questi modelli alimentano molti sistemi moderni per il linguaggio, le immagini, l’audio, le raccomandazioni, la previsione scientifica e l’IA generativa.
Il termine deep si riferisce al numero di trasformazioni tra input e output, non a una macchina che possiede una comprensione più profonda. Un modello deep apprende relazioni numeriche utili per il suo obiettivo di addestramento, e le sue prestazioni devono comunque essere testate su nuovi dati.
Punti chiave
- Il deep learning è un sottoinsieme del machine learning.
- Gli strati trasformano i tensori usando parametri appresi, attivazioni non lineari, normalizzazione e altre operazioni.
- Il backpropagation calcola i gradienti; un ottimizzatore utilizza tali gradienti per aggiornare i parametri addestrabili, inclusi pesi e bias.
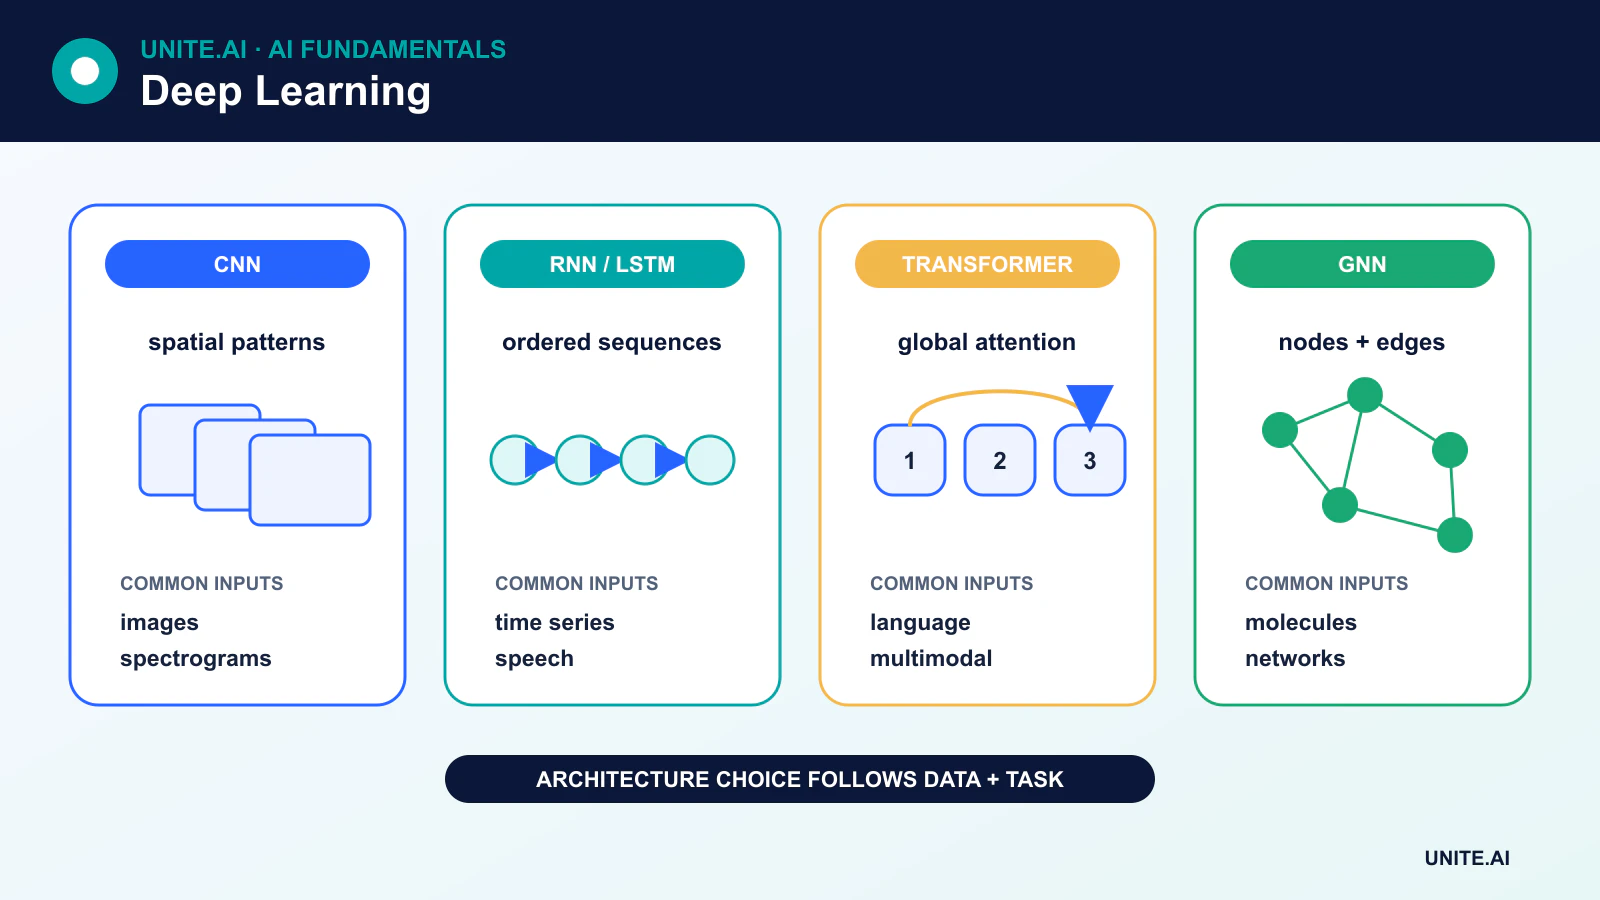
- CNN, reti ricorrenti, transformer, autoencoder e modelli di diffusione hanno strutture e punti di forza diversi.
Come apprende una rete neurale profonda
Una rete neurale riceve i dati sotto forma di tensori, ovvero array multidimensionali di numeri. Un tensore immagine può codificare i canali dei pixel, mentre un modello linguistico utilizza vettori che rappresentano i token. Ogni strato esegue una trasformazione differenziabile e passa il risultato allo strato successivo.
In un semplice strato denso, il modello calcola una somma pesata dei suoi input, aggiunge un bias addestrabile e poi applica una funzione di attivazione:
output = activation(Wx + b)
La funzione di attivazione introduce non linearità. Senza di essa, impilare strati lineari ordinari rappresenterebbe ancora solo una trasformazione lineare. ReLU e le sue varianti sono comuni negli strati nascosti, mentre le attivazioni di output dipendono dal compito.
Tipicamente l’addestramento segue quattro passaggi:
- Un forward pass produce previsioni.
- Una loss function misura quanto le previsioni differiscono dall’obiettivo.
- Backpropagation applica la regola della catena per calcolare il gradiente della loss rispetto a ciascun parametro addestrabile.
- Un ottimizzatore, come lo stochastic gradient descent o AdamW, aggiorna i parametri.
Ripetere questi passaggi su molti batch può migliorare il modello, ma una perdita di addestramento più bassa non garantisce un comportamento affidabile nel mondo reale. La validazione, la regolarizzazione, dati rappresentativi e il monitoraggio rimangono essenziali.
Principali architetture di deep learning
Perceptron multistrato
Un perceptron multistrato (MLP) utilizza strati completamente connessi in cui ogni unità di output dipende da tutti gli input dello strato precedente. Gli MLP sono utili per caratteristiche tabulari e come componenti all’interno di sistemi più grandi, ma non incorporano assunzioni sulla località delle immagini o sull’ordine delle sequenze.
Reti neurali convoluzionali
Convolutional neural networks (CNNs) applicano filtri appresi su regioni locali. La condivisione dei pesi le rende efficienti per griglie come immagini e spettrogrammi. Le CNN rimangono importanti per la visione e il deployment edge, sebbene i vision transformer e i modelli ibridi siano anch’essi ampiamente usati.
Reti ricorrenti, LSTM e GRU
Recurrent neural networks (RNNs) aggiornano uno stato nascosto mentre una sequenza viene elaborata. LSTM e unità ricorrenti gated (GRU) aiutano a preservare l’informazione e a ridurre il problema del gradiente che svanisce, che rende le RNN di base difficili da gestire con dipendenze lunghe. Non eliminano ogni limitazione di contesto lungo, ma rimangono utili per segnali in streaming, dati temporali e modelli sequenziali compatti.
Transformer
Transformers utilizzano l’attenzione per modellare le relazioni tra gli elementi di una sequenza o di un insieme. La loro capacità di elaborare molte posizioni in parallelo ha permesso di sostituire la ricorrenza nella maggior parte dei grandi sistemi linguistici, e le varianti dei transformer ora elaborano immagini, audio, video, proteine e dati multimodali.
Autoencoder e modelli generativi
Un autoencoder comprime un input in una rappresentazione e ricostruisce l’input da essa. Questo crea un obiettivo di ricostruzione auto-supervisionato; non converte automaticamente dati non etichettati in esempi etichettati.
Generative adversarial networks addestrano un generatore e un discriminatore in competizione. Diffusion models apprendono a invertire un processo di inquinamento graduale. I transformer autoregressivi generano un token o unità alla volta. Questi approcci hanno dinamiche di addestramento, controllabilità e requisiti computazionali differenti.
Perché la profondità aiuta — e perché l’architettura è importante
Più strati consentono a un modello di comporre trasformazioni più semplici in trasformazioni più complesse. Nella visione, alcune caratteristiche apprese possono progredire da texture locali a pattern specifici per il compito. Nel linguaggio, gli strati di attenzione costruiscono rappresentazioni di token dipendenti dal contesto. Queste descrizioni sono intuizioni utili, non regole fisse su ciò che ogni strato deve apprendere.
Le reti moderne si basano anche su connessioni residuali, normalizzazione, inizializzazione accurata, regolarizzazione e hardware ottimizzato. Aggiungere semplicemente strati o parametri può rendere un modello più difficile da addestrare, più lento o più incline al overfitting. La scala del modello aiuta solo quando i dati, l’obiettivo, l’ottimizzazione e l’ambiente di deployment lo supportano.
Addestramento vs inferenza
Training regola i parametri ed è solitamente la fase più intensiva dal punto di vista computazionale. Inference esegue il modello addestrato per produrre un output. L’inferenza può comunque essere costosa per modelli grandi, motivo per cui i team usano quantizzazione, distillazione, batching, caching, sparsità e hardware specializzato come neural processing units.
Limitazioni e uso responsabile
I modelli deep possono ereditare bias, memorizzare informazioni sensibili, fallire sotto cambiamento di distribuzione e produrre output convincenti ma errati. Possono anche essere difficili da interpretare e costosi da addestrare. La valutazione dovrebbe coprire più di una media di benchmark: i team hanno bisogno di performance a livello di classe o sotto-gruppo, robustezza, calibrazione, sicurezza, latenza, consumo energetico e le conseguenze di un fallimento.
Rappresentazioni, ottimizzazione e scelte architetturali
Le reti profonde apprendono rappresentazioni successive attraverso strati parametrizzati. Le trasformazioni lineari mescolano gli input; le attivazioni non lineari permettono alla rete di approssimare funzioni complesse; normalizzazione e connessioni residuali aiutano l’ottimizzazione; attenzione, convoluzione, ricorrenza o operazioni di spazio di stato codificano diverse assunzioni strutturali. La profondità aumenta il numero di trasformazioni, non garantisce intelligenza. L’architettura dovrebbe riflettere la modalità, il volume dei dati, la latenza, la memoria e le invarianti del compito. Un modello convoluzionale più piccolo può superare un transformer quando i dati sono limitati e la struttura spaziale locale domina.
L’addestramento calcola una loss, la differenzia con il backpropagation e aggiorna i parametri con un ottimizzatore come lo stochastic gradient descent o Adam. Batch size, learning rate, schedule, inizializzazione, regolarizzazione e precisione numerica interagiscono. Le curve di loss di addestramento e validazione aiutano a distinguere underfitting, overfitting, instabilità e leakage, ma non stabiliscono l’utilità nel mondo reale. Usare dati di valutazione indipendenti, esecuzioni ripetute dove la varianza è importante, ablation e confronto con baseline più semplici. Un grande numero di parametri aumenta anche la necessità di governance dei dati, pianificazione del calcolo e configurazione riproducibile.
Distribuzione sicura ed efficiente di modelli deep
Il deployment può utilizzare un endpoint ospitato, acceleratore dedicato, browser, telefono o dispositivo embedded. L’esportazione e la compilazione possono fondere operatori, quantizzare pesi e attivazioni, o modificare il comportamento numerico, quindi è necessario validare l’artefatto distribuito anziché solo il checkpoint di addestramento. Misurare cold start, latenza costante, throughput, memoria, consumo energetico e qualità a batch e dimensioni di sequenza realistiche. I metodi di compressione — pruning, distillazione, quantizzazione e low-rank adaptation — scambiano dimensione o velocità con accuratezza e complessità ingegneristica e devono essere valutati su classi sensibili e casi limite.
I modelli deep possono fallire con sicurezza sotto cambiamento di distribuzione, input avversari, correlazioni spurie e gruppi poco rappresentati. Monitorare distribuzioni di input e output, risultati del compito, calibrazione, uso delle risorse e versioni delle dipendenze. Usare controllo accessi, artefatti firmati, dati di addestramento protetti, red teaming e limiti di frequenza appropriati al modello di minaccia. Le spiegazioni come mappe di salienza o visualizzazioni dell’attenzione sono evidenze diagnostiche, non prove di causalità. Combinarle con test comportamentali, controfatti, revisione umana, risposta agli incidenti e limiti espliciti alle decisioni automatizzate.
Esempio pratico: addestrare un rilevatore di difetti nelle immagini
Una fabbrica raccoglie immagini di prodotto da diverse telecamere, cambi di produzione, materiali e classi di difetti note, poi le suddivide per batch di produzione affinché gli elementi quasi duplicati non attraversino le partizioni. Un piccolo baseline convoluzionale è confrontato con una rete profonda preaddestrata. L’augmentazione riproduce variazioni validate di illuminazione e punto di vista senza cancellare i difetti. La valutazione riporta recall per difetto, tasso di falsi rifiuti, calibrazione, latenza di inferenza e robustezza a sfocatura, riflessi, sostituzione della telecamera e colori di materiale rari.
Il modello esportato e il codice esatto di resize, colore e normalizzazione sono testati sull’hardware della linea per throughput sostenuto e comportamento termico. I casi a bassa confidenza sono inviati agli ispettori; una regola indipendente ferma la linea per guasti di sensori critici per la sicurezza. Le immagini sono conservate solo se consentito e gli artefatti del modello sono firmati. Il monitoraggio collega le previsioni ai risultati delle ispezioni successive e ai lotti di produzione. Una nuova telecamera o materiale attiva una rivalutazione controllata anziché un apprendimento online silenzioso da etichette non revisionate.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni al limite, input malformati o mancanti, cambiamento di distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più probabilmente trascurati. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout graduale, conservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare qualità dell’input, comportamento dell’output, versione del modello o della regola, stato delle dipendenze, interventi umani e risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile di risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento da incidenti, cancellazione e conservazione, e di un chiaro punto in cui debba essere disabilitato o sostituito.
Riferimenti principali












