Fondamenti di IA
Che cos’è l’apprendimento per rinforzo?

 Aggiungi Unite.AI alle tue fonti preferite su Google
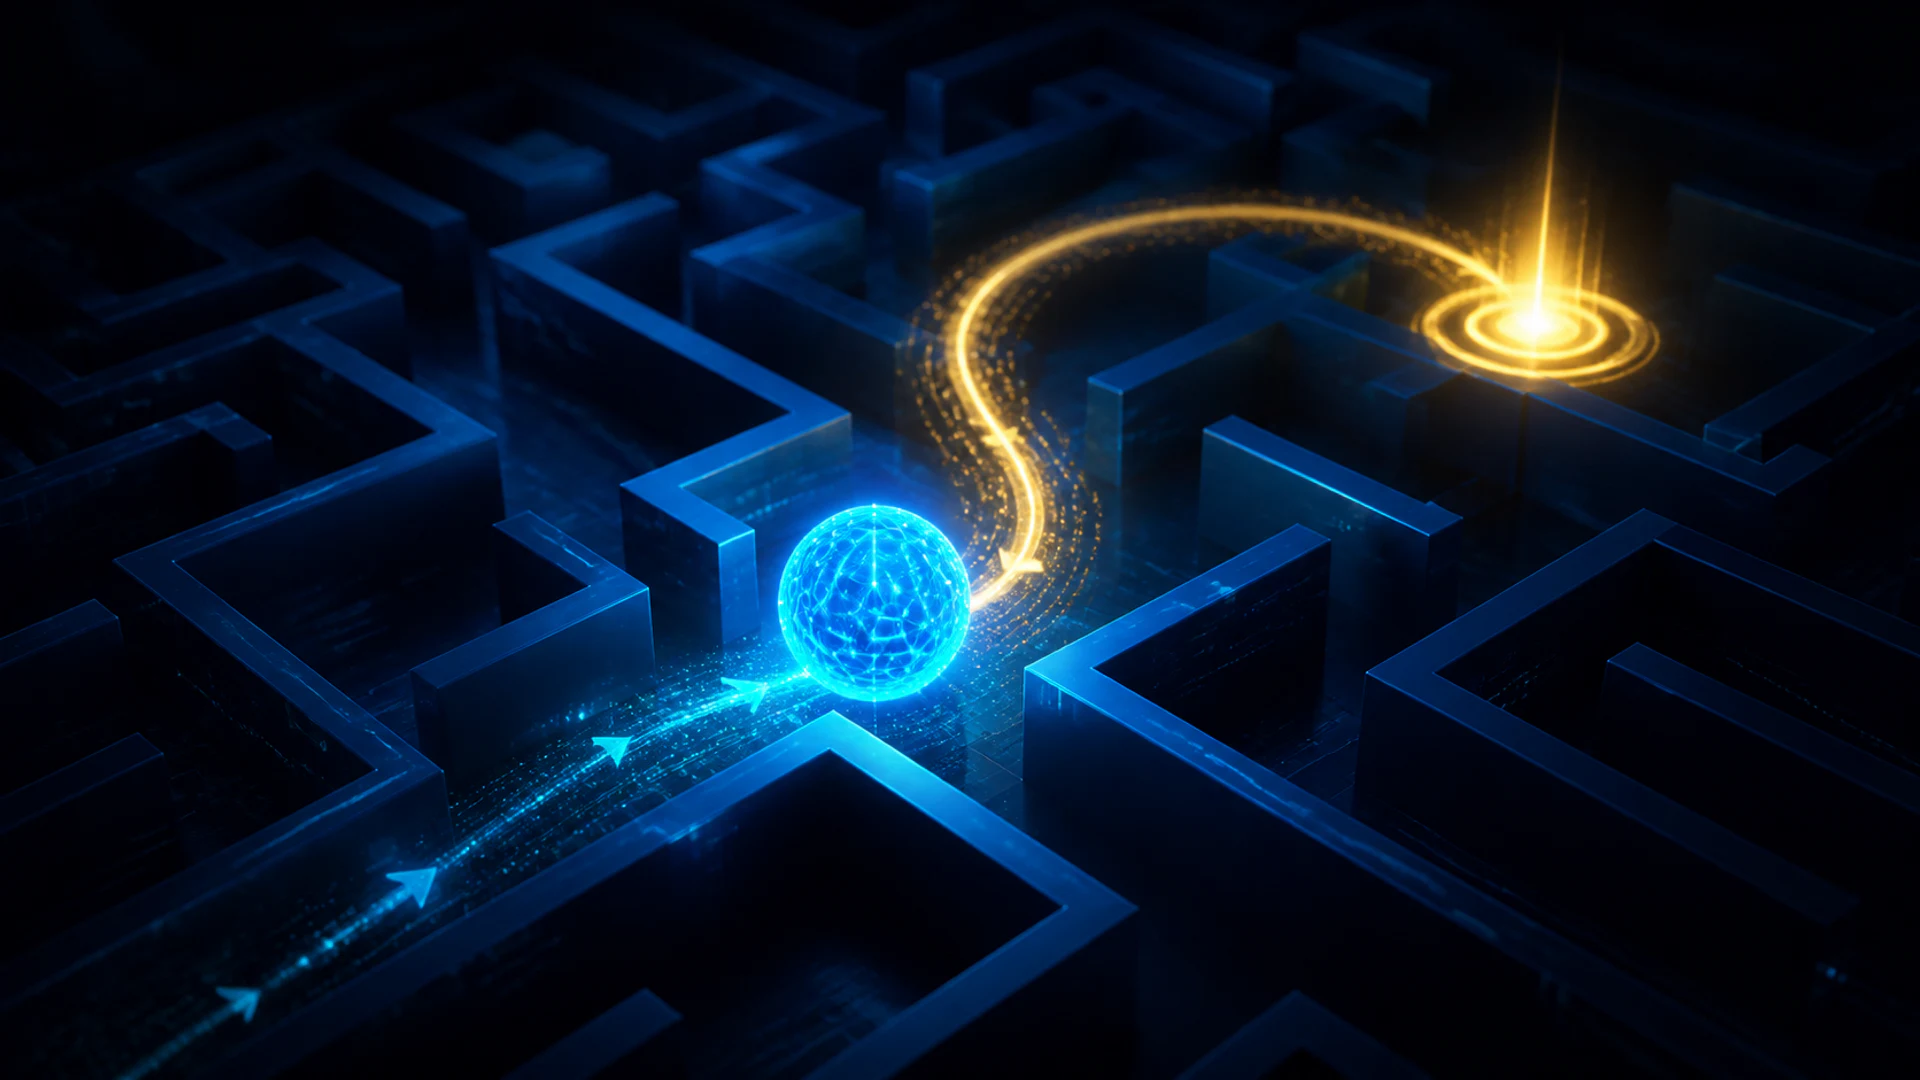
Reinforcement learning (RL) è un quadro di apprendimento automatico in cui un agente impara a comportarsi interagendo con un ambiente. Dopo ogni azione, l’ambiente cambia e può restituire una ricompensa. L’obiettivo dell’agente è apprendere una politica che massimizzi la ricompensa cumulativa attesa, non solo la ricompensa della prossima mossa.
Il RL viene impiegato quando le decisioni si sviluppano nel tempo e un’azione influenza ciò che accade successivamente. È concettualmente diverso dall’apprendimento supervisionato, in cui un dataset fornisce una risposta target per ogni esempio di addestramento.
Punti chiave
- Un problema di RL contiene un agente, un ambiente, stati, azioni, ricompense e una politica.
- Il rinforzo positivo e quello negativo aumentano entrambi il comportamento; la punizione lo diminuisce.
- L’agente deve bilanciare l’esplorazione di azioni sconosciute con lo sfruttamento di azioni già note per funzionare.
- I metodi basati sul valore, basati sulla politica, attore‑critico, basati su modello e offline risolvono diversi contesti di RL.
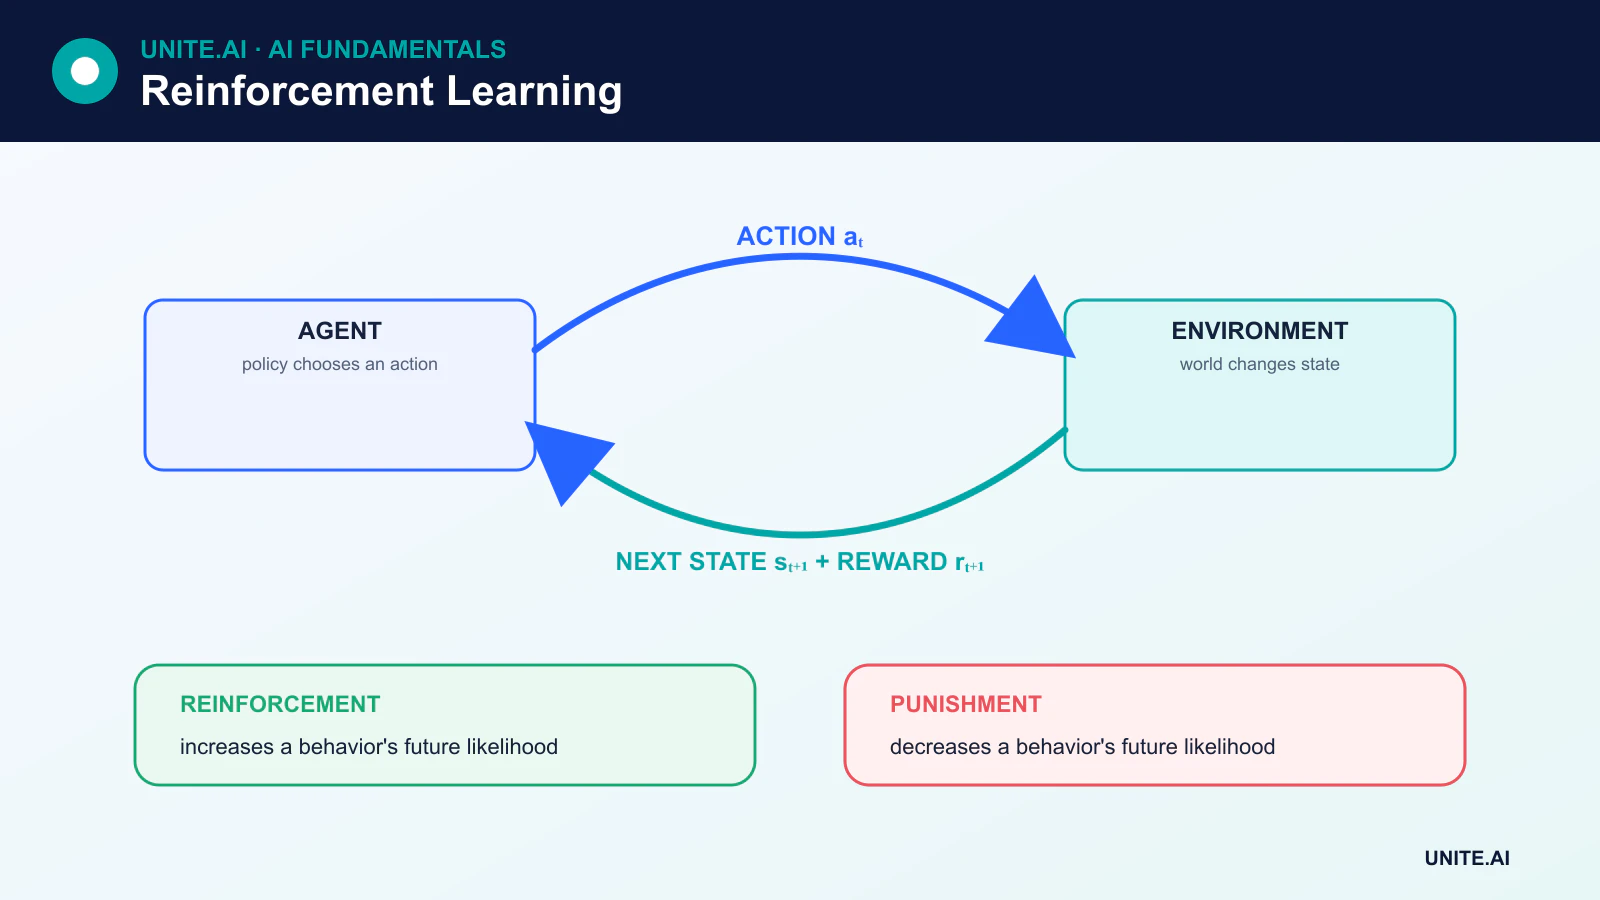
I componenti dell’apprendimento per rinforzo
Molti problemi di RL sono modellati come un processo decisionale di Markov (MDP). Un MDP include:
- State: informazioni che descrivono la situazione corrente.
- Action: una scelta disponibile per l’agente.
- Transition: come lo stato cambia dopo un’azione.
- Reward: feedback immediato prodotto da una transizione.
- Policy: la strategia dell’agente per selezionare le azioni.
- Discount factor: quanto fortemente le ricompense future contano rispetto a quelle immediate.
Uno stato non deve esporre tutto sul mondo. Quando informazioni importanti sono nascoste, il problema può essere parzialmente osservabile e l’agente potrebbe necessitare di una memoria o di uno stato di credenza.
Il rinforzo non è lo stesso della punizione
La terminologia proviene dalla psicologia comportamentale. Rinforzo positivo aggiunge una conseguenza che rende un comportamento più probabile. Rinforzo negativo rimuove una condizione spiacevole e rende anch’esso più probabile un comportamento. Una penalità intesa a rendere un’azione meno probabile è una punizione, non un rinforzo negativo.
Nel machine learning, i professionisti parlano più spesso direttamente di ricompense positive, ricompense negative, costi e penalità. La questione fondamentale è come questi segnali modellano il ritorno che l’agente cerca di massimizzare.
Ritorno, valore e assegnazione del credito
Una ricompensa descrive una transizione. Il ritorno combina le ricompense nel tempo, solitamente scontando quelle che arrivano più lontano nel futuro. Una funzione di valore di stato stima il ritorno atteso da uno stato, mentre una funzione di valore d’azione stima il ritorno atteso dopo aver compiuto una determinata azione in quello stato.
Questo genera il problema dell’assegnazione del credito: se un risultato utile arriva molto più tardi, quali azioni precedenti meritano il credito? Gli algoritmi RL differiscono nel modo in cui stimano questa relazione.
Apprendimento Monte Carlo e a differenza temporale
Metodi Monte Carlo apprendono da ritorni campionati completi, tipicamente dopo la fine di un episodio. Metodi a differenza temporale (TD) aggiornano una stima prima del risultato finale combinando la ricompensa osservata con una stima di ciò che seguirà. L’apprendimento TD quindi parte dalle sue stime di valore correnti.
Nessuna delle due famiglie è universalmente migliore. Gli obiettivi Monte Carlo sono non distorti sotto la politica campionata ma possono avere alta varianza e richiedono il completamento dell’episodio. I metodi TD possono apprendere online e da compiti continui, ma i loro obiettivi bootstrap introducono bias.
Esplorazione vs sfruttamento
Esplorazione raccoglie informazioni provando azioni il cui valore è incerto. Sfruttamento seleziona l’azione ritenuta attualmente la migliore in termini di ritorno. Un agente che non esplora mai può accontentarsi di una strategia scadente; un agente che non sfrutta mai non beneficia di ciò che ha appreso.
Le strategie semplici includono la selezione epsilon‑greedy, l’esplorazione basata sulla fiducia, i bonus di entropia e i metodi di ricompensa intrinseca. In contesti critici per la sicurezza, l’esplorazione illimitata può essere inaccettabile, quindi la simulazione, i vincoli, i dati offline o la supervisione umana diventano importanti.
Principali approcci di apprendimento per rinforzo
Metodi basati sul valore
Il Q‑learning e gli algoritmi correlati apprendono i valori delle azioni e derivano una politica selezionando azioni ad alto valore. Deep reinforcement learning utilizza reti neurali per approssimare le funzioni di valore o le politiche quando gli spazi di stato sono troppo grandi per una tabella.
Metodi a gradiente di politica
I metodi a gradiente di politica aggiustano direttamente una politica parametrizzata per migliorare il ritorno atteso. Sono utili per azioni continue e politiche stocastiche, ma possono avere stime del gradiente ad alta varianza.
Metodi attore‑critico
Un attore sceglie le azioni mentre un critico stima il valore e fornisce un segnale di apprendimento. Questo combina l’ottimizzazione diretta della politica con la stima del valore.
RL basato su modello e senza modello
I sistemi basati su modello apprendono o utilizzano un modello di transizioni e ricompense così da poter pianificare. I sistemi senza modello apprendono valori o politiche senza modellare esplicitamente l’ambiente. I metodi basati su modello possono sfruttare l’esperienza in modo efficiente, ma gli errori nel modello appreso possono fuorviare la pianificazione.
Apprendimento per rinforzo offline
Il RL offline apprende da un dataset fisso anziché raccogliere nuove interazioni durante l’addestramento. Può ridurre il costo o il rischio dell’esplorazione, ma l’agente deve evitare di sovrastimare azioni poco rappresentate nei dati.
RLHF e preferenze umane
Reinforcement learning from human feedback (RLHF) utilizza dati di preferenza per addestrare un segnale di ricompensa o ottimizzare direttamente una politica. È stato usato per allineare il comportamento dei modelli linguistici ai giudizi umani. L’ottimizzazione delle preferenze non garantisce verità o sicurezza: i risultati dipendono da chi ha fornito il feedback, da cosa è stato chiesto di giudicare e da come è stato progettato l’obiettivo.
Limitazioni
Il RL può richiedere un numero enorme di interazioni, comportarsi in modo instabile durante l’addestramento e sfruttare scorciatoie non intenzionali in una funzione di ricompensa. La valutazione è difficile perché i risultati possono variare con i semi casuali e i dettagli dell’ambiente. Le buone pratiche includono esecuzioni multiple, baseline trasparenti, obiettivi vincolati, test fuori distribuzione e monitoraggio per il reward hacking.
Progettare un problema di RL: stato, azione, ricompensa e orizzonte
L’apprendimento per rinforzo modella decisioni sequenziali. L’ambiente produce un’osservazione, l’agente seleziona un’azione secondo una politica e una transizione genera una ricompensa e l’osservazione successiva. Un processo decisionale di Markov assume che lo stato contenga le informazioni necessarie per prevedere le transizioni e le ricompense future; la parzialità di osservabilità richiede memoria, stato di credenza o rappresentazioni ricorrenti. Lo sconto controlla il peso degli esiti ritardati, mentre i compiti episodici e continui richiedono diverse definizioni di ritorno. Un cattivo design di stato o azione può rendere un obiettivo risolvibile non apprendibile.
Il design della ricompensa specifica il comportamento in modo indiretto ed è una delle principali fonti di fallimento. Un proxy può essere sfruttato: un agente ricompensato per la velocità può ignorare la sicurezza, mentre uno ricompensato solo al completamento del compito può ricevere un segnale di apprendimento troppo scarso. Aggiungere vincoli e regole di terminazione basate su requisiti reali, testare la sensibilità della ricompensa e ispezionare le traiettorie per strategie indesiderate. I metodi di esplorazione bilanciano la raccolta di informazioni con lo sfruttamento della conoscenza attuale. I dati off‑policy possono migliorare l’efficienza campionaria, ma la discrepanza tra politica comportamentale e target richiede algoritmi progettati per ciò.
Valutazione, simulazione e distribuzione sicura
I metodi basati sul valore stimano il ritorno atteso per stati o azioni; i metodi a gradiente di politica ottimizzano una politica parametrizzata; i metodi attore‑critico apprendono entrambi. Il RL basato su modello apprende o utilizza la dinamica di transizione per pianificare. La famiglia appropriata dipende dal tipo di azione, dai dati, dalla fedeltà del simulatore, dall’orizzonte e dai requisiti di stabilità. Confrontare con baseline euristiche, supervisionate e di teoria del controllo. Valutare il ritorno medio e nel caso peggiore, le violazioni di vincoli, l’efficienza campionaria, la robustezza ai cambiamenti dell’ambiente e la varianza tra i semi, invece di scegliere un’esecuzione con la curva di apprendimento migliore.
L’esplorazione online può essere inaccettabile in ambiti come la sanità, la finanza, la robotica e le infrastrutture. Addestrare in simulazione o con dati registrati dove possibile, quantificare il divario simulatore‑realtà e utilizzare la valutazione off‑policy con cautela poiché le azioni non viste non hanno supporto. La distribuzione dovrebbe limitare azioni, tassi, risorse e zona operativa; includere l’approvazione umana per scelte consequenziali; e fornire un controllore o spegnimento sicuro. Monitorare la ricompensa insieme ai risultati reali perché un agente può migliorare il punteggio danneggiando l’obiettivo previsto. Rivalutare dopo cambiamenti di ambiente, politica o ricompensa.
Esempio pratico: controllo energetico con apprendimento per rinforzo
Un operatore di edificio modella temperatura, occupazione, meteo, stato delle apparecchiature e prezzo dell’elettricità, con azioni limitate a regolazioni sicure dei setpoint. La ricompensa combina comfort, energia, costi di domanda e vincoli delle apparecchiature, ma le violazioni effettive del comfort vengono valutate separatamente così l’ottimizzazione della ricompensa non può nascondere danni. Il controllo storico e il controllo predittivo basato su modello forniscono baseline. L’addestramento utilizza un simulatore calibrato con meteo casuale, rumore dei sensori e efficienza delle apparecchiature.
Prima di influenzare l’edificio, la politica viene eseguita su osservazioni live senza intervenire. Gli ingegneri ispezionano le traiettorie, i margini di vincolo e il comportamento durante festività, ondate di calore, blackout e sensori mancanti. La distribuzione limita il tasso e l’intervallo delle azioni e mantiene il controllore di sicurezza esistente. Un umano può intervenire in qualsiasi momento. Il monitoraggio confronta energia e comfort con periodi corrispondenti, registra le interventi e annulla le modifiche se violazioni, cicli inattesi o discrepanze del modello superano le soglie definite.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo accattivante.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, preservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato di salute delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi esaminare le evidenze reali dopo la distribuzione invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto richiede inoltre procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disattivato o sostituito.
Riferimenti principali