
Fondamenti di IA
Che cos’è l’Apprendimento Ensemble?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Ensemble learning combina le previsioni di più modelli. L’idea centrale è che modelli con errori diversi possano produrre un risultato più accurato o più stabile quando i loro output vengono mediati, votati o passati a un meta‑learner.
Aggiungere modelli non è sufficiente. Se ogni membro impara la stessa scorciatoia, i loro errori saranno correlati e l’ensemble potrebbe semplicemente diventare più sicuro dello stesso errore.
Punti chiave
- Gli ensemble funzionano meglio quando i modelli membri sono utili singolarmente e commettono errori significativamente diversi.
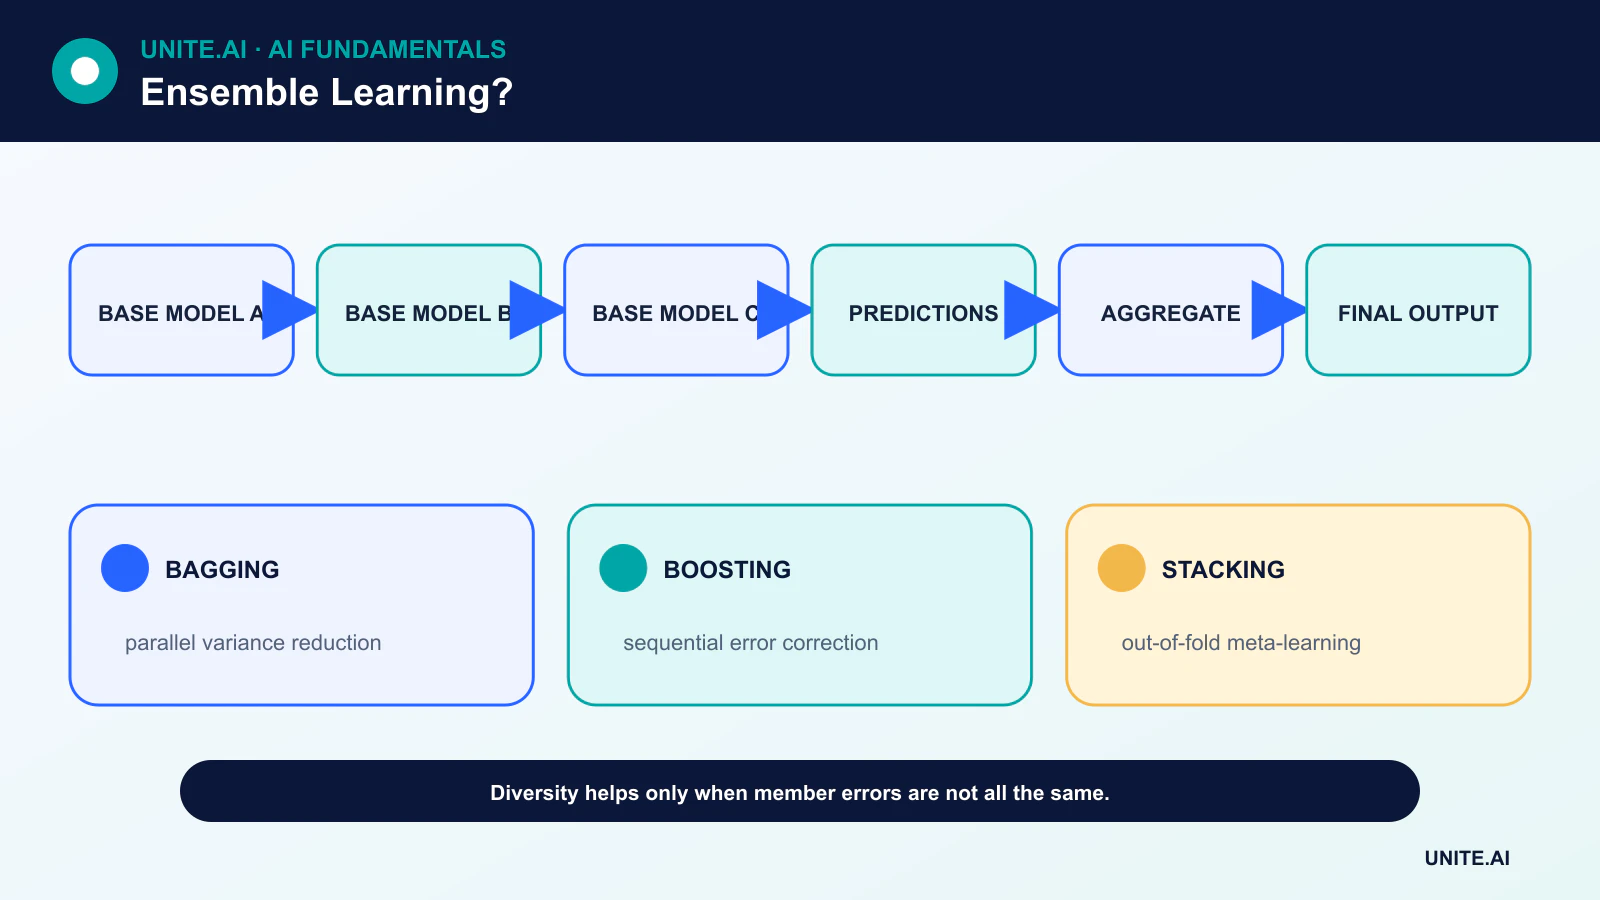
- Il bagging addestra i membri in parallelo su dati ricampionati; il boosting addestra i learner in sequenza per correggere gli errori.
- Lo stacking addestra un meta‑modello su previsioni out‑of‑fold, non su previsioni in‑sample.
- I guadagni di accuratezza devono essere valutati rispetto a latenza, calibrazione, interpretabilità e costi di manutenzione.
Votazione e media
Il voto rigido (hard voting) seleziona la classe con il maggior numero di voti. Il voto morbido (soft voting) media le probabilità di classe, solitamente dopo la calibrazione. Gli ensemble di regressione spesso mediano le previsioni numeriche. Le versioni ponderate danno maggiore influenza ai membri più forti.
Una media può ridurre la varianza quando gli errori non sono perfettamente correlati. Non può correggere un difetto di dati condiviso, un errore di etichettatura o un sotto‑gruppo mancante. La diversità dovrebbe essere misurata attraverso il disaccordo e la sovrapposizione degli errori, non assunta dai diversi nomi dei modelli.
Bagging e foreste casuali
Il bootstrap aggregating (bagging) addestra i modelli su set di dati ricampionati e li media. Un albero decisionale ha alta varianza, il che lo rende un candidato naturale per il bagging.
Le foreste casuali aggiungono una selezione casuale delle caratteristiche durante le divisioni, riducendo la correlazione tra gli alberi. Gli esempi out‑of‑bag possono stimare le prestazioni, ma un set di test finale non toccato rimane prezioso per la selezione del modello e le affermazioni di deployment.
Boosting
Il boosting costruisce un modello additivo a tappe. I learner successivi si concentrano su esempi o pattern residui che l’ensemble corrente gestisce male. AdaBoost modifica i pesi degli esempi; gradient boosting adatta i learner ai gradienti negativi di una loss scelta.
Gli alberi boostati possono modellare relazioni tabulari complesse, ma alberi profondi, troppi round e leakage possono comunque overfittare. Il tasso di apprendimento, la profondità dell’albero, il sotto‑campionamento e l’interruzione precoce sono controlli chiave.
Stacking e blending
Lo stacking crea un modello di secondo livello che impara a combinare le previsioni di base. Per evitare leakage, ogni riga di training per il meta‑modello deve provenire da un modello di base che non è stato addestrato su quella riga. La cross‑validation genera queste previsioni out‑of‑fold.
Il blending utilizza un set di holdout separato per il meta‑modello, il che è più semplice ma riduce i dati disponibili per il training. Entrambi gli approcci richiedono la stessa pre‑elaborazione e il controllo di versione in fase di inferenza.
Compromessi operativi
Un ensemble può moltiplicare l’uso di memoria, calcolo e i modi di fallimento. Può essere più difficile da spiegare, calibrare e aggiornare in modo coerente. La distillazione può comprimere un ensemble in un modello più piccolo, ma lo studente deve essere valutato in modo indipendente.
Una selezione pratica confronta prestazioni, latenza di coda, calibrazione, utilizzo delle risorse e costo degli errori. A volte un modello ben regolarizzato è preferibile a un piccolo guadagno di accuratezza da uno stack fragile.
Perché gli ensemble funzionano
L’apprendimento ensemble combina più modelli in modo che i loro errori si annullino parzialmente o i loro punti di forza coprano regioni diverse. Il bagging addestra i modelli su dati ricampionati e media le previsioni, riducendo la varianza; le foreste casuali aggiungono una selezione casuale delle caratteristiche per decorrelare gli alberi. Il boosting addestra i learner in sequenza per concentrarsi sull’errore residuo, spesso riducendo il bias ma aumentando la sensibilità al rumore e alla sintonizzazione. Lo stacking addestra un meta‑modello sulle previsioni dei modelli di base. La diversità deve essere utile: mediare modelli identici aggiunge costi senza una significativa riduzione dell’errore.
La correlazione tra gli errori determina il beneficio. La diversità può derivare da campioni di dati, caratteristiche, algoritmi, iperparametri, inizializzazione casuale o finestre temporali. Il voto rigido scarta la fiducia; il voto morbido media le probabilità ma richiede una calibrazione compatibile. La regressione può mediare o utilizzare aggregazioni robuste. Nello stacking, le previsioni out‑of‑fold sono essenziali — addestrare il meta‑modello su previsioni di base provenienti dagli stessi dati addestrati provoca leakage. Mantieni una baseline di media semplice prima di adottare un combinatore complesso.
Valutazione, calibrazione e incertezza
Confronta ogni membro e l’ensemble su un set di hold‑out con pre‑elaborazione identica. Riporta metriche di task, calibrazione, errori per sotto‑gruppi, varianza tra fold o seed, e costo delle risorse. Un ensemble può migliorare la qualità media nascondendo un punto cieco condiviso causato da dati o etichette comuni. Ispeziona il disaccordo: può identificare incertezza, ma modelli correlati e sicuri nel loro errore possono concordare. Calibra l’ensemble finale, non solo i membri, e valida le soglie di astensione rispetto alla capacità di revisione e alle conseguenze.
Le stime out‑of‑bag sono utili per i modelli bagged ma non sostituiscono un test finale rappresentativo del deployment. Per dati temporali, evita il ricampionamento che rompe l’ordine. Per usi legati alla sicurezza, testa i fallimenti dei membri, i modelli obsoleti e gli input avversari. Gli ensemble ponderati possono overfittare i dati di validazione quando si provano molti candidati. Registra la selezione dei candidati e utilizza una validazione nidificata quando la sintonizzazione è estensiva.
Distribuzione e manutenzione
Gli ensemble moltiplicano memoria, latenza, energia e dipendenze operative. La distillazione può comprimere il comportamento combinato in un unico modello, con una nuova esigenza di validazione. Versiona i membri, la pre‑elaborazione, i pesi e il routing come un unico artefatto; definisci il comportamento quando un membro scade o produce un risultato non valido. Monitora le previsioni dei membri e il disaccordo così che i fallimenti silenziosi siano visibili. Ritira i membri ridondanti e riaddestra deliberatamente. Gli ensemble migliorano la previsione quando la diversità degli errori è reale, ma non trasformano dati di training distorti o un target non valido in evidenza affidabile.
Esempio pratico: un ensemble per avvisi di tempo severo
Un team di previsione combina un set di caratteristiche di modello fisico, un albero gradient‑boosted, un modello neurale sequenziale e una baseline statistica calibrata. Le previsioni out‑of‑fold addestrano un meta‑modello semplice, e la valutazione utilizza tempeste future interamente escluse dall’addestramento dei membri. Le metriche includono recall degli eventi, falsi allarmi, tempo di anticipo, calibrazione, performance geografica e affidabilità durante condizioni estreme rare. La correlazione degli errori dei membri è esaminata perché i dati di input condivisi possono creare punti ciechi condivisi.
Il servizio conserva ogni previsione e il risultato combinato. Se un membro non è disponibile, il sistema utilizza una configurazione degradata pre‑validata anziché rinormalizzare silenziosamente. Il disaccordo induce una revisione aggiuntiva ma non è trattato come incertezza in tutti i casi. Il monitoraggio traccia il drift dei membri, la latenza e gli esiti delle tempeste, con i pesi aggiornati solo tramite validazione controllata. Gli avvisi pubblici rimangono sotto i processi decisionali meteorologici autorizzati; l’ensemble migliora le evidenze ma non ridefinisce autonomamente la politica di allerta.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misura la qualità del task insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia così che un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci le soglie di allerta e un responsabile di risposta, poi esamina le evidenze reali dopo il deployment invece di presumere che le performance offline persistano. Rivaluta ogni volta che le fonti dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui dovrebbe essere disabilitato o sostituito.
Domande frequenti
Una foresta casuale è un ensemble?
Sì. Combina molti alberi decisionali randomizzati, solitamente tramite voto o media.
I modelli identici possono formare un ensemble utile?
Possono farlo se i dati di addestramento, l’inizializzazione o il campionamento creano errori sufficientemente diversi, ma una mera duplicazione non apporta alcun beneficio.
Riferimenti principali












