
Fondamenti di IA
Cos’è una rete generativa avversaria (GAN)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Una rete generativa avversaria (GAN) addestra due reti neurali in competizione. Un generatore converte input casuali o condizionati in campioni sintetici. Un discriminatore cerca di distinguere i campioni generati da esempi reali di addestramento. Il feedback di ciascuna rete modifica il problema di apprendimento dell’altra.
Le GAN possono creare immagini nitide e dati sintetici controllabili, ma l’addestramento avversario è difficile da stabilizzare. Il realismo visivo non è prova di diversità, validità fattuale o autorizzazione all’uso dei dati di addestramento.
Punti chiave
- Il generatore produce campioni; il discriminatore apprende un segnale decisionale reale‑vs‑generato.
- L’addestramento cerca un equilibrio, ma cambiare gli avversari può provocare instabilità, oscillazione o collasso di modalità.
- Le GAN condizionali controllano la generazione con etichette, testo o altro contesto.
- La valutazione dovrebbe testare fedeltà, copertura, memorizzazione e rischi a valle — non solo la qualità dell’immagine.
Il gioco avversario
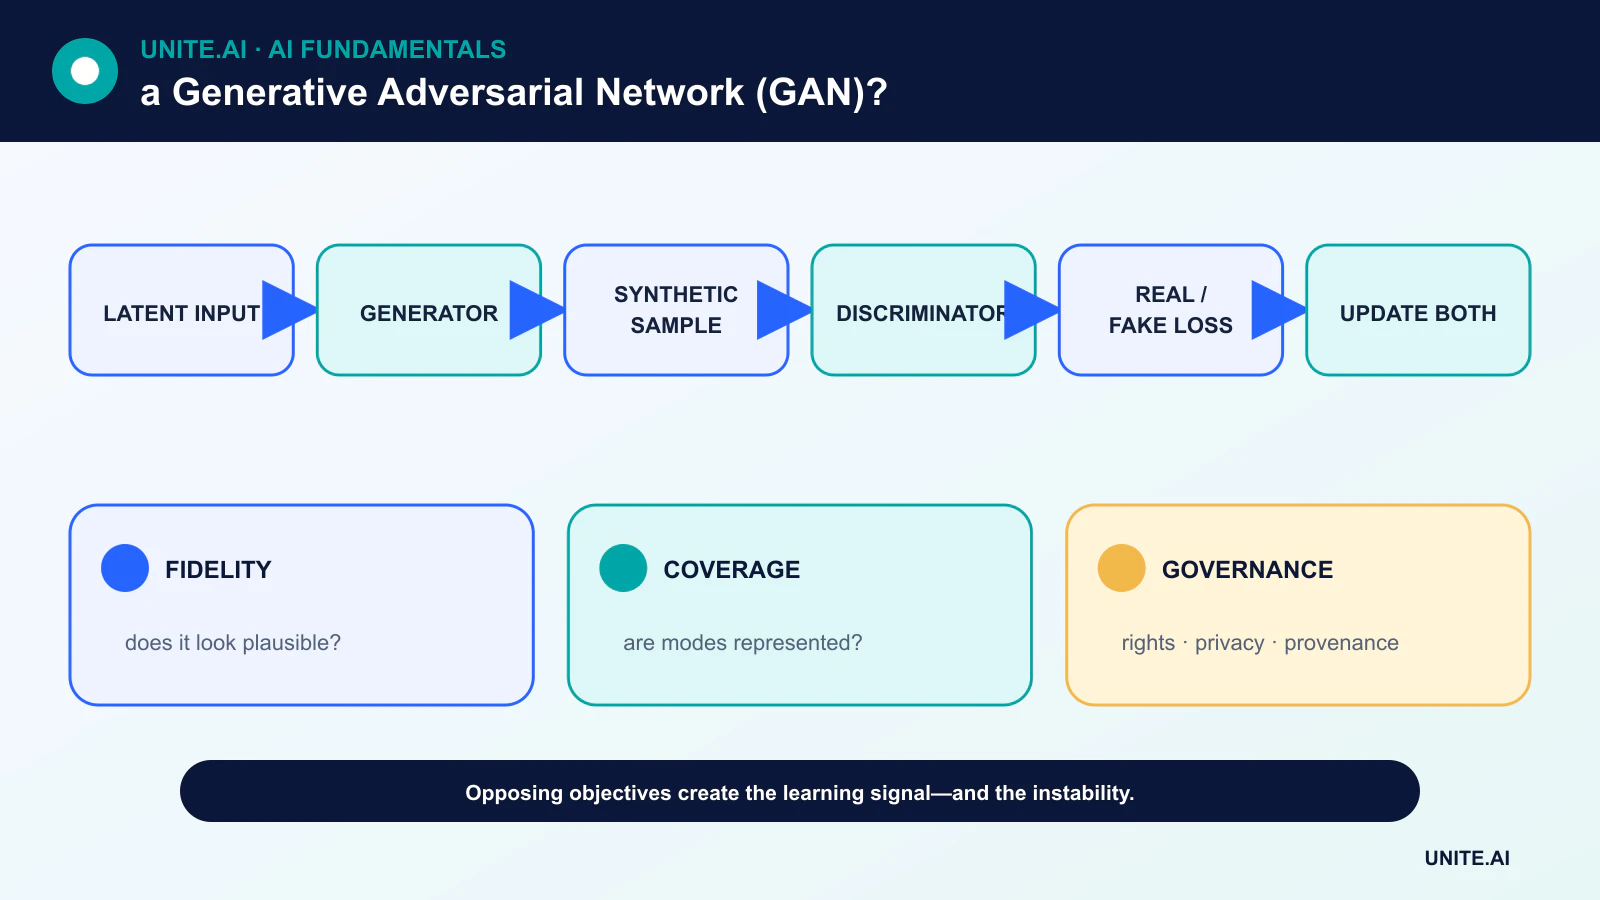
La formulazione originale è un gioco minimax a due giocatori. Il discriminatore migliora nel separare dati reali da dati generati, mentre il generatore migliora nel creare campioni che il discriminatore classifica come reali. Entrambi sono addestrati con la retropropagazione.
Se il discriminatore diventa troppo preciso, il suo feedback al generatore può risultare poco utile. Se è troppo debole, il generatore può sfruttare scorciatoie semplici. L’addestramento alterna quindi gli aggiornamenti e bilancia con attenzione capacità, perdite e impostazioni di ottimizzazione.
Collasso di modalità e stabilità dell’addestramento
Il collasso di modalità si verifica quando molti input latenti producono output simili, così i campioni sembrano plausibili ma coprono solo una parte della distribuzione dei dati. Altri fallimenti includono oscillazione, gradienti esplosivi e sensibilità all’inizializzazione casuale.
Obiettivi Wasserstein, penalità sui gradienti, normalizzazione spettrale, modifiche all’architettura e rapporti di aggiornamento ottimizzati possono migliorare la stabilità. Non eliminano la necessità di verificare la diversità e ripetere gli esperimenti con più seed.
Generazione condizionale e controllo latente
Una GAN condizionale fornisce al generatore e al discriminatore un’etichetta o altro contesto, consentendo classi o attributi mirati. Le architetture basate sullo stile separano gli aspetti del controllo latente a diverse risoluzioni e hanno prodotto immagini estremamente realistiche.
Le direzioni latenti possono correlarsi con concetti umani, ma modificare un attributo può alterare gli altri perché i dati di addestramento contengono caratteristiche correlate. Le affermazioni di controllabilità dovrebbero essere testate su identità e contesti diversi.
Valutazione, privacy e provenienza
Metriche come il Fréchet Inception Distance confrontano le distribuzioni delle caratteristiche, ma ereditano le assunzioni dal modello di feature e possono non rilevare memorizzazione o fallimenti di sottogruppi. Analisi dei vicini più prossimi, test di copertura in stile precision/recall e revisioni umane forniscono evidenze complementari.
Una GAN può memorizzare esempi rari, riprodurre bias o generare media ingannevoli. I team dovrebbero documentare i set di dati, i diritti, i filtri, i meccanismi di watermark o di provenienza e i controlli di abuso. I dati sintetici non sono automaticamente anonimi.
GAN, VAE e modelli di diffusione
Gli autoencoder variazionali ottimizzano un obiettivo latente basato sulla verosimiglianza e spesso scambiano la nitidezza dei campioni per uno spazio latente strutturato. I modelli di diffusione imparano a invertire un processo di rumorizzazione e sono diventati una base comune per la generazione di immagini.
Le GAN rimangono utili quando è importante un campionamento rapido in un unico passo, mappature immagine‑a‑immagine specifiche o un’implementazione compatta. Il metodo appropriato dipende da qualità, diversità, latenza, stabilità dell’addestramento e governance — non da quale architettura sia la più recente.
Obiettivi avversari e dinamiche di addestramento
Una rete generativa avversaria addestra un generatore a produrre campioni e un discriminatore a distinguere i dati generati da quelli reali. Nel gioco minimax originale, il discriminatore stima un segnale correlato al rapporto di densità e il generatore cerca di ingannarlo. L’addestramento alterna gli aggiornamenti, così ogni rete apprende contro un avversario in movimento anziché una perdita fissa. Se il discriminatore diventa troppo forte, i gradienti del generatore possono diventare poco utili; se è troppo debole, la qualità dei campioni generati si stagna. Il valore della perdita da solo non corrisponde direttamente alla qualità dei campioni.
Il collasso di modalità si verifica quando il generatore produce varietà limitate che ingannano il discriminatore. Oscillazione, sensibilità agli iperparametri e normalizzazione instabile sono anch’essi comuni. Obiettivi Wasserstein, penalità sui gradienti, normalizzazione spettrale, corrispondenza delle feature, statistiche minibatch e programmi di aggiornamento attentamente bilanciati affrontano diversi meccanismi di fallimento. Le GAN condizionali usano etichette, testo o immagini per guidare l’output; le architetture basate sullo stile separano le influenze latenti. La qualità e la copertura del set di dati rimangono fondamentali perché il generatore riproduce e ricombina la distribuzione che osserva.
Valutazione e uso responsabile
Valuta separatamente fedeltà e diversità. Il Fréchet Inception Distance confronta le distribuzioni delle feature ma dipende da dimensione del campione, modello di feature, pre‑elaborazione e dominio; l’Inception Score omette il confronto con dati reali. Precisione e richiamo per i modelli generativi, analisi dei vicini più prossimi, controlli di memorizzazione e valutazioni umane di compiti aggiungono evidenze. Per sintesi scientifiche o mediche, utilizza metriche di dominio e validazione a valle. Conserva un set reale di riserva e confronta con baseline di diffusione o autoregressive a pari capacità computazionale e risoluzione.
Le GAN possono arricchire i dati, tradurre domini, super‑risolvere immagini, sintetizzare media e supportare simulazioni, ma i dati sintetici possono amplificare bias o rivelare esempi di addestramento. Verifica licenze, consenso, identità e provenienza. Proteggi contro l’impersonificazione non consensuale e l’uso ingannevole, etichetta o firma gli output quando opportuno e conserva i metadati di generazione. Un’immagine fotorealistica non è prova documentale; incertezza e origine sintetica devono rimanere visibili quando gli output influenzano decisioni.
Distribuzione e riproducibilità
Registra generatore, discriminatore, ottimizzatore, set di dati, seed casuale, troncamento e impostazioni di campionamento. Quantizzazione o esportazione possono alterare la normalizzazione e l’output, quindi valida l’artefatto di servizio. Monitora la distribuzione di prompt o condizioni, filtri di sicurezza, diversità dell’output, latenza e report. Usa limiti di velocità e protezioni d’identità nei sistemi pubblici. L’addestramento di una GAN è un esperimento di ottimizzazione accoppiata: le immagini dimostrative selezionate non possono garantire robustezza, copertura o assenza di memorizzazione, e un modello dovrebbe essere valutato sull’intera distribuzione dei compiti di generazione previsti.
Esempio pratico: immagini sintetiche di difetti con una GAN
Un produttore addestra una GAN condizionale per creare immagini rare di difetti di superficie. Verifica che le immagini di addestramento siano coperte da diritti e separa i lotti di produzione prima dell’addestramento e della valutazione. I campioni generati sono controllati per memorizzazione dei vicini più prossimi, geometria del difetto, artefatti di sfondo, diversità e plausibilità da parte di esperti. Un classificatore addestrato con augmentazione sintetica è valutato solo su difetti reali indipendenti, confrontandolo con lo stesso classificatore con augmentazione convenzionale.
I dati sintetici sono accettati solo se il richiamo nel mondo reale migliora senza aumentare i falsi rifiuti o gli errori di sottogruppo. Le impostazioni di generazione e la provenienza rimangono allegate a ogni immagine, e i file sintetici non entrano mai nel set di test o nell’archivio delle evidenze come ispezioni reali. Gli operatori non possono usare il generatore per fabbricare registri di audit. Il team confronta le alternative di diffusione e il costo di raccogliere più esempi reali, riconoscendo che l’aspetto realistico non è prova che la GAN abbia catturato il processo fisico di guasto.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, mantieni un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile della risposta, quindi esamina le evidenze del mondo reale dopo la distribuzione anziché presumere che le prestazioni offline persistano. Rivaluta ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Una GAN comprende le immagini che crea?
Una GAN apprende la struttura statistica utile per la generazione. Questo non stabilisce, di per sé, una comprensione semantica o causale simile a quella umana.
I campioni generati da una GAN sono sicuri da usare come dati di addestramento?
Solo dopo aver verificato copertura, validità delle etichette, memorizzazione, bias e se la distribuzione sintetica è utile su un set di test reale di riserva.
Riferimenti principali












