Fondamenti di IA
Cos’è l’apprendimento few-shot?

 Aggiungi Unite.AI alle tue fonti preferite su Google
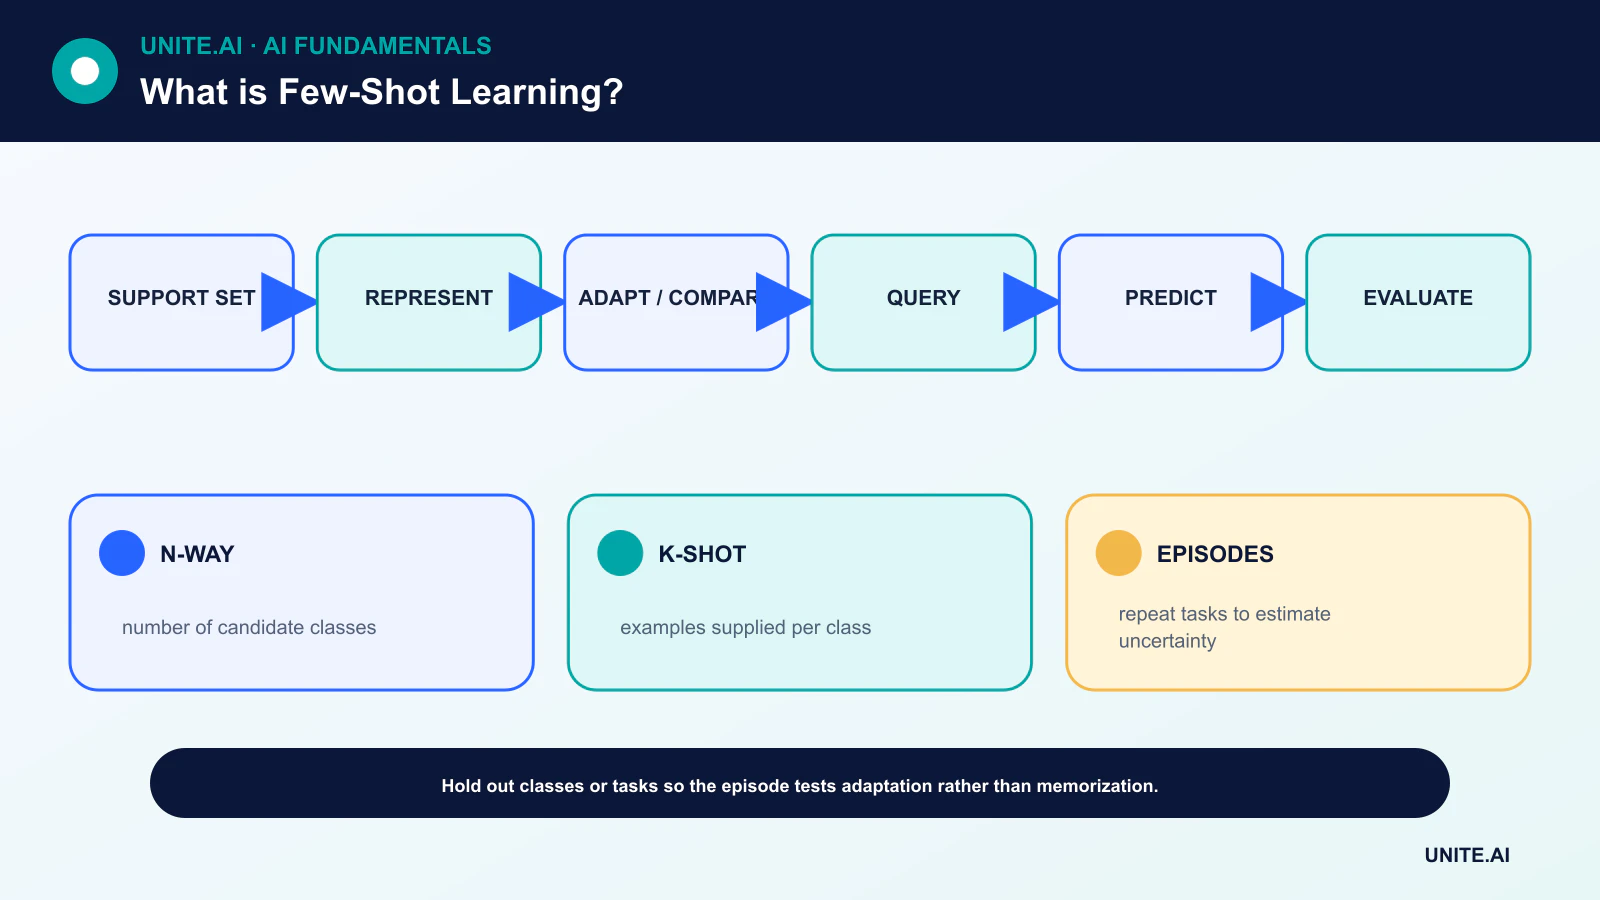
Few-shot learning studia come un modello possa adattarsi a un nuovo compito o classe usando solo un piccolo numero di esempi etichettati. Nei benchmark classici, un episodio fornisce un set di supporto — ad esempio cinque classi con uno o cinque esempi per classe — e richiede al modello di classificare query non viste.
Il termine è usato anche per l’apprendimento in contesto, in cui un modello linguistico preaddestrato riceve alcune dimostrazioni nel prompt senza aggiornare i parametri. Queste impostazioni condividono l’obiettivo di pochi esempi ma impiegano meccanismi di adattamento diversi e richiedono progetti di valutazione differenti.
Punti chiave
- N-way K-shot descrive N classi e K esempi di supporto etichettati per classe.
- I metodi di metric learning confrontano le query con le rappresentazioni apprese degli esempi di supporto.
- Il meta‑learning ottimizza su molti compiti affinché un nuovo compito possa essere appreso rapidamente.
- Pochi esempi amplificano errori di etichettatura, perdite, ambiguità di classe e incertezza, perciò le baseline e la segnalazione della confidenza sono importanti.
Episodi, set di supporto e set di query
Un episodio few-shot separa un piccolo set di supporto etichettato da un set di query usato per la valutazione. Durante il meta‑training, il modello vede molti di questi episodi. Una valutazione rigorosa esclude intere classi, compiti o domini così che l’episodio di test misuri l’adattamento piuttosto che la memorizzazione.
Riporta le distribuzioni di accuratezza su molti episodi anziché su un unico campione comodo. Confronta con baseline semplici di nearest‑neighbor e lineari; un metodo sofisticato che non supera una buona rappresentazione più un classificatore di base potrebbe non giustificare la sua complessità.
Apprendimento metrico e prototipi
Le matching networks e metodi correlati incorporano gli esempi di supporto e di query in uno spazio in cui vettori vicini dovrebbero condividere la stessa etichetta. Le prototypical networks mediano le embedding di supporto per ciascuna classe e classificano una query in base alla distanza da quei prototipi di classe.
Ciò collega l’apprendimento few-shot alla qualità della rappresentazione. Un modello deep‑learning preaddestrato può già organizzare bene le caratteristiche rilevanti, mentre una rappresentazione non adeguata può rendere ogni distanza fuorviante.
Meta‑learning basato su ottimizzazione
Il Model‑Agnostic Meta‑Learning ricerca parametri che possano adattarsi con un piccolo numero di passi di gradiente. Altri metodi apprendono un ottimizzatore, un’inizializzazione o una regola di aggiornamento dei parametri. Il ciclo esterno valuta le prestazioni post‑adattamento su più compiti.
Il meta‑learning assume che strutture utili siano condivise tra i compiti di addestramento e quelli target. Quando la distribuzione target differisce nettamente, l’adattamento rapido può fallire. La validazione dovrebbe variare il numero di shot, le classi, i domini e la difficoltà del compito invece di trattare un singolo benchmark come universale.
Apprendimento per trasferimento e strategie a livello di dati
Transfer learning è spesso il punto di partenza pratico più forte: congela un encoder preaddestrato, addestra una piccola testa, poi affina selettivamente se ci sono dati sufficienti. L’augmentation dei dati può introdurre invarianze, ma esempi sintetici irrealistici possono amplificare bias o creare scorciatoie.
L’active learning può dare priorità a quali esempi etichettare, mentre il semi‑supervised learning può usare dati non etichettati aggiuntivi. Queste sono strategie complementari, non sinonimi dell’apprendimento few-shot.
Il prompting few-shot è diverso
Un transformer può inferire un pattern dalle dimostrazioni inserite nel suo contesto. Non è necessario alcun aggiornamento persistente dei parametri. Ordine, formulazione e bilanciamento delle etichette possono cambiare materialmente l’output, e gli esempi possono occupare gran parte della finestra di contesto.
Usa un set di valutazione rappresentativo, versiona ogni prompt e dimostrazione, e testa alternative zero‑shot, few‑shot e fine‑tuned. Un set di supporto minuscolo non sostiene affermazioni robuste a livello di popolazione, specialmente per casi rari o critici per la sicurezza.
Paradigmi di apprendimento few-shot e costruzione dei compiti
L’apprendimento few-shot mira a svolgere un compito con pochissimi esempi etichettati. Nei metodi basati su metriche, un encoder mappa gli esempi in uno spazio dove i prototipi o i vicini più prossimi rappresentano le classi. Il meta‑learning basato su ottimizzazione addestra un’inizializzazione o una regola di aggiornamento per un’adattamento rapido. L’apprendimento per trasferimento affina un modello preaddestrato su un piccolo set target. L’apprendimento in‑contesto fornisce esempi in un prompt senza aggiornare i pesi. Questi meccanismi differiscono, quindi le affermazioni dovrebbero specificare se i parametri cambiano, quale addestramento pregresso è avvenuto e come vengono selezionati gli esempi.
La valutazione dovrebbe separare classi, compiti, soggetti o domini di addestramento e di test secondo la generalizzazione dichiarata. Un episodio N‑way K‑shot contiene N classi e K esempi di supporto per classe, più esempi di query per la valutazione. Episodi ripetuti stimano la varianza dovuta alla selezione del supporto. Per il prompting, ordine degli esempi, formulazione delle etichette, formato e similarità delle dimostrazioni possono cambiare materialmente i risultati. Confronta con baseline zero‑shot, nearest‑neighbor, linear‑probe e fine‑tuning ordinario usando la stessa rappresentazione e lo stesso budget di dati.
Qualità dei dati, incertezza e trasferimento negativo
Con pochi esempi, casi etichettati erroneamente o atipici hanno un’influenza sproporzionata. Definisci regole di annotazione, ispeziona ogni elemento di supporto e conserva un risultato “sconosciuto” o di astensione. L’augmentation dei dati e gli esempi sintetici possono aiutare solo se preservano il compito e aggiungono variazioni realistiche. Un modello preaddestrato può trasferire scorciatoie o bias dal suo dominio di origine. Testa casi fuori dominio, gruppi rari e sensibilità alla rimozione di un singolo esempio di supporto. Riporta intervalli di confidenza su più compiti e seed casuali, non un unico prompt favorevole.
L’active learning può richiedere etichette su casi informativi, mentre i metodi semi‑supervised usano dati non etichettati sotto ulteriori assunzioni. Il retrieval può selezionare dimostrazioni rilevanti dinamicamente ma deve evitare perdite di etichette di test. L’adattamento può sovradattarsi rapidamente, quindi vincola gli aggiornamenti, usa regolarizzazioni e valida su esempi separati. Per compiti ad alto rischio, pochi label raramente giustificano decisioni autonome; usa il modello per dare priorità o assistere la revisione finché non esistono evidenze sufficienti di risultato.
Operatività in produzione
Versiona il modello di base, l’embedding o il template del prompt, le dimostrazioni, lo schema delle etichette e i parametri di adattamento. Proteggi gli esempi perché prompt o gradienti possono esporre record sensibili. Monitora le prestazioni man mano che classi e linguaggio cambiano, e rinnova gli esempi di supporto tramite revisione governata anziché auto‑etichettatura automatica. L’apprendimento few-shot riduce la necessità di dati etichettati target sfruttando strutture pregresse; non elimina la necessità di valutazioni rappresentative, definizione accurata del compito, competenza di dominio o un fallback sicuro quando il nuovo compito si colloca fuori da tali premesse.
Esempio pratico: classificazione few-shot per un nuovo prodotto
Un team di supporto necessita di etichette di instradamento per un prodotto con solo cinque esempi revisionati per problema. Confronta prototipi più vicini in un embedding preaddestrato, una testa lineare, fine‑tuning a efficienza parametrica e prompting in‑contesto. Famiglie di prodotto, clienti e messaggi successivi sono esclusi dal meta‑training e dalla selezione del modello. Campionamenti ripetuti del set di supporto riportano richiamo per classe, calibrazione, varianza e sensibilità a una dimostrazione errata.
Messaggi a bassa confidenza o non supportati vengono instradati al supporto generale, e i revisori correggono le etichette tramite una coda governata. Gli esempi sono de‑identificati, versionati e mai selezionati dal set di test finale. Il monitoraggio traccia nuovo vocabolario, tassi di classe, correzioni e disaccordi. Quando si accumulano sufficienti etichette, il sistema few-shot è confrontato con un addestramento supervisionato ordinario. L’installazione rapida è utile, ma non giustifica l’automazione se le prestazioni rimangono instabili o se il nuovo prodotto differisce sostanzialmente dalle famiglie di compiti precedenti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più a rischio di essere trascurati. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia così che un revisore indipendente possa riprodurre il risultato e distinguere evidenza da un prototipo attraente.
Prima del lancio, assegna autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Usa un rollout a tappe, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare qualità dell’input, comportamento dell’output, versione del modello o della regola, salute delle dipendenze, override umani e risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allerta e un responsabile della risposta, poi rivedi le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogniqualvolta le fonti dati, gli utenti, i modelli, i fornitori, le policy, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un chiaro punto in cui debba essere disattivato o sostituito.
Domande frequenti
L’apprendimento one-shot è lo stesso dell’apprendimento few-shot?
L’apprendimento one-shot è il caso speciale con un singolo esempio di supporto etichettato per classe o compito. L’apprendimento zero-shot utilizza nessun esempio target etichettato.
L’apprendimento few-shot elimina la necessità di dati?
No. Sposta la dipendenza verso dati di pre‑addestramento, compiti correlati, rappresentazioni e assunzioni. Le etichette target sono poche; la storia di apprendimento totale è solitamente ampia.
Riferimenti principali