Fondamenti di IA
Cos’è l’Edge AI e l’Edge Computing?

 Aggiungi Unite.AI alle tue fonti preferite su Google
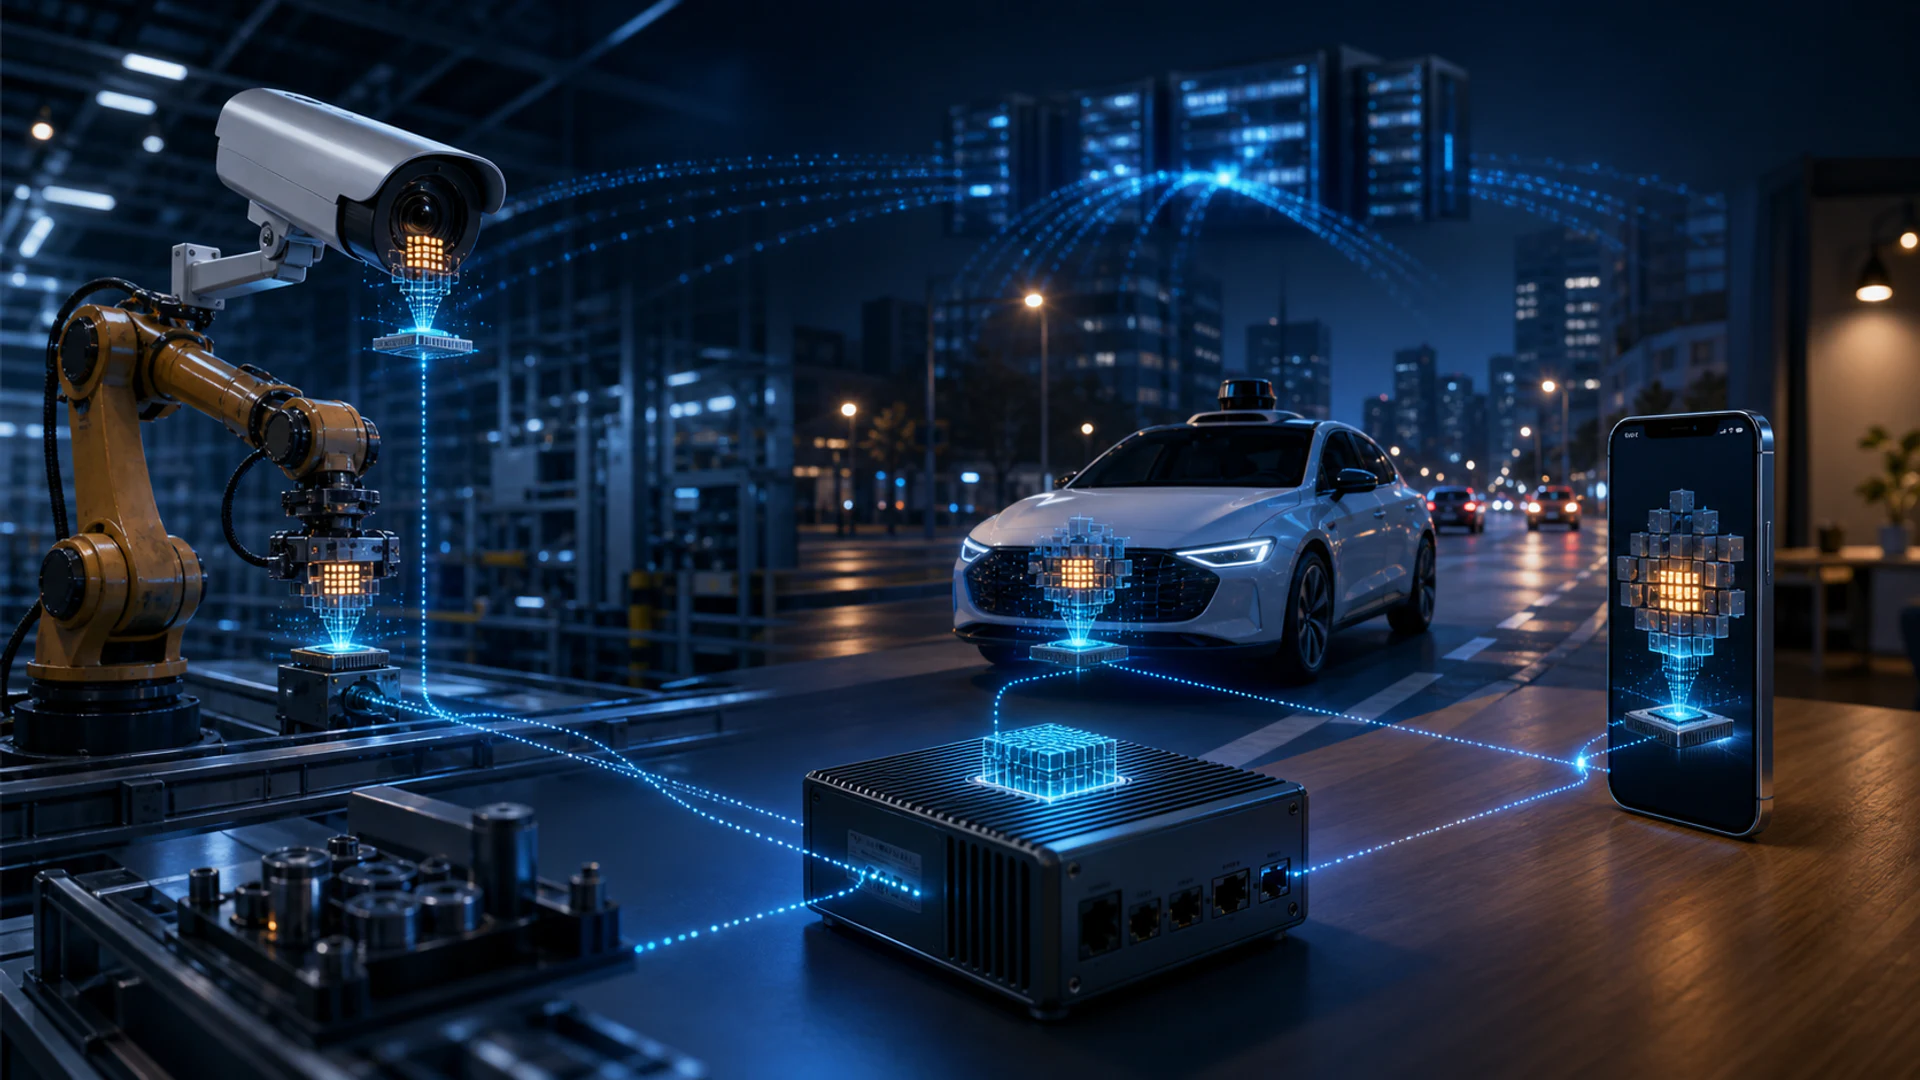
Edge computing posiziona l’elaborazione vicino ai dispositivi e ai processi fisici che generano i dati. Edge AI esegue l’inferenza di machine learning — e talvolta l’addestramento o l’adattamento — su un sensore, uno smartphone, un veicolo, un gateway o un server locale invece di inviare ogni input a un cloud distante.
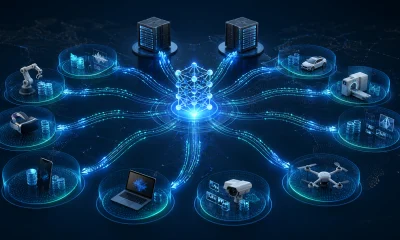
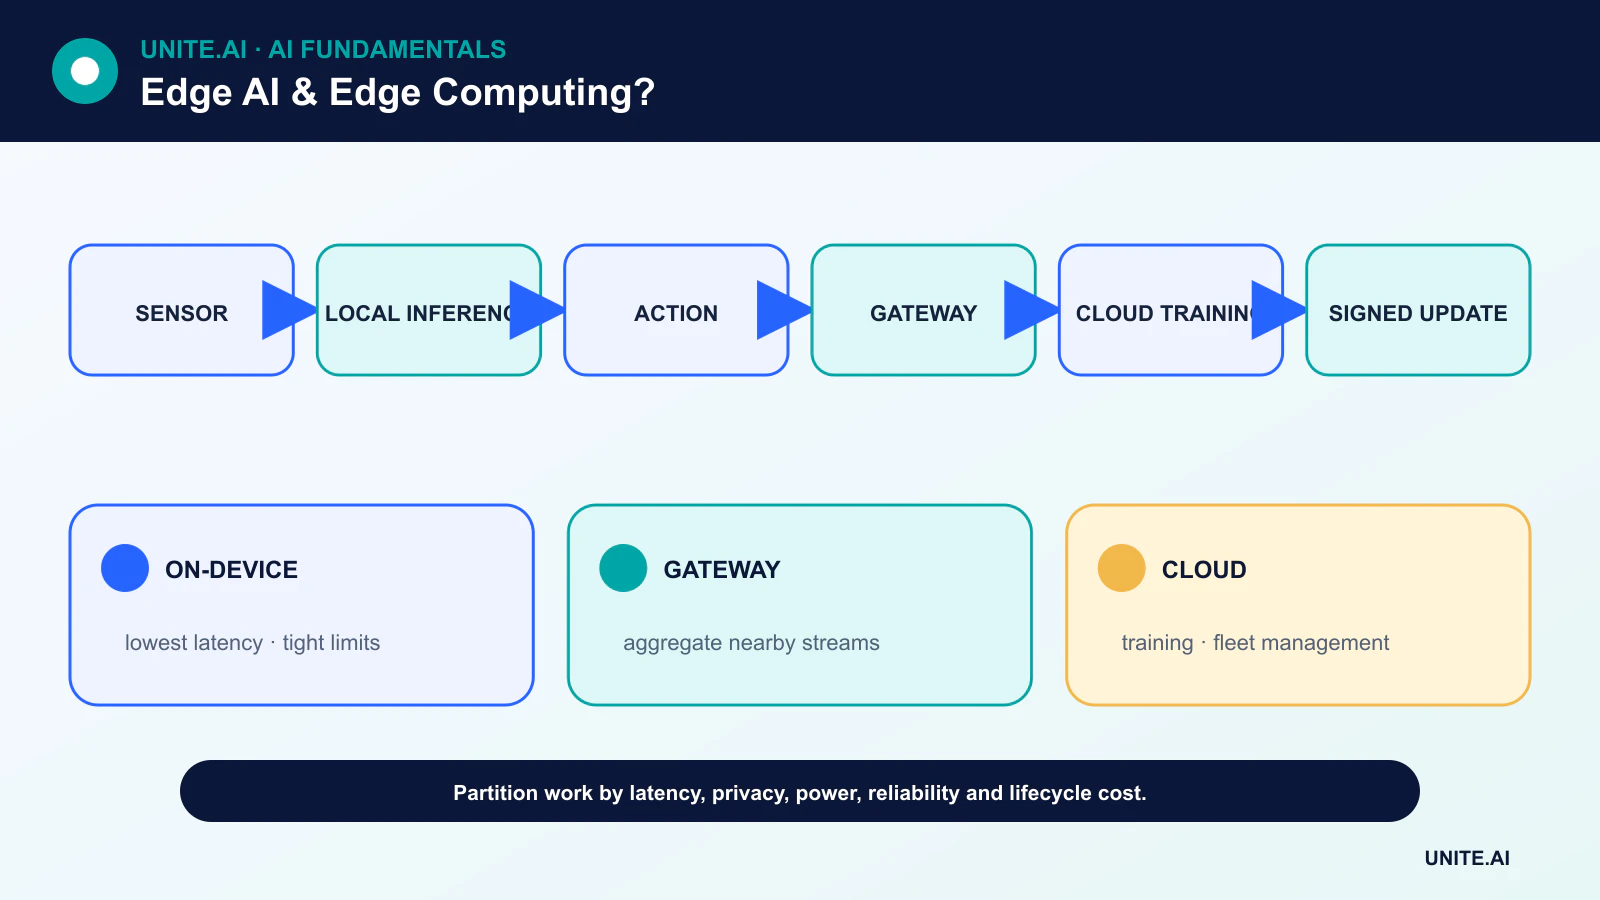
L’architettura è solitamente un continuum piuttosto che una scelta tra edge e cloud. Le decisioni immediate possono rimanere locali, mentre il cloud supporta la gestione della flotta, l’analisi aggregata, l’addestramento dei modelli e l’archiviazione a lungo termine.
Punti chiave
- L’Edge AI può ridurre la latenza, l’uso della larghezza di banda e il trasferimento di dati grezzi, ma non garantisce automaticamente la privacy.
- Memoria, potenza, limiti termici e il supporto degli acceleratori determinano il modello distribuibile.
- Quantizzazione, pruning e distillazione bilanciano dimensione e velocità del modello rispetto a accuratezza e robustezza.
- Aggiornamenti sicuri, telemetria, rollback e diversità hardware sono componenti fondamentali del sistema.
Il continuum edge‑cloud
Un sensore può eseguire un piccolo modello di soglia, un gateway vicino può combinare più flussi e un server regionale può effettuare inferenze più pesanti. Il cloud può addestrare i modelli e distribuire aggiornamenti firmati. La partizione dipende da latenza, connettività, energia, sensibilità dei dati e manutenzione.
Per il controllo industriale, i millisecondi e il funzionamento offline possono giustificare l’inferenza locale. Per una previsione aziendale a bassa frequenza, la computazione centralizzata può risultare più semplice e più osservabile.
Vincoli hardware e del modello
I dispositivi edge vanno dai microcontrollori con kilobyte di memoria a smartphone e server con NPU o GPU. Il modello deve adattarsi allo storage e alla RAM, rispettare le scadenze in tempo reale, rimanere entro i limiti termici e utilizzare operatori supportati.
Il benchmark dovrebbe includere il preprocessing, lo spostamento dei dati e il costo di attivazione — non solo il throughput del kernel. La dimensione del batch è spesso uno, e le prestazioni sostenute possono differire da un breve test di laboratorio.
Compressione e ottimizzazione
La quantizzazione rappresenta i pesi e le attivazioni con precisione inferiore. Il pruning rimuove parametri o strutture. La distillazione della conoscenza addestra uno studente più piccolo a imitare un insegnante più grande. La fusione di operatori e la pianificazione della memoria possono ulteriormente ridurre la latenza.
La compressione può modificare accuratezza, calibrazione e prestazioni di sottogruppi. I team dovrebbero convalidare l’artefatto convertito sull’hardware di destinazione invece di presumere che le metriche del modello originale a virgola mobile siano ancora valide.
Privacy, apprendimento federato e sicurezza
L’inferenza locale può mantenere audio grezzo, immagini o registrazioni dei sensori sul dispositivo, ma i metadati, gli embedding e la telemetria possono comunque essere sensibili. Federated learning può coordinare l’addestramento distribuito, con i propri rischi di privacy e avvelenamento.
Le flotte di edge ampliano la superficie di attacco. Secure boot, modelli firmati, servizi a minimo privilegio, comunicazione crittografata e aggiornamenti tempestivi fanno parte della progettazione di cybersecurity. È necessario considerare l’accesso fisico e i dispositivi non più supportati a lungo termine.
Monitoraggio e operazioni della flotta
Un modello locale ha comunque bisogno di osservabilità. I dispositivi possono segnalare metriche aggregate rispettose della privacy, versione, stato di salute, latenza e tassi di rifiuto. Campionare input selezionati per la revisione richiede consenso esplicito e controlli di conservazione.
I rollout dovrebbero utilizzare gruppi canary e rollback automatici. Il sistema deve gestire hardware incompatibile, aggiornamenti interrotti e drift del modello. Un dispositivo che non può ricevere correzioni di sicurezza potrebbe dover essere rimosso dal servizio.
Architettura edge e collocamento dei carichi di lavoro
L’edge computing elabora i dati vicino alla loro fonte — su un sensore, dispositivo, gateway, veicolo, punto vendita o server locale — invece di fare affidamento interamente su un cloud distante. L’Edge AI colloca l’inferenza del modello o talvolta l’addestramento in quell’ambiente. Il posizionamento dovrebbe seguire requisiti di latenza, connettività, larghezza di banda, privacy, resilienza, energia e gestione. Un design ibrido può eseguire il rilevamento immediato localmente, inviare eventi selezionati a un sistema regionale e utilizzare il cloud per l’analisi della flotta e l’addestramento dei modelli.
L’hardware varia dai microcontrollori e NPU a GPU e server robusti. I modelli vengono esportati, quantizzati, potati, distillati o compilati per gli operatori e la memoria disponibili. Il preprocessing e l’I/O dei sensori possono dominare la latenza, mentre il calore o i limiti della batteria influenzano il throughput sostenuto. Eseguire benchmark dell’intera pipeline sul dispositivo esatto sotto condizioni realistiche di concorrenza, temperatura e modalità di alimentazione. Una cifra TOPS di copertina non rivela fallback degli operatori, trasferimenti di memoria o accuratezza distribuita.
Sicurezza della flotta, aggiornamenti e osservabilità
I dispositivi distribuiti ampliano la superficie di attacco e possono essere fisicamente accessibili. Utilizzare secure boot, firmware e modelli firmati, identità basata sull’hardware dove possibile, comunicazione crittografata, minimo privilegio, segmentazione della rete e segreti protetti. Gli aggiornamenti richiedono rollout a fasi, controlli di compatibilità, politica anti-rollback dove appropriato, recupero da aggiornamenti interrotti e un’immagine nota buona. Inventariare versioni di dispositivi, sensori, firmware, runtime e modelli affinché un incidente possa essere delimitato rapidamente.
La connettività è intermittente, quindi è necessario bufferizzare i dati con storage limitato, sequenziare gli eventi, rendere i retry idempotenti e definire il comportamento offline. L’osservabilità dovrebbe catturare salute, latenza, energia, riepiloghi degli input, previsioni, confidenza e risultati confermati senza trasmettere dati grezzi non necessari. Deriva dell’orologio, guasti dei sensori e esaurimento dello storage locale possono invalidare i risultati. I comandi remoti e i canali di debug richiedono un’autorizzazione più forte poiché possono diventare percorsi di controllo a livello di flotta.
Distribuzione responsabile
L’elaborazione locale può ridurre il trasferimento ma non protegge automaticamente la privacy; gli input grezzi, gli embedding e i log possono comunque rimanere sul dispositivo o sincronizzarsi in seguito. Ridurre al minimo la conservazione e divulgare il fallback al cloud. Testare il drift del modello tra siti e condizioni ambientali, con un valore predefinito sicuro quando la confidenza o lo stato del sensore peggiorano. L’Edge AI è utile quando i vincoli locali sono reali, ma trasferisce la responsabilità del ciclo di vita, della sicurezza e della qualità a una grande flotta eterogenea che deve essere progettata e mantenuta come un unico sistema.
Esempio pratico: Edge AI per una telecamera di sicurezza remota
Un sito remoto rileva se un cancello di accesso limitato è aperto mentre le macchine funzionano. Il dispositivo edge elabora il video localmente per bassa latenza e trasmette solo eventi e miniature consentite. I dati includono condizioni meteo, illuminazione notturna, sporco, vibrazioni e scene vuote. Il modello è quantizzato e benchmarkato end‑to‑end sul dispositivo target per rilevamento, falsi allarmi, latenza, energia e comportamento termico sostenuto.
Secure boot, aggiornamenti firmati, identità del dispositivo e rete segmentata proteggono la flotta. Ostruzione della telecamera, esaurimento dello storage, deriva dell’orologio, perdita di rete e timeout del modello generano allarmi di salute e una regola di sicurezza dell’apparecchiatura indipendente dall’AI. Gli aggiornamenti vengono distribuiti a un piccolo gruppo con rollback automatico. Il monitoraggio raccoglie dati minimi sulla salute e sui risultati, e il personale del sito può ispezionare e sovrascrivere. L’inferenza locale riduce il trasferimento ma non elimina gli obblighi di privacy, conservazione o sicurezza fisica.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato di salute delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi rivedere le prove dal mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
L’Edge AI è sempre più veloce del Cloud AI?
No. L’inferenza locale evita il ritardo di rete ma può essere eseguita su hardware più debole. L’intera pipeline e i requisiti di affidabilità determinano la latenza.
L’Edge AI può funzionare senza accesso a Internet?
Sì, se il modello, il preprocessing e la logica decisionale sono locali. Aggiornamenti, sincronizzazione o funzionalità dipendenti dal cloud potrebbero non essere disponibili.
Riferimenti principali