Fondamenti di IA
Cos’è la riduzione della dimensionalità?

 Aggiungi Unite.AI alle tue fonti preferite su Google
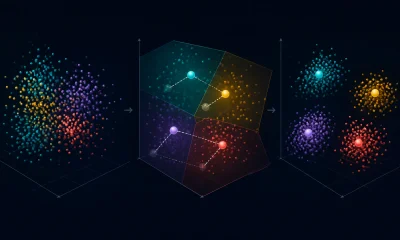
Riduzione della dimensionalità rappresenta i dati con meno variabili mantenendo le informazioni utili per un compito. Può ridurre lo spazio di archiviazione e il rumore, migliorare la visualizzazione, mitigare le caratteristiche ridondanti e rendere più semplice l’addestramento dei modelli a valle.
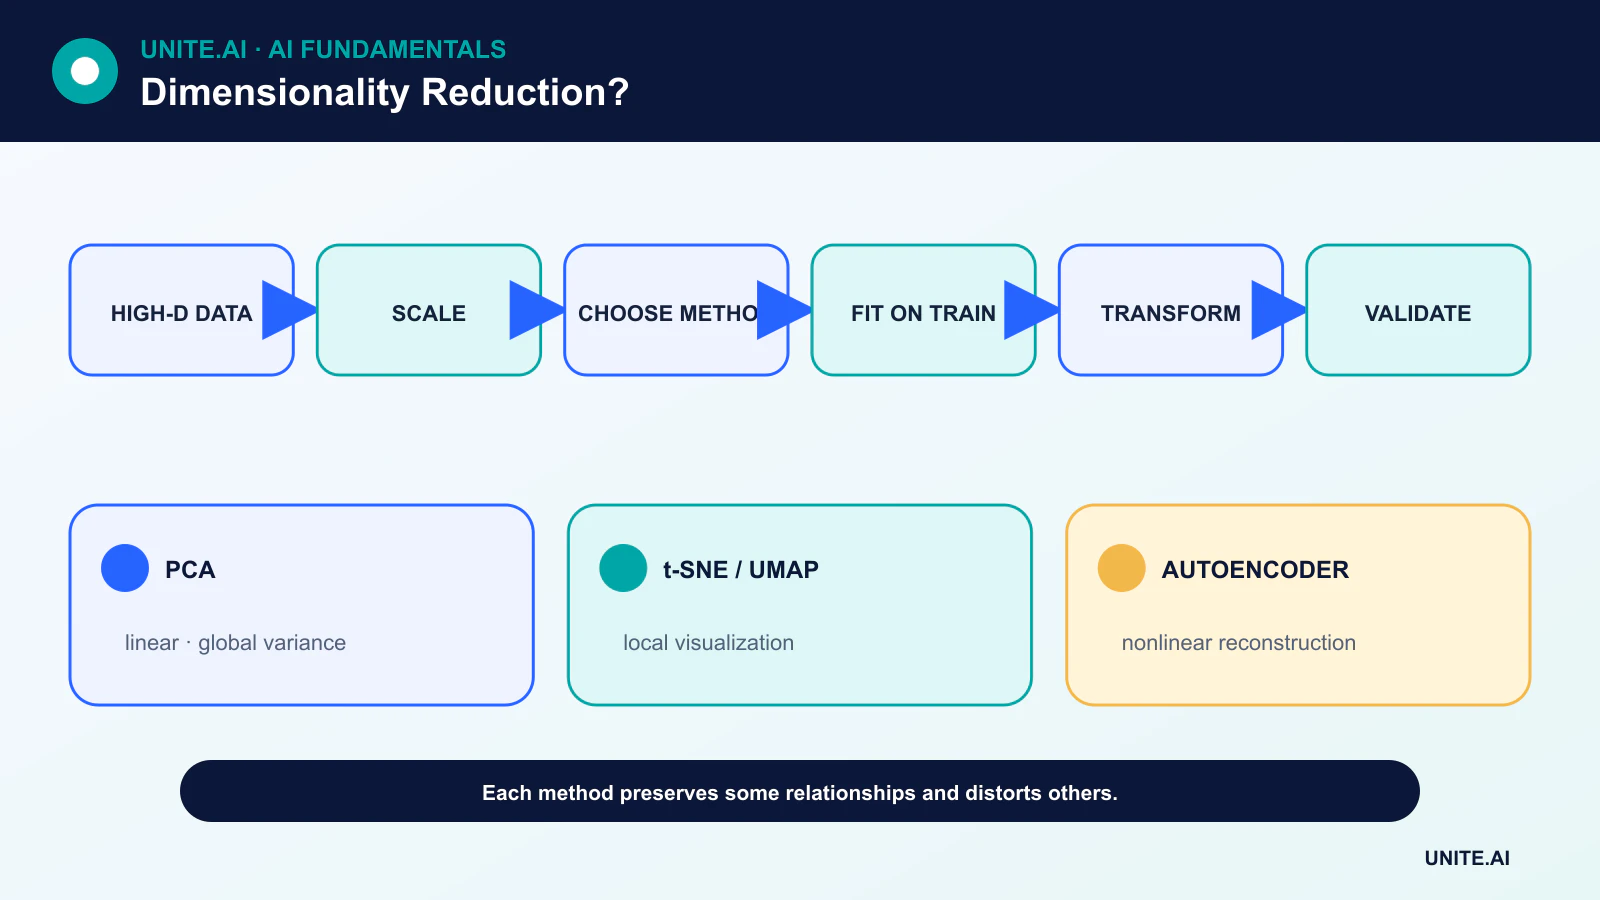
Nessun metodo preserva ogni relazione. Una riduzione utile inizia dichiarando cosa deve essere conservato: varianza, separazione delle classi, vicinato locale, geometria globale, qualità della ricostruzione o interpretabilità.
Punti chiave
- La selezione delle caratteristiche mantiene le variabili originali; l’estrazione delle caratteristiche crea nuove coordinate a dimensione inferiore.
- PCA è lineare e orientata alla varianza; t-SNE e UMAP enfatizzano la struttura di vicinato per la visualizzazione.
- Le rappresentazioni visualizzate possono distorcere le distanze, le dimensioni dei cluster e la separazione globale.
- Addestra la riduzione solo sui dati di training, poi applica la trasformazione appresa ai dati di validazione e test.
Selezione delle caratteristiche vs proiezione
La selezione delle caratteristiche rimuove le variabili usando regole di dominio, valori mancanti, ridondanza, test predittivi o regolarizzazione. Preserva i significati originali, il che può favorire la governance e la spiegazione.
I metodi di proiezione combinano le variabili in nuove coordinate. Possono catturare strutture distribuite ma possono rendere più difficile l’interpretazione di ciascuna coordinata. Un autoencoder apprende una proiezione non lineare tramite ricostruzione.
PCA e SVD
L’analisi delle componenti principali identifica direzioni ortogonali di varianza decrescente dopo aver centrato i dati. La decomposizione in valori singolari fornisce un percorso numerico comune. La scalatura è importante: un’unità di misura ad alta varianza può dominare le componenti.
PCA è deterministica a meno del segno e di valori propri ripetuti, supporta la trasformazione fuori campione e fornisce riepiloghi della varianza spiegata. Un’alta varianza non è sempre rilevante per il compito, e le componenti lineari non possono srotolare ogni varietà curva.
t-SNE e UMAP
t-SNE costruisce distribuzioni di probabilità sui vicini e ottimizza una mappa a bassa dimensione che enfatizza la somiglianza locale. UMAP costruisce un grafo di vicinato ponderato e ottimizza una rappresentazione a dimensione inferiore con obiettivi correlati alla struttura locale.
Entrambi sono potenti strumenti esplorativi ma sono sensibili alla pre‑elaborazione, alla metrica di distanza e agli iperparametri. Lo spazio vuoto, l’area del cluster e la distanza tra cluster in un grafico 2D non dovrebbero essere automaticamente interpretati come corrispondenti al mondo reale.
Metodi supervisionati e rappresentazioni consapevoli del compito
L’analisi discriminante lineare utilizza le etichette di classe per cercare la separazione, rendendola diversa dalla PCA non supervisionata. L’apprendimento di rappresentazioni neurali può ottimizzare obiettivi di previsione o contrastivi invece della ricostruzione.
Se le etichette guidano la riduzione, tutti i fitting e la messa a punto devono rimanere all’interno del processo di addestramento. Altrimenti, informazioni dal set di test possono trapelare nella selezione del modello e generare un risultato ottimistico.
Scelta e validazione di un metodo
Inizia con la pre‑elaborazione e una baseline semplice. Per la compressione, misura la ricostruzione o le prestazioni a valle attraverso le dimensioni. Per la visualizzazione, testa la stabilità su diversi seed e iperparametri e confronta la preservazione del vicinato con la conoscenza di dominio.
Per la produzione, chiediti se il metodo può trasformare nuovi record, come gestisce i valori mancanti, se cambia con il ri‑addestramento e se gli utenti hanno bisogno di spiegazioni delle caratteristiche originali. L’overfitting può verificarsi nella fase di riduzione così come nel modello finale.
Metodi di riduzione lineari e non lineari
La riduzione della dimensionalità mappa dati ad alta dimensione in coordinate più ridotte preservando la struttura selezionata. L’analisi delle componenti principali trova direzioni ortogonali di massima varianza dopo il centramento; la scalatura è necessaria quando le unità devono contribuire in modo comparabile. La decomposizione in valori singolari calcola strutture a basso rango correlate e supporta matrici sparse. L’analisi discriminante lineare utilizza le etichette per trovare direzioni che separano le classi. Questi metodi forniscono trasformazioni esplicite, ma la varianza o la separazione delle classi potrebbero non conservare le informazioni richieste per un compito a valle.
I metodi di varietà come t‑SNE e UMAP costruiscono vicinati e ottimizzano una disposizione a bassa dimensione. Sono potenti per l’esplorazione ma distorcono la distanza globale, la densità, la dimensione dei cluster e talvolta la separazione. I risultati dipendono dalla pre‑elaborazione, dalla metrica, dal numero di vicini o dalla perplessità, dall’inizializzazione e dal seed. Un cluster attraente in due dimensioni può emergere anche in assenza di gruppi discreti. Usa impostazioni multiple, colora solo in base a metadati non usati nel fitting e valida la struttura apparente nello spazio originale o con etichette indipendenti.
Selezione delle caratteristiche, embedding e valutazione
La selezione delle caratteristiche mantiene le variabili originali tramite filtri, wrapper o importanza basata su modello; l’apprendimento di rappresentazioni crea nuove caratteristiche latenti usando autoencoder o modelli supervisionati. Le proiezioni casuali preservano le distanze approssimativamente sotto certe condizioni e offrono baseline efficienti. Scegli il metodo in base a compressione, visualizzazione, riduzione del rumore, velocità, spazio di archiviazione o prestazioni del modello. Addestra il riduttore solo sui dati di training, poi trasforma i set di validazione e test. La riduzione supervisionata deve essere nidificata all’interno della cross‑validation per evitare perdite di etichette.
Valuta la varianza spiegata o la ricostruzione per la compressione lineare, l’affidabilità e la preservazione del vicinato per la visualizzazione, e l’accuratezza, la calibrazione, la latenza e la robustezza a valle per la previsione. Misura la stabilità su campioni e seed. Verifica se classi rare o gruppi sensibili sono compressi e se è possibile una mappatura inversa. Le coordinate ridotte possono ancora contenere informazioni private; un grafico bidimensionale non è anonimizzazione. Documenta la trasformazione, lo scaler, l’ordine delle caratteristiche e le limitazioni.
Uso in produzione
Il servizio richiede la trasformazione esatta addestrata e lo schema di input. Monitora le caratteristiche mancanti, lo spostamento di range, la distribuzione dei punteggi delle componenti, l’errore di ricostruzione e i risultati a valle. Se compaiono nuove categorie o sensori, ri‑addestra e versiona l’intera pipeline invece di aggiungere colonne silenziosamente. La riduzione può migliorare il calcolo e ridurre il rumore di un modello, ma può anche scartare segnali deboli importanti per eventi rari. Trattala come una fase di misurazione appresa la cui informazione trattenuta e persa deve essere verificata rispetto alla decisione.
Esempio pratico: riduzione delle caratteristiche del comportamento cliente
Un analista standardizza 200 misure comportamentali e addestra la PCA solo sui clienti di training. La cross‑validation sceglie il numero di componenti in base alle prestazioni di churn a valle e alla stabilità, non a uno scatterplot bidimensionale. I loading vengono esaminati per fonti dominate e valori mancanti. PCA, selezione delle caratteristiche, proiezione casuale e un modello regolarizzato non ridotto vengono confrontati su calibrazione, latenza e risultati per segmenti di clienti rari. Campioni ripetuti testano anche se le componenti principali e le conclusioni a valle rimangono stabili.
La pipeline distribuita fissa l’ordine delle caratteristiche, lo scaler e le componenti e rifiuta versioni di schema mancanti. Il monitoraggio traccia le distribuzioni delle componenti, l’errore di ricostruzione e i risultati a valle. Una visualizzazione con cluster apparenti è usata per generare domande, non per assegnare personas ai clienti. Poiché le componenti latenti continuano a codificare il comportamento, l’accesso e la ritenzione rimangono controllati. Se le definizioni di origine cambiano, la trasformazione completa e il modello vengono ricostruiti e validati invece di proiettare dati incompatibili nelle vecchie componenti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni errore importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allerta e un responsabile della risposta, poi esamina le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
La riduzione della dimensionalità migliora sempre un modello?
No. Può scartare informazioni predittive o complicare l’interpretazione. Confronta con una baseline senza riduzione su dati di test.
I cluster separati di t‑SNE dimostrano l’esistenza di classi reali?
No. La mappa è una visualizzazione ottimizzata delle relazioni di vicinato e può creare una separazione apparente. Convalida i cluster con evidenze indipendenti.
Riferimenti principali