Fondamenti di IA
Cosa sono i modelli di linguaggio di grandi dimensioni (LLM)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Un modello di linguaggio di grandi dimensioni (LLM) è una rete neurale addestrata su grandi collezioni di sequenze per prevedere token o obiettivi linguistici correlati. La maggior parte degli LLM attuali utilizza architetture transformer e può generare, classificare, riassumere, tradurre, recuperare e trasformare il linguaggio attraverso un’interfaccia comune.
Un LLM non è un database né un ragionatore garantito. Il suo output è una previsione condizionale modellata dai dati di addestramento, dal post‑training, dal contesto, dagli strumenti e dal decoding. La fluidità può coesistere con errori fattuali, incertezza, bias o comportamenti non sicuri.
Punti chiave
- La tokenizzazione converte il testo in unità discrete; gli embedding e l’attenzione costruiscono rappresentazioni contestuali.
- Il pre‑training apprende pattern generali, mentre il fine‑tuning e i metodi basati sulle preferenze modellano il comportamento per compito.
- Il recupero e gli strumenti possono aggiungere evidenze o azioni attuali, ma richiedono permessi e validazioni separati.
- Valutare il sistema distribuito per qualità, solidità, sicurezza, latenza, costo e deriva.
Token, transformer e pre‑training
Il testo viene suddiviso in token. Un transformer li mappa in vettori, mescola le informazioni tramite l’attenzione e gli strati feed‑forward, e produce una distribuzione di probabilità sul token successivo o mancante.
Gli obiettivi auto‑supervisionati generano segnali di addestramento a partire da sequenze grezze. La scala in termini di parametri, dati e potenza di calcolo può migliorare la loss in modo prevedibile su diversi intervalli, ma la qualità del dataset, l’architettura, l’ottimizzazione e la valutazione determinano quali capacità emergono nella pratica.
Post‑training e inferenza
Il tuning delle istruzioni utilizza dimostrazioni; l’ottimizzazione delle preferenze può far corrispondere meglio gli output ai giudizi umani o a una policy. In fase di inferenza, un prompt e la cronologia della conversazione definiscono il contesto, mentre la temperatura e le impostazioni di campionamento influenzano la variabilità.
RLHF e metodi simili modellano il comportamento anziché installare un verificatore di fatti completo. Il modello può comunque generare una risposta plausibile ma non supportata.
Recupero, strumenti e agenti
La generazione aumentata dal recupero fornisce passaggi selezionati da una collezione esterna. La chiamata a strumenti consente al codice applicativo di interrogare database, calcolare, cercare o agire. Questi schemi separano parte della conoscenza e dell’esecuzione dai pesi del modello.
L’applicazione deve convalidare gli argomenti degli strumenti, far rispettare i permessi, preservare le citazioni e trattare il contenuto recuperato come input non attendibile. La ricerca di similarità vettoriale aiuta il recupero ma non dimostra che un passaggio supporti la risposta.
Limitazioni e valutazione
Gli LLM possono allucinare, esporre contenuti memorizzati, seguire istruzioni dannose, riprodurre bias e fallire su compiti che sembrano simili a esempi di addestramento. Un contesto lungo non garantisce che ogni fatto sia utilizzato o riconciliato correttamente.
Valutare su compiti privati rappresentativi con prompt e versioni documentati. Misurare il supporto tramite fonti, rifiuti, calibrazione, sicurezza, risultati per sottogruppi, carico di lavoro umano, latenza e costo. Monitorare dopo il rilascio poiché modelli, dati e comportamento degli utenti cambiano.
Dati di addestramento e sviluppo del modello
I corpora di pre‑training combinano pagine web, libri, codice, materiale accademico, conversazioni e fonti licenziate o curate. Le pipeline rilevano la lingua, rimuovono i duplicati, filtrano contenuti di qualità e non sicuri, gestiscono dati personali e scelgono i pesi di miscelazione. queste scelte modellano la conoscenza, la copertura linguistica, lo stile, il bias e la memorizzazione.
I processi di ottimizzazione gestiscono batch di sequenze di token e minimizzano la loss di previsione con discesa del gradiente. L’addestramento distribuito suddivide dati, tensori del modello, fasi della pipeline o esperti su più acceleratori. Il checkpointing, la stabilità numerica, la comunicazione di rete e il recupero da guasti diventano importanti sfide ingegneristiche su larga scala.
La valutazione durante l’addestramento traccia la loss e le suite di capacità, ma la contaminazione dei benchmark può gonfiare i risultati. È necessario tenere separati periodi temporali e compiti proprietari, cercare sovrapposizioni e riportare prompt, decoding, strumenti e metriche esatti. Un modello può migliorare la loss media mentre regressioni compaiono in termini di sicurezza o in una lingua a risorse limitate.
Finestre di contesto, decoding e inferenza
In fase di inferenza, la cache chiave‑valore memorizza le proiezioni di attenzione per i token precedenti così da non doverle ricalcolare ad ogni passo. La memoria della cache cresce con i layer, la sequenza, il batch e la rappresentazione. La quantizzazione e il paging riducono la pressione ma possono alterare qualità o latenza.
Il decoding greedy seleziona il token a più alta probabilità; la temperatura riscalibra le probabilità; top‑k e top‑p limitano l’insieme dei candidati; la ricerca a fascio (beam search) traccia più sequenze. La strategia migliore dipende dal valore che il compito attribuisce a determinismo, diversità, output strutturato o probabilità della sequenza. Convalidare sempre lo schema dopo la generazione.
Un contesto lungo aumenta la quantità di informazioni disponibili, ma non garantisce richiamo o ragionamento. Posizione, distrattori, contraddizioni e struttura del prompt influenzano l’uso. Il recupero può selezionare un insieme di evidenze più piccolo, mentre la sintesi comprime la cronologia a rischio di perdere dettagli. Misurare le prestazioni in base alla lunghezza e alla posizione del contesto.
Adattamento, distribuzione ed economia
Il fine‑tuning completo aggiorna tutti i parametri; i metodi a efficienza parametrica aggiornano adapter o matrici a basso rango; il pre‑training continuato adatta la distribuzione di dominio; il tuning di istruzioni e preferenze modella le risposte. Il recupero è spesso migliore per fatti che cambiano frequentemente, mentre il tuning è migliore per comportamento e formato del compito. I metodi possono essere combinati.
Le scelte di distribuzione includono API ospitate, endpoint gestiti, pesi open self‑hosted, modelli on‑device e soluzioni ibride. Confrontare gestione dei dati, controllo delle versioni, latenza, throughput, regioni, disponibilità, portabilità del modello, supporto e costo totale. L’auto‑hosting trasferisce la responsabilità della sicurezza, scalabilità, aggiornamenti e monitoraggio degli abusi.
Il costo per token è incompleto. Un modello debole può richiedere ritentativi, prompt più lunghi, più revisioni o errori costosi. Misurare il costo per compito completato con successo a un livello di qualità e rischio richiesto. Utilizzare caching, batching, modelli più piccoli instradati e codice deterministico dove migliorano il flusso di lavoro completo.
Esempio pratico: ancorare un LLM a documenti aziendali
Un assistente documentale dovrebbe partire da un corpus consapevole dei permessi, identificatori di documento stabili, versioni e date di efficacia, struttura analizzabile e un set di valutazione di domande rispondibili, non rispondibili, ambigue e conflittuali. Gli indici di recupero segmentano in chunk e metadati, ma la dimensione e la sovrapposizione dei chunk devono corrispondere alla struttura del documento. La qualità della ricerca viene misurata indipendentemente prima della generazione, così un modello fluente non può nascondere evidenze mancanti.
Durante l’esecuzione, autenticare l’utente, filtrare il recupero per accesso, recuperare e ri‑ordinare le evidenze, costruire un prompt limitato, generare una risposta citata e convalidare l’output richiesto. Il modello dovrebbe indicare quando le fonti sono in conflitto o non supportano una risposta. L’uso di strumenti e azioni esterne richiede autorizzazioni separate. Proteggere dalle istruzioni incorporate nei documenti recuperati trattando il contenuto come dati anziché come policy di sistema di priorità superiore.
Valutare il richiamo del recupero, la precisione delle citazioni, la correttezza delle risposte, la solidità, i rifiuti, la latenza e il costo across ruoli e tipologie di documento. Tracciare versioni di modello, prompt, indice, parser e corpus per ogni test. In produzione, registrare gli ID delle evidenze e il feedback senza esporre testo privato, monitorare nuove domande non rispondibili dopo modifiche ai contenuti e mantenere un fallback sicuro. Un’interfaccia LLM non sostituisce la gestione dei record, il controllo degli accessi o la revisione responsabile da parte di esperti.
La pianificazione della capacità dovrebbe modellare le distribuzioni di lunghezza di prompt e output, gli utenti concorrenti, il comportamento della cache, la latenza degli strumenti e i tassi di ritentativo. Lo streaming migliora la latenza percepita ma complica moderazione e cancellazione perché contenuti non sicuri o errati possono raggiungere l’utente prima che la risposta completa sia verificata. Definire budget di token e strumenti, isolare i tenant, proteggere le credenziali del provider e provare il failover tra versioni di modello senza modificare silenziosamente il comportamento su cui gli utenti fanno affidamento.
Checklist di implementazione pratica
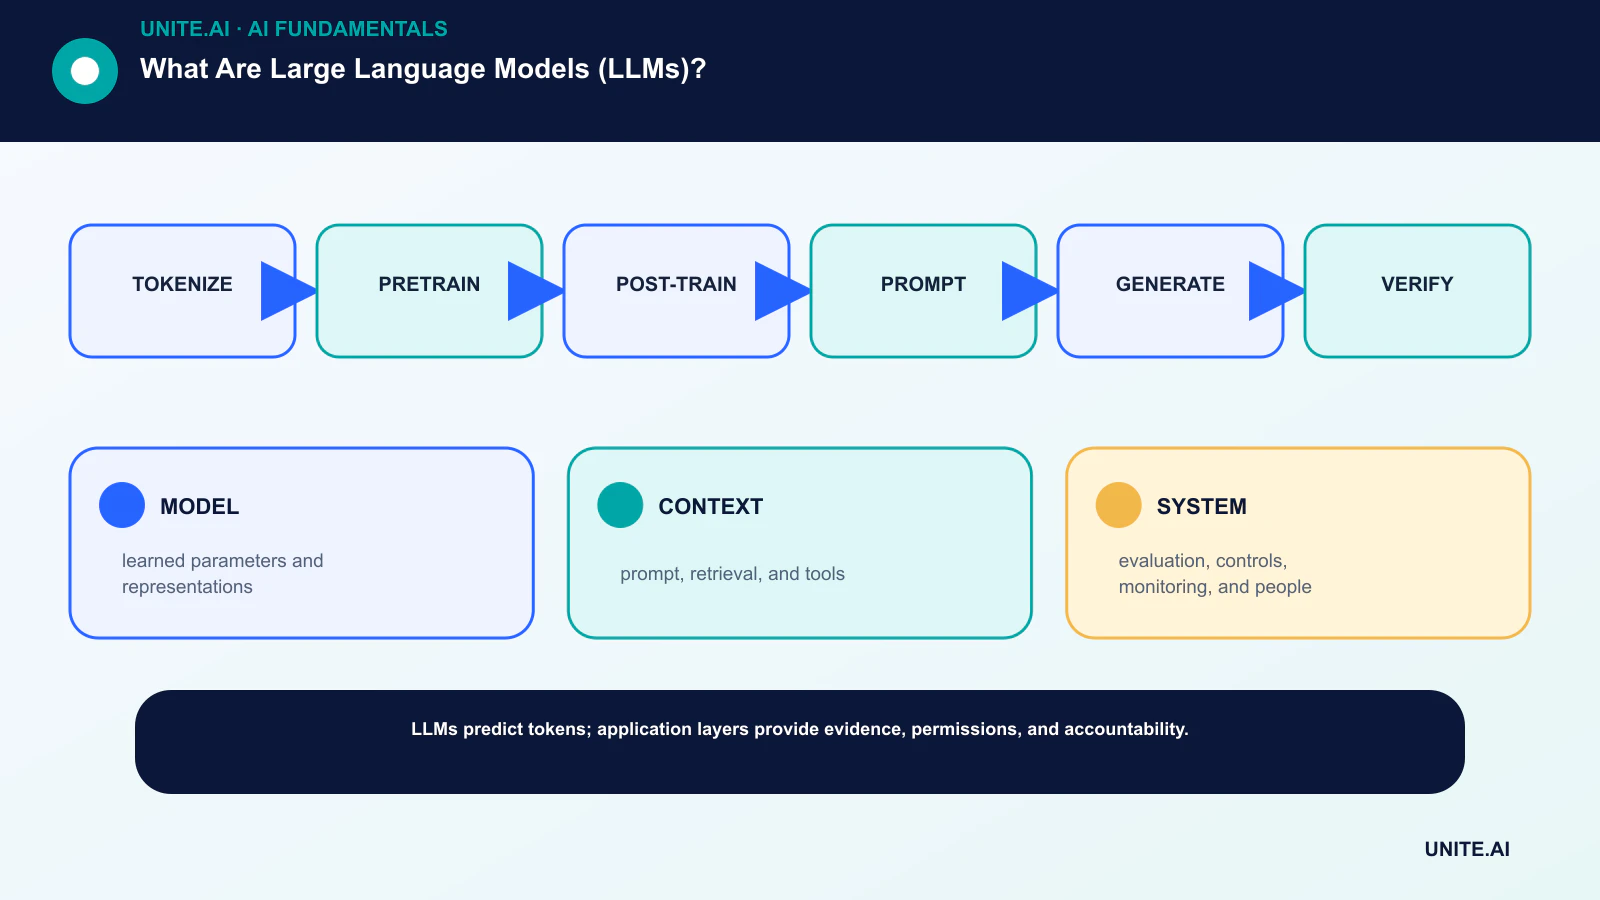
Trasforma il concetto in un flusso di lavoro limitato e testabile: tokenizzare → pre‑training → post‑training → prompt → generare → verificare. Assegna un responsabile responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e interruzione, testa fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare la portata. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, assicurano e sono interessate dal sistema. Testa casi normali, condizioni al limite, guasti di dipendenze e usi impropri; conserva le evidenze e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione dopo l’arrivo di dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- MODEL: parametri appresi e rappresentazioni.
- CONTEXT: prompt, recupero e strumenti.
- SYSTEM: valutazione, controlli, monitoraggio e persone.
Domande frequenti
Perché gli LLM sono definiti “grandi”?
Non esiste una soglia universale di parametri. “Grande” si riferisce alla scala rispetto ai precedenti modelli di linguaggio, includendo parametri, dati di addestramento, potenza di calcolo e ampiezza di utilizzo.
Gli LLM comprendono il linguaggio?
Costruiscono rappresentazioni interne utili e mostrano comportamenti complessi, ma il termine “comprendere” ha diversi significati. Le prestazioni dovrebbero essere dimostrate compito per compito anziché inferite dalla fluidità.
Riferimenti principali