Fondamenti di IA
Cos’è l’apprendimento per rinforzo profondo?

 Aggiungi Unite.AI alle tue fonti preferite su Google
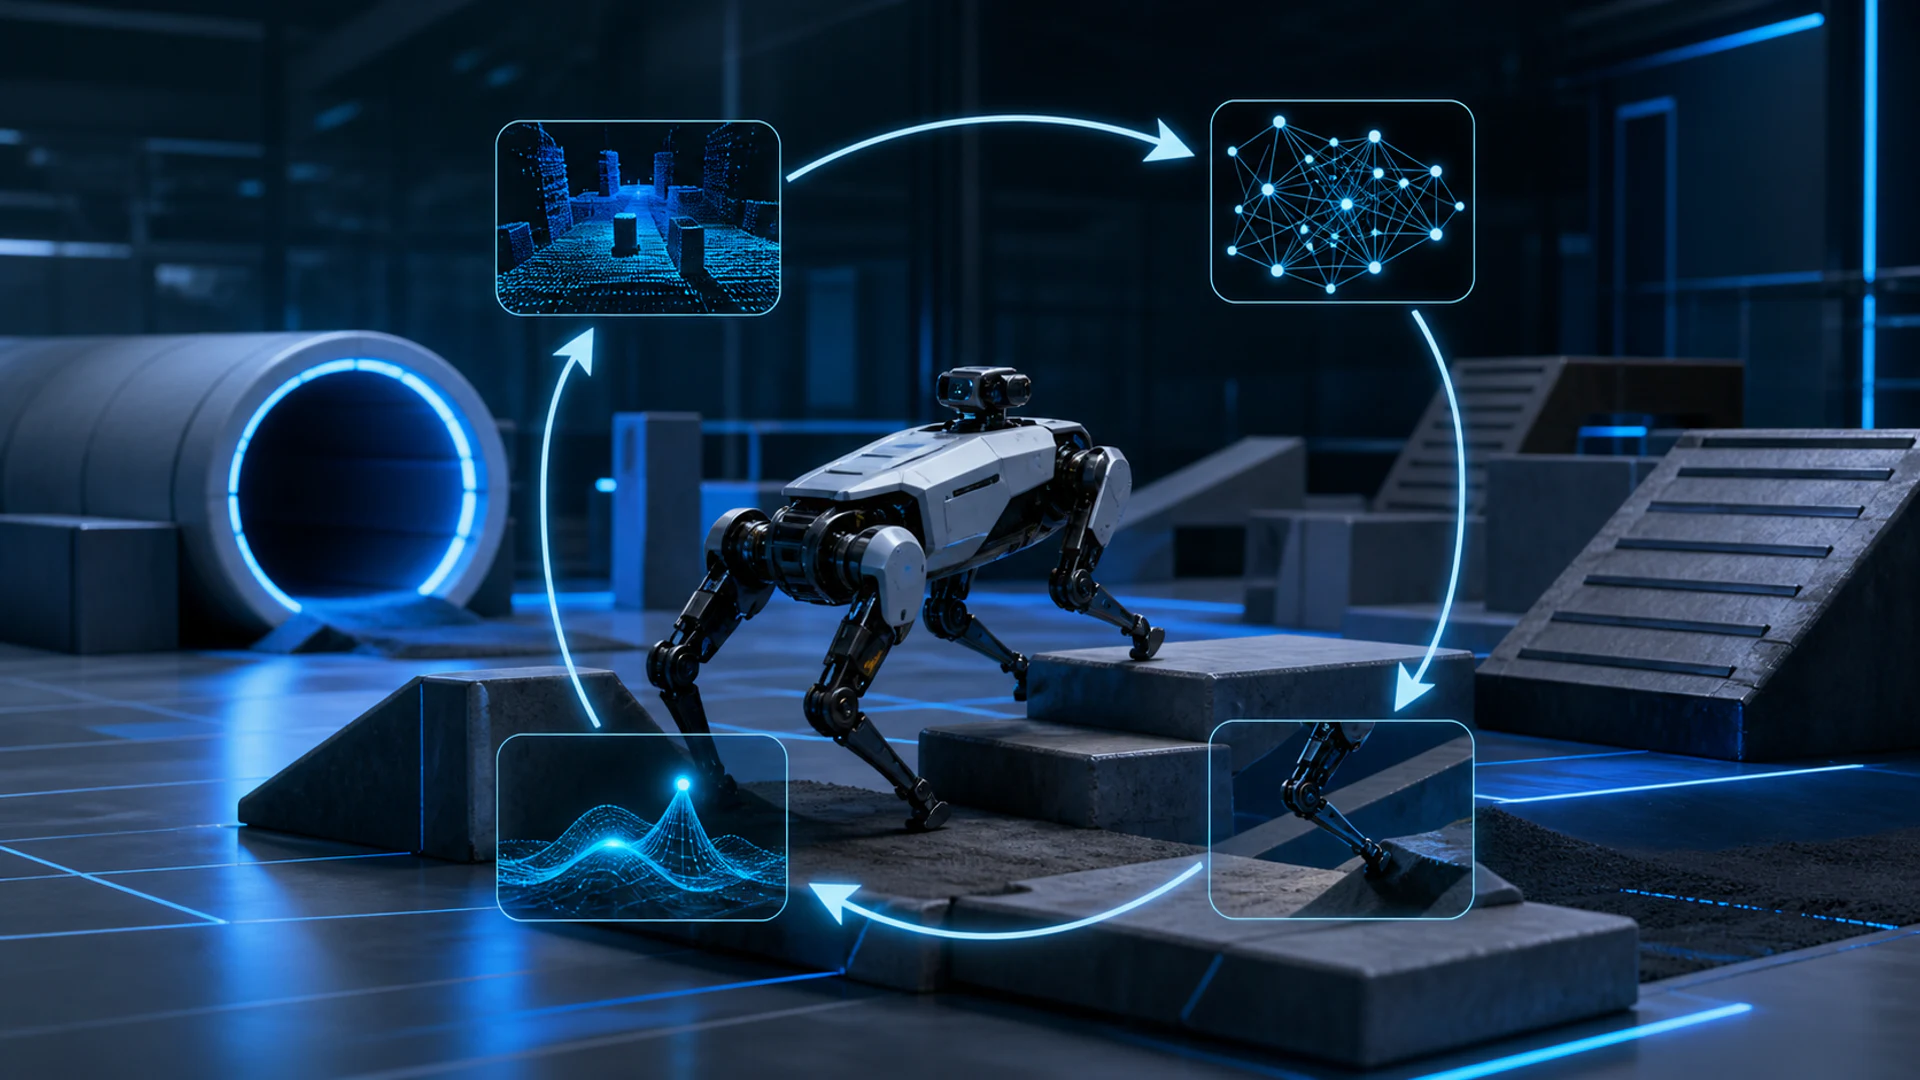
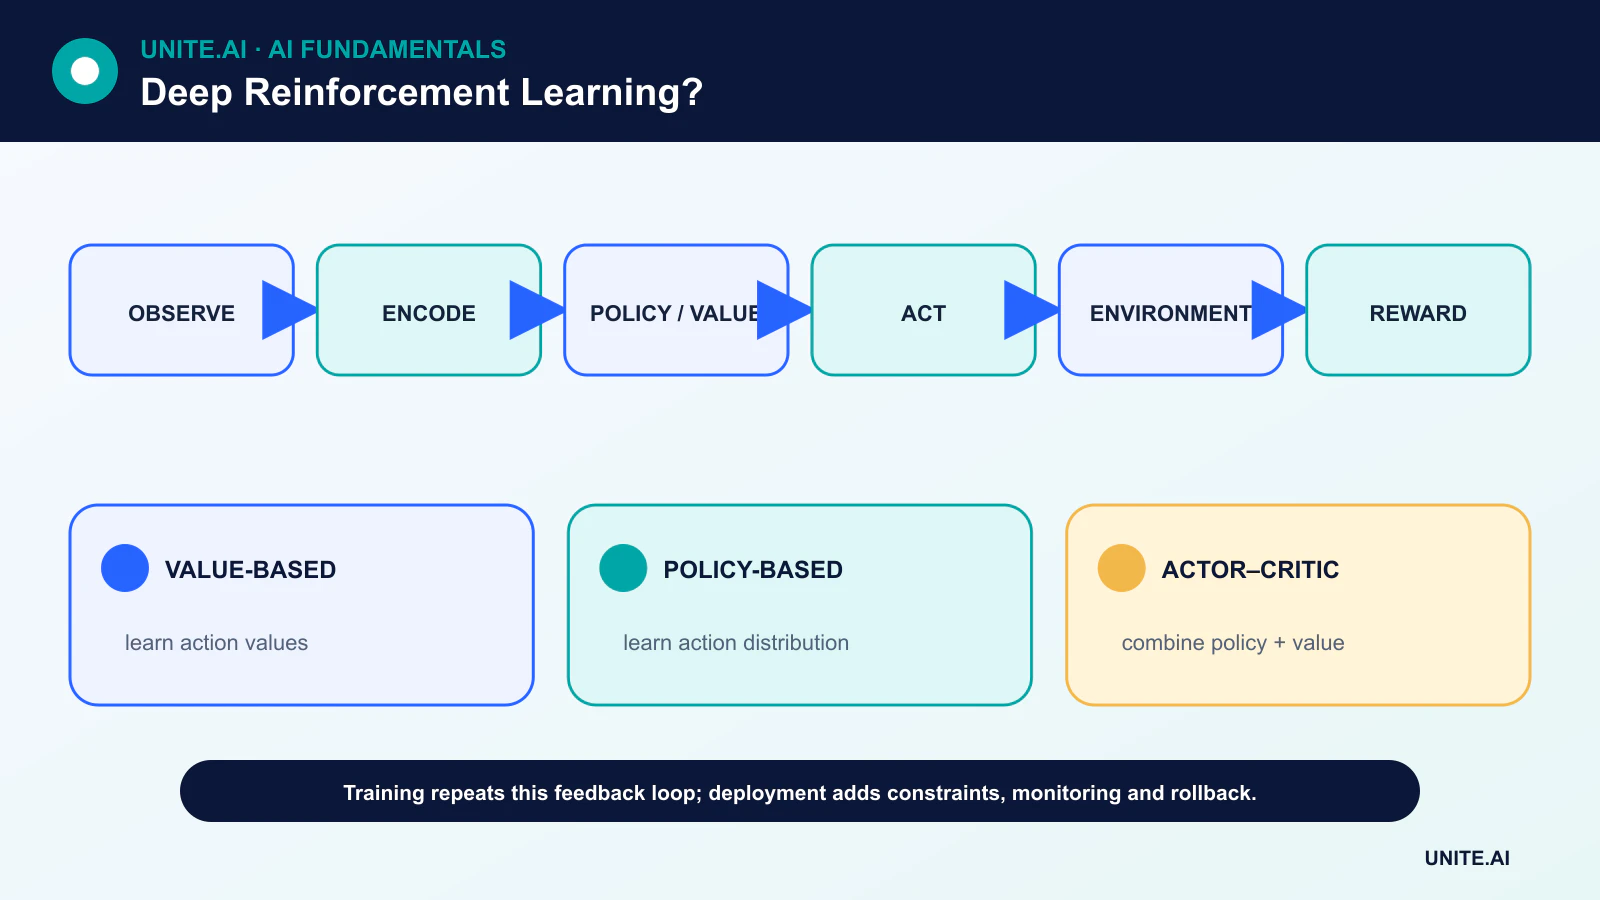
Deep reinforcement learning (deep RL) combina l’apprendimento per rinforzo con reti neurali profonde. Un agente osserva uno stato, sceglie un’azione, riceve una ricompensa e una nuova osservazione, quindi aggiusta una politica o una funzione di valore per migliorare le decisioni future.
La rete profonda non elimina le parti difficili dell’apprendimento per rinforzo. Fornisce un modo flessibile per rappresentare immagini, flussi di sensori, spazi di azioni ampi o funzioni di valore complesse. L’esplorazione, il credito ritardato, l’addestramento instabile e la valutazione sicura nel mondo reale rimangono problemi ingegneristici fondamentali.
Punti chiave
- Il Deep RL apprende decisioni sequenziali dall’interazione anziché da una tabella fissa di esempi etichettati.
- I metodi basati sul valore stimano quanto siano buone le azioni; i metodi di politica apprendono direttamente la distribuzione delle azioni; i metodi attore‑critico combinano entrambi.
- Buffer di replay, reti target e una progettazione attenta delle ricompense possono migliorare l’addestramento, ma nessuno garantisce un comportamento affidabile.
- Un punteggio elevato in simulatore non è prova di robustezza, sicurezza o di un trasferimento riuscito nel mondo fisico.
Il problema decisionale: stati, azioni e ricompense
Molti compiti di deep RL sono modellati come un processo decisionale di Markov. Al tempo t, l’agente riceve lo stato o l’osservazione s_t, seleziona l’azione a_t, quindi riceve la ricompensa r_{t+1} e lo stato successivo. L’obiettivo è il ritorno scontato atteso, non necessariamente la ricompensa immediata.
Il fattore di sconto controlla quanto importanza abbiano le ricompense lontane. Una funzione di ricompensa definisce ciò che il processo di ottimizzazione cercherà di massimizzare, quindi un proxy incompleto può produrre comportamenti tecnicamente riusciti ma operativamente indesiderabili. Questo è uno dei motivi per cui la progettazione delle ricompense e il test dei vincoli meritano la stessa attenzione dell’architettura del modello.
Metodi basati sul valore, basati sulla politica e attore‑critico
Un algoritmo basato sul valore stima il valore di uno stato o di un’azione. Le Deep Q‑network utilizzano una rete neurale per approssimare i valori Q e tipicamente scelgono l’azione con la stima più alta mantenendo una certa esplorazione. Un algoritmo di policy‑gradient, invece, ottimizza una politica parametrizzata che genera una distribuzione di azioni.
I sistemi attore‑critico mantengono sia un attore, che propone azioni, sia un critico, che ne stima il valore. Questo design supporta il controllo continuo ma introduce fonti interagenti di errore di stima. Il Deep RL dipende quindi dalle stesse fondamenta del deep learning, del gradient descent e del backpropagation.
Perché i buffer di replay e le reti target aiutano
I campioni di esperienza successivi sono correlati, mentre un aggiornamento della rete modifica i target usati dagli aggiornamenti successivi. Il replay di esperienza rompe parte di questa correlazione temporale campionando transizioni più vecchie. Una rete target si evolve più lentamente della rete online, rendendo i target bootstrap meno volatili.
Questi meccanismi migliorano la stabilità dell’addestramento, ma la sintonizzazione resta importante. Il tasso di apprendimento, il programma di esplorazione, la scala delle ricompense, la composizione del replay e la capacità della rete possono tutti influenzare il risultato. È consigliabile riportare più semi casuali perché un singolo run può essere fuorviante.
RL offline, RL basato su modello e sim‑to‑real
Il RL offline apprende da un dataset registrato fisso senza raccogliere nuove interazioni. Può essere utile quando l’esplorazione è costosa o pericolosa, ma la politica deve evitare azioni poco rappresentate nel log. Il RL basato su modello apprende o utilizza un modello di transizione per pianificare, scambiando assunzioni aggiuntive per una maggiore efficienza campionaria.
La robotica spesso si allena in simulazione, randomizza i parametri fisici, poi affina o valida sull’hardware. Il divario di realtà può comunque rivelare errori nella percezione, nel timing, nella dinamica dei contatti e in casi limite non modellati. Un sistema di reinforcement learning dovrebbe essere valutato sotto perturbazioni, spostamenti di distribuzione e vincoli di sicurezza espliciti.
Valutazione e deployment
Una valutazione utile separa gli ambienti di addestramento e di test, riporta le distribuzioni di ritorno anziché solo il punteggio migliore, e verifica violazioni di vincoli, frequenza di interventi e comportamento nel caso peggiore. Per i sistemi reali, i team hanno inoltre bisogno di monitoraggio, procedure di rollback, spazi di azione limitati e di un override umano.
Il Deep RL è più convincente quando le decisioni sono sequenziali, il feedback è disponibile e le regole di controllo scritte a mano sono insufficienti. È una scelta poco adeguata quando le etichette supervisionate sono abbondanti, un ottimizzatore convenzionale risolve il problema, o l’esplorazione metterebbe a rischio persone o beni.
Architetture Deep RL e segnali di addestramento
Il deep reinforcement learning utilizza reti neurali per rappresentare una funzione di valore, una politica, un modello dell’ambiente o una combinazione di questi. Una deep Q‑network prevede i valori delle azioni e apprende da target di differenza temporale; il replay di esperienza riduce la correlazione tra aggiornamenti, mentre una rete target stabilizza l’obiettivo in evoluzione. I metodi policy‑gradient ottimizzano direttamente il ritorno atteso, e i metodi attore‑critico usano un critico appreso per ridurre la varianza del gradiente. Le azioni continue spesso richiedono varianti deterministiche o stocastiche dell’attore‑critico, mentre le azioni discrete ad alta dimensionalità necessitano di un’esplorazione attenta e di una progettazione dell’output.
L’addestramento è non stazionario perché la politica modifica i dati che raccoglie. I dati di replay diventano off‑policy, i target bootstrap dipendono dalle stime correnti e l’approssimazione funzionale può amplificare gli errori—una combinazione talvolta chiamata la triade mortale. I doppi stimatori riducono la sovrastima del valore; le funzioni di vantaggio migliorano l’assegnazione del credito; i bonus di entropia incoraggiano l’esplorazione; gli obiettivi clip limitano aggiornamenti distruttivi della politica. Normalizzare osservazioni e ricompense solo con stati a perdita sicura, e registrare ambiente, wrapper, ripetizione dell’azione, terminazione e pre‑elaborazione delle ricompense perché ognuno modifica il problema.
Valutazione, simulatori e sicurezza del deployment
Riportare le distribuzioni di ritorno su semi indipendenti e istanze dell’ambiente, non il miglior run. Valutare l’efficienza campionaria, le violazioni di vincoli, gli esiti catastrofici, la sensibilità alla scala delle ricompense e la robustezza al rumore di osservazione, al ritardo, all’errore dell’attuatore e a dinamiche modificate. Confrontare con controllo scriptato, controllo classico, imitazione supervisionata e RL più semplice. Tenere da parte variazioni dell’ambiente e testare metriche di risultato senza ricompensa, perché un agente può sfruttare la ricompensa programmata fallendo il compito previsto. L’ispezione di video e traiettorie spesso rivela comportamenti nascosti dal ritorno aggregato.
La simulazione consente l’esplorazione ma introduce un divario di realtà. Randomizzare la fisica e la percezione rilevanti, calibrare rispetto a misurazioni reali e utilizzare un trasferimento conservativo. I dati registrati o il RL offline evitano l’esplorazione online ma non possono valutare in modo affidabile azioni non supportate dalla politica di comportamento. I sistemi di produzione dovrebbero limitare l’insieme delle azioni, la frequenza, le risorse e l’involucro operativo; richiedere l’approvazione per azioni ad alto impatto; e includere un controllore sicuro verificato o un arresto. Monitorare gli input della politica, la distribuzione delle azioni, la ricompensa, i risultati reali e gli interventi, con rollback a una versione di politica testata.
Un esempio concreto di controllo
Per il routing di robot in un magazzino, definire lo stato a partire da posizione, carico, batteria, traffico circostante e coda di compiti; le azioni da movimenti consentiti e decisioni di ricarica; e la ricompensa dal lavoro completato, energia, congestione e vincoli di sicurezza. Addestrare prima in un simulatore calibrato con domanda randomizzata e guasti dei sensori, poi ombreggiare le decisioni reali. Non permettere mai che la politica appresa superi l’evitamento delle collisioni. Valutare il throughput insieme a quasi‑incidenti, deadlock, emergenze di batteria e ritardi nel caso peggiore. Il progetto ha successo solo se il sistema a strati migliora le operazioni senza trasferire rischi di esplorazione inaccettabili a persone o attrezzature.
Esempio pratico: DRL per il raffreddamento dei data center
Un data center limita un agente RL a setpoint di raffreddamento approvati e lo addestra in un simulatore calibrato su dati storici di meteo, carico di lavoro, temperature e risposta dell’attrezzatura. La ricompensa include l’energia ma vincoli rigidi proteggono separatamente temperatura, umidità e cicli dell’attrezzatura. Il controllo predittivo basato su modello e le regole esistenti fungono da baseline. La valutazione copre stagioni, rumore dei sensori, ritardo degli attuatori, perdita di attrezzature, carichi insoliti e più semi, riportando energia, violazioni, varianza e recupero.
La politica appresa viene eseguita in modalità shadow prima di una prova su zona limitata. Un controllore di sicurezza esterno limita le azioni e gli operatori possono intervenire. La frequenza delle azioni, la copertura dello stato, l’incertezza del modello e i risultati reali della struttura sono monitorati; una discrepanza del simulatore o interventi ripetuti attivano il rollback. L’aggiornamento dell’attrezzatura o della logica di controllo crea una nuova versione dell’ambiente e della validazione. I risparmi energetici sono accettati solo quando affidabilità, margine termico, manutenzione e risposta ai guasti rimangono almeno pari alla baseline.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, gli override umani e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disabilitato o sostituito.
Domande frequenti
Il deep reinforcement learning è lo stesso del deep learning?
No. Il deep learning fornisce gli approssimatori di funzioni; il reinforcement learning fornisce l’interazione, la ricompensa e l’obiettivo decisionale sequenziale.
Una ricompensa elevata significa che l’agente ha appreso il comportamento previsto?
Non necessariamente. Significa che la politica ha trovato un comportamento che ottiene un buon punteggio secondo la ricompensa e l’ambiente implementati. Sono comunque necessari test indipendenti di sicurezza e di allineamento agli obiettivi.
Riferimenti principali