Fondamenti di IA
Cos’è l’IA generativa?

 Aggiungi Unite.AI alle tue fonti preferite su Google
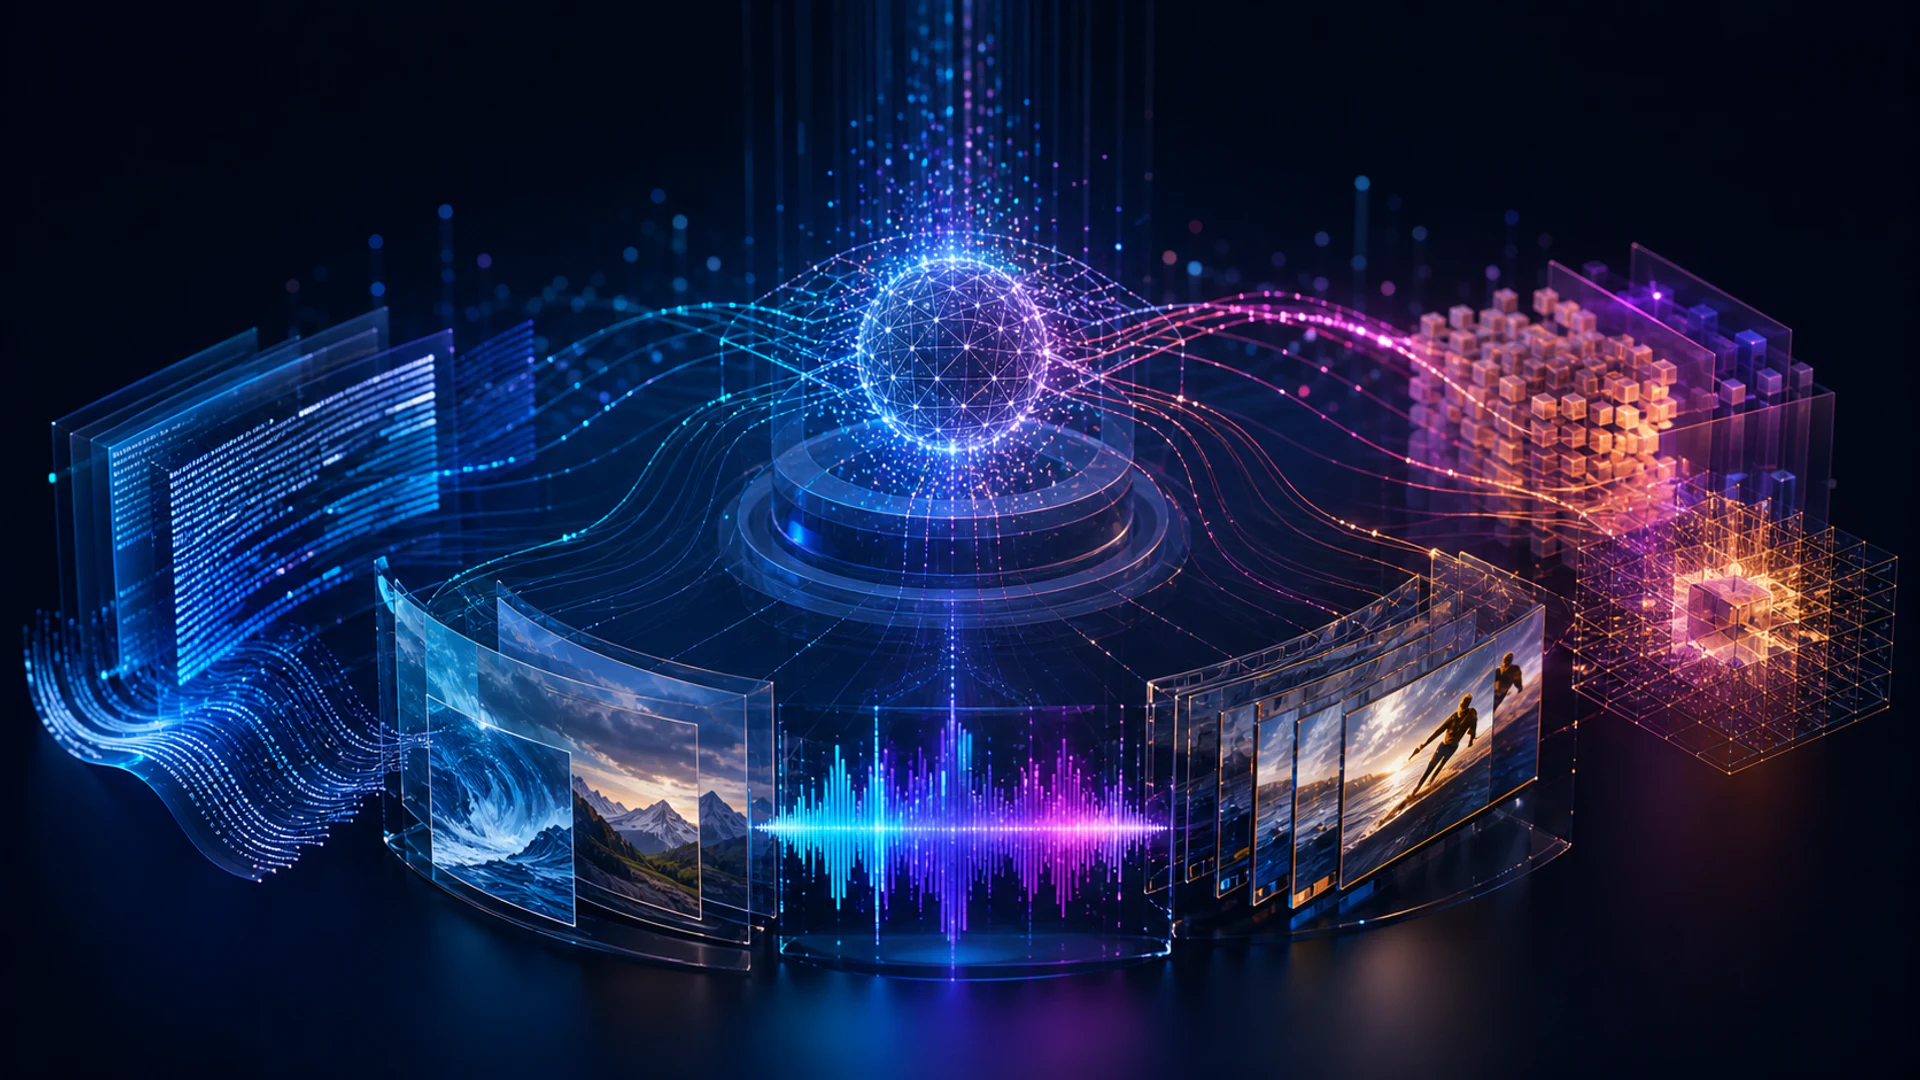
Generative AI indica i modelli che apprendono schemi nei dati e producono nuovo testo, immagini, audio, video, codice o altre rappresentazioni quando sono condizionati da istruzioni o esempi. L’output è sintetizzato da un modello probabilistico; non viene recuperato integralmente da un database, sebbene gli strumenti di recupero possano fornire evidenze esterne.
Le diverse famiglie di modelli generano in modi differenti. I transformer autoregressivi prevedono una sequenza token per token, i modelli di diffusione denoisano iterativamente un campione, e le reti generative avversarie (GAN) apprendono attraverso una competizione tra generatore e discriminatore.
Punti chiave
- La generazione è un campionamento condizionale da una distribuzione appresa, non garantisce il richiamo fattuale.
- Transformer, modelli di diffusione, GAN e autoencoder variazionali presentano compromessi differenti.
- Il recupero e gli strumenti possono ancorare un sistema, ma i loro output e permessi richiedono comunque una validazione.
- La gestione del rischio copre dati, modello, interfaccia, distribuzione, monitoraggio e provenienza dei contenuti.
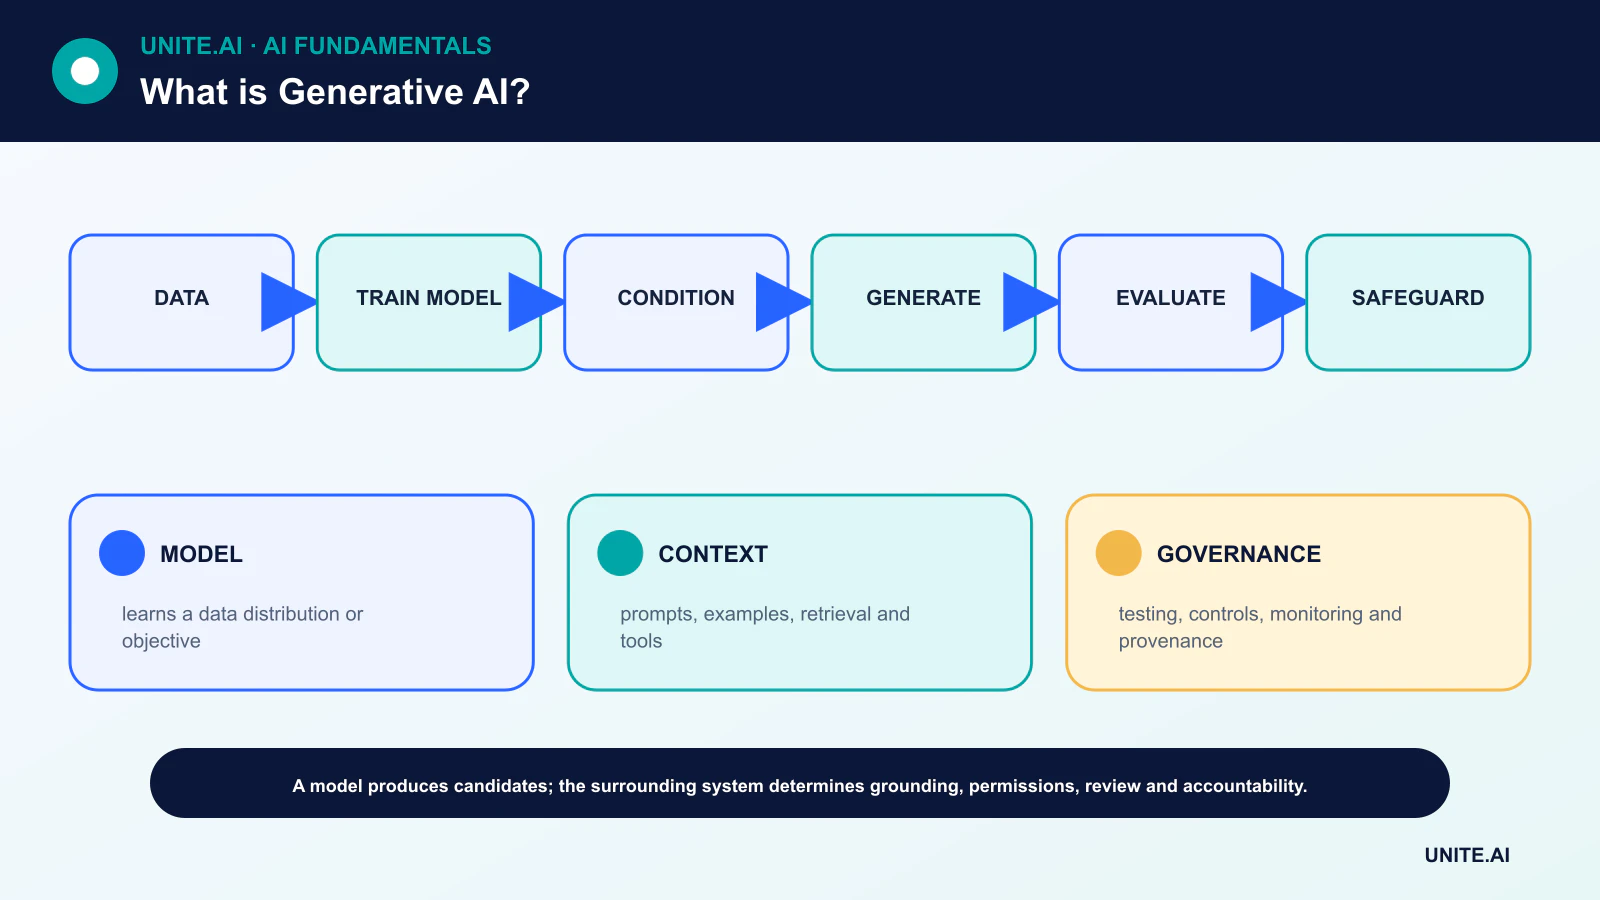
Come apprendono i modelli generativi
Obiettivi di addestramento premiano un modello per la previsione o la ricostruzione di schemi negli esempi. Un modello linguistico stima il token successivo; un modello di diffusione impara a invertire un processo di rumore; un autoencoder variazionale apprende una distribuzione latente strutturata e un decoder.
Questo addestramento genera una generalizzazione statistica, ma può anche riprodurre bias, memorizzare sequenze rare o fallire al di fuori della distribuzione dei dati. La documentazione del dataset, la deduplicazione, i controlli sulla privacy e la valutazione su dati di test sono quindi fondamentali prima del deployment.
Principali famiglie architetturali
I transformer autoregressivi dominano il testo e supportano sequenze multimodali. I modelli di diffusione sono ampiamente usati per la generazione di immagini e audio ad alta fedeltà. Le GAN possono creare campioni nitidi e sistemi di immagini controllabili, ma possono risultare difficili da addestrare.
Gli autoencoder variazionali forniscono modellazione a variabili latenti e rappresentazioni efficienti, talvolta operando all’interno di pipeline generative più ampie. I prodotti reali spesso combinano più modelli con recupero, filtri, strumenti e codice deterministico.
Condizionamento, campionamento e controllo
Un prompt, un’etichetta di classe, un’immagine, una clip audio o un record strutturato possono condizionare la generazione. I parametri di campionamento modificano diversità e determinismo. Una temperatura più bassa può concentrare le probabilità dei token, ma non rende vera una risposta errata.
Il controllo migliora quando il sistema utilizza schemi espliciti, decodifica vincolata, materiale di riferimento e validazione. Il prompt engineering modifica il contesto; il fine-tuning modifica i parametri; il recupero fornisce informazioni esterne. Ognuno affronta un diverso tipo di errore.
La valutazione è specifica per l’applicazione
I sistemi testuali possono richiedere test di factualità, completamento del compito, supporto alle citazioni, tossicità e calibrazione. I sistemi di immagine o audio possono necessitare di fedeltà, allineamento semantico, diversità, sicurezza dell’identità e revisione percettiva. È opportuno combinare metriche automatiche con valutazioni umane rappresentative.
Costruisci un set di valutazione versionato che includa casi ordinari, rari, avversari e rilevanti per le politiche. Monitora latenza, costo e comportamento di rifiuto oltre alla qualità dell’output. Una demo scelta dal suo creatore non è prova di affidabilità a livello di popolazione.
Rischi, salvaguardie e provenienza
I rischi principali includono allucinazioni, iniezione di prompt, contenuti dannosi, impersonificazione, uso insicuro di strumenti, perdita di privacy, controversie sul copyright, bias di automazione e catene di fornitura opache. Il Generative AI Profile di NIST organizza le azioni su governance, provenienza dei contenuti, test pre‑deployment e divulgazione degli incidenti.
Utilizza strumenti a minimo privilegio, controlli input/output, revisione umana per decisioni consequenziali, logging, rollback e segnalazione da parte degli utenti. Filigrane o credenziali di contenuto possono aggiungere segnali, ma nessun singolo rilevatore o etichetta stabilisce la verità. Il più ampio flusso di lavoro dei media sintetici deve preservare contesto e responsabilità.
Famiglie di modelli e meccanismi di generazione
I modelli di IA generativa stimano o apprendono un processo capace di produrre nuovo testo, immagini, audio, video, codice o dati strutturati. I modelli autoregressivi prevedono il token o l’elemento successivo; i modelli di diffusione apprendono a invertire un processo di rumore; gli autoencoder variazionali apprendono variabili latenti probabilistiche; le GAN addestrano un generatore contro un discriminatore. I sistemi multimodali collegano rappresentazioni tra media diversi. L’output è campionato dalla struttura statistica appresa, condizionato da prompt, contesto, strumenti o altri input, non è recuperato come un fatto garantito.
I modelli di base (foundation) sono preaddestrati su dati ampi e adattati tramite prompting, recupero, fine‑tuning, ottimizzazione delle preferenze, reti di controllo o teste specifiche per compito. Tokenizer, encoder, decoder, spazi latenti e impostazioni di campionamento modellano i risultati. Temperatura e filtraggio dei candidati bilanciano determinismo e diversità. Prompt più lunghi forniscono contesto ma possono confliggere, distrarre o contenere istruzioni malevole. Il recupero può ancorare conoscenze in evoluzione, mentre il codice deterministico dovrebbe gestire calcoli e regole esatti.
Valutazione, provenienza e diritti
Valuta per compito: correttezza fattuale e citazioni per le risposte, esecuzione e sicurezza per il codice, fedeltà e diversità per i media, e risultato umano per l’assistenza creativa. Includi rifiuto, calibrazione, latenza, costo, lingue, accessibilità e test avversari. Un output fluido o fotorealistico può essere errato. Conserva modello, prompt, seed, evidenza di origine, chiamate agli strumenti e post‑processing per la riproducibilità. Separa la qualità del recupero dalla generazione affinché una risposta rifinita non possa nascondere evidenze mancanti.
L’addestramento e gli output sollevano questioni di copyright, licenza, consenso, privacy, pubblicità e riservatezza. Stabilisci la provenienza e l’uso consentito dei dati di input; impedisci agli utenti di esporre segreti; testa la memorizzazione; e fornisci processi di segnalazione e rimozione. I media sintetici dovrebbero portare una provenienza durevole o una divulgazione dove possibile, soprattutto quando possono essere scambiati per prove. Non utilizzare somiglianze, voci o stili in modi che violino i diritti o ingannino.
Controlli di distribuzione
Considera l’output del modello come input non affidabile. Convalida gli schemi, sanitizza codice e file, isola l’esecuzione, autorizza ogni strumento esternamente, limita costi e velocità, e richiedi conferma per azioni consequenziali. Monitora fallimenti, abusi, drift e correzioni degli utenti, con rollback e una soluzione di fallback non generativa. Documenta l’uso previsto e quello proibito. L’IA generativa amplia l’interfaccia per creare e trasformare informazioni, ma affidabilità e responsabilità derivano dai dati circostanti, dalla valutazione, dalla sicurezza, dalla provenienza e dal processo decisionale umano.
Esempio pratico: un assistente generativo per descrizioni di prodotto
Un rivenditore consente agli editori di generare bozze di descrizioni solo a partire da attributi di prodotto approvati e linee guida del brand. Il prompt include fatti strutturati, mentre il recupero fornisce la politica corrente. L’output deve rispettare uno schema ed è convalidato rispetto ai valori di origine; dimensioni non supportate, affermazioni di sicurezza o certificazioni causano il rifiuto. La valutazione copre accuratezza fattuale, stile, duplicazione, qualità multilingue, accessibilità, latenza e correzione dell’editor, confrontata con modelli e scrittura manuale.
Gli editori approvano ogni pubblicazione e possono vedere i campi di origine. Il modello non ha la capacità di modificare prezzo, inventario o pubblicare direttamente. Prompt e dati di prodotto sono protetti da iniezioni, e le note confidenziali dei fornitori sono escluse. Il monitoraggio traccia affermazioni non supportate, modifiche, reclami, costi e versioni del fornitore. Il testo generato è archiviato con provenienza. Il sistema fa risparmiare tempo di redazione solo se correzioni e revisione non annullano il beneficio e la verità del prodotto rimane governata da dati autorevoli.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile di risposta, quindi rivedi le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che cambiano fonti dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto richiede anche procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
L’IA generativa è la stessa cosa di un modello linguistico di grandi dimensioni?
No. I LLM sono una classe di modelli generativi. L’IA generativa comprende anche sistemi di immagine, audio, video e dati strutturati costruiti con diverse architetture.
Un modello copia i dati di addestramento?
Di solito sintetizza a partire da schemi appresi, ma possono verificarsi memorizzazione e quasi duplicazione. I rischi di privacy e di provenienza devono essere valutati, non presunti.
Riferimenti principali