
Fondamenti di IA
Cos’è un Autoencoder?

 Aggiungi Unite.AI alle tue fonti preferite su Google
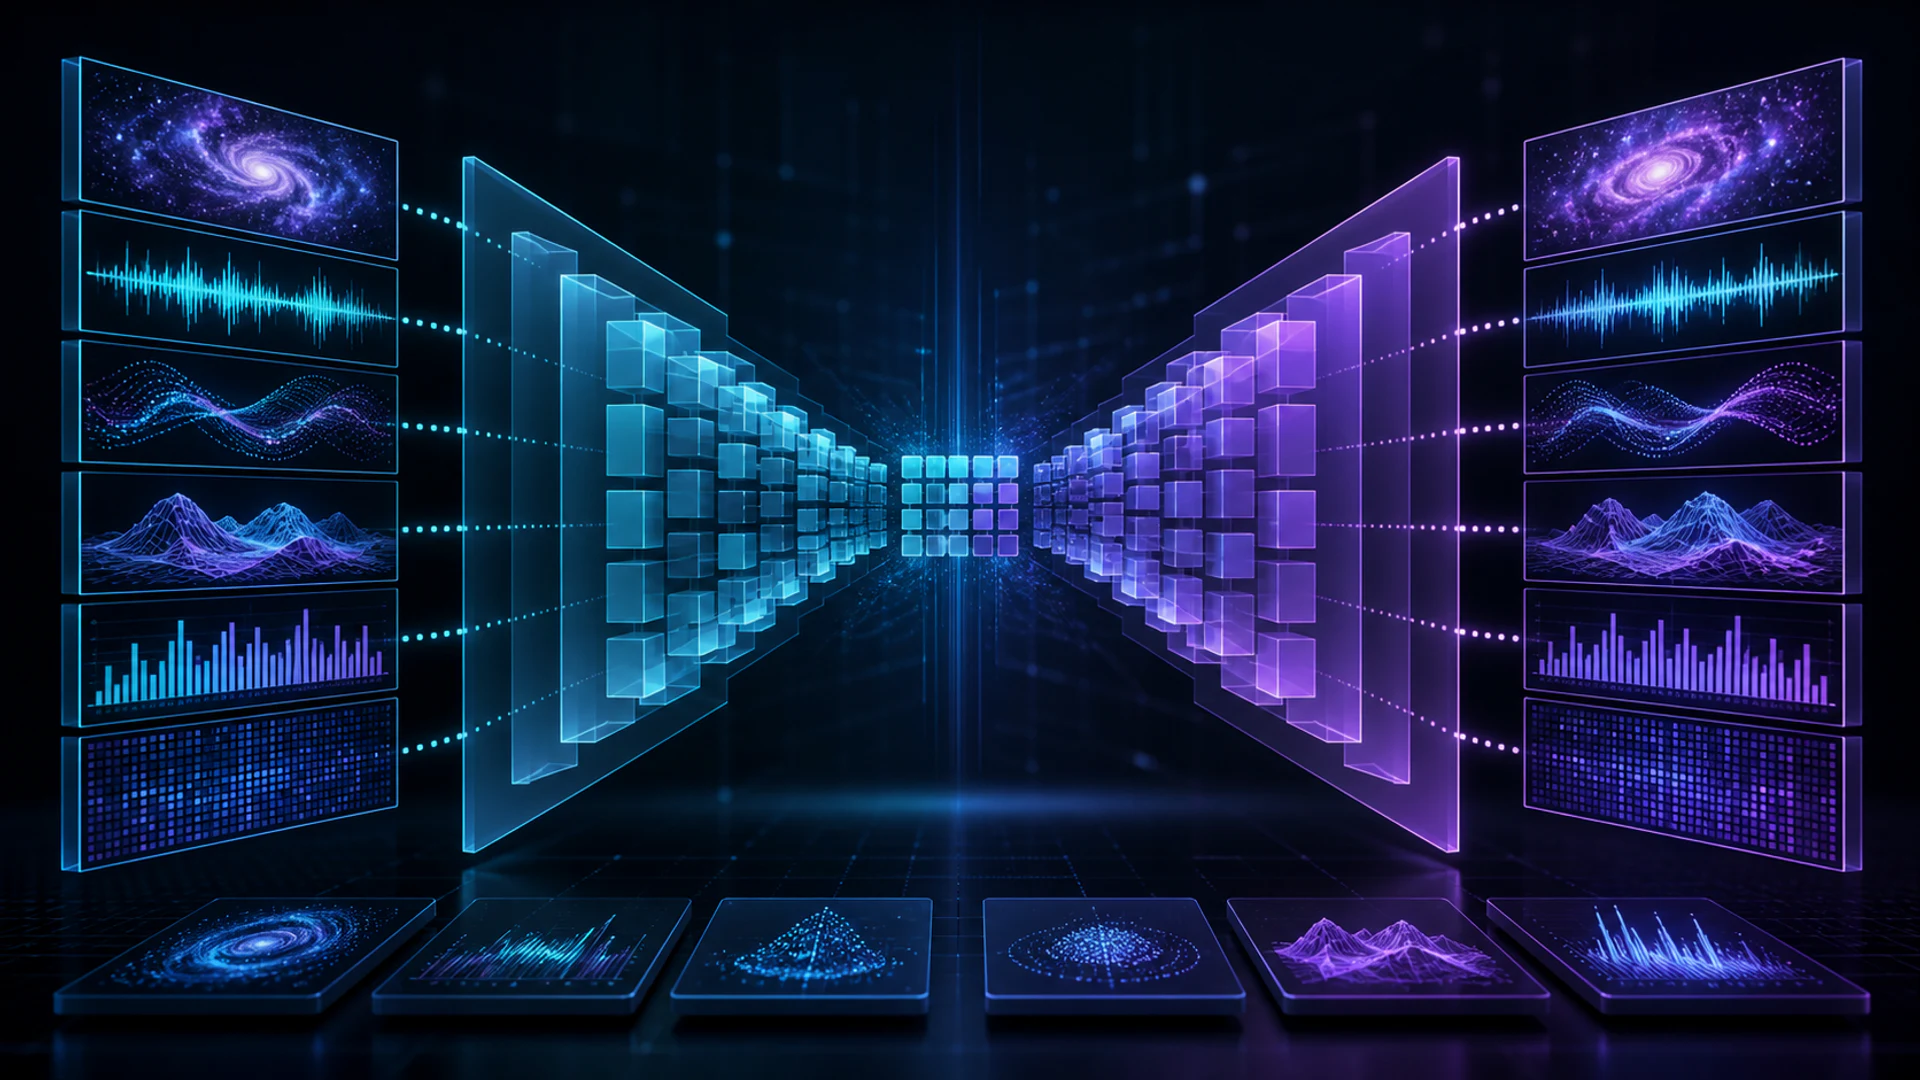
Un autoencoder è una rete neurale addestrata a ricostruire il proprio input. Un codificatore mappa l’input in una rappresentazione latente; un decodificatore riporta quella rappresentazione a una ricostruzione. L’addestramento minimizza una perdita di ricostruzione, talvolta con vincoli aggiuntivi.
Copiare perfettamente l’input non è automaticamente utile. L’architettura o l’obiettivo devono creare un collo di bottiglia, aggiungere rumore, imporre scarsità o altrimenti impedire una mappatura identità banale, così il codice latente cattura una struttura utile.
Punti chiave
- Il codificatore comprime o trasforma un input; il decodificatore lo ricostruisce a partire da un codice latente.
- Un collo di bottiglia sotto‑completo, il rumore o la regolarizzazione incoraggiano il modello a apprendere una struttura anziché copiare.
- L’errore di ricostruzione può supportare il rilevamento di anomalie, ma non è garantito che le anomalie presentino un errore elevato.
- Gli autoencoder variazionali apprendono un modello latente probabilistico e differiscono dagli autoencoder deterministici.
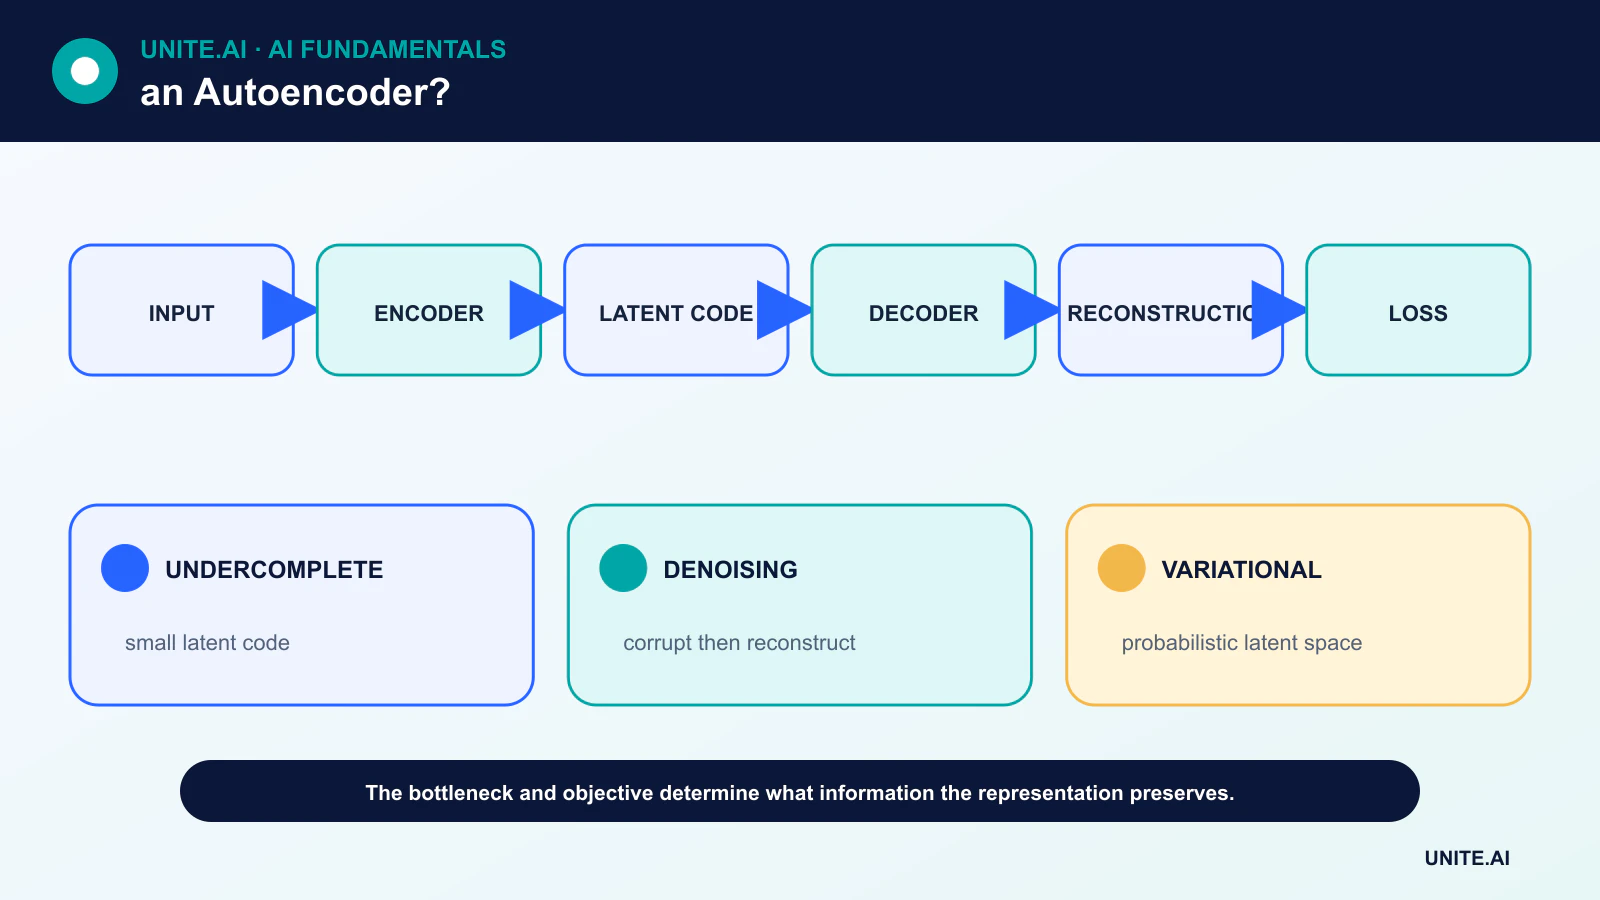
Codificatore, spazio latente e decodificatore
Per l’input x, il codificatore produce il codice latente z = f(x) e il decodificatore produce la ricostruzione x̂ = g(z). La perdita confronta x e x̂, ad esempio con l’errore quadratico medio per valori continui o con una verosimiglianza adatta ai dati.
La dimensione latente può essere più piccola dell’input, creando un autoencoder sotto‑completo. Una rete profonda può inoltre apprendere rappresentazioni non lineari, estendendo l’idea alla base della riduzione della dimensionalità.
Varianti comuni di autoencoder
Un autoencoder sparso penalizza l’attivazione diffusa. Un autoencoder denoising riceve un input corrotto e ricostruisce la versione pulita. Un autoencoder contrattivo penalizza la sensibilità del codice a piccole variazioni dell’input.
Un autoencoder variazionale (VAE) codifica i parametri di una distribuzione di probabilità, campiona un valore latente e bilancia la ricostruzione con un termine di regolarizzazione che modella lo spazio latente. Ciò consente il campionamento ma modifica l’obiettivo e l’interpretazione.
Addestramento ed evitamento di soluzioni banali
Gli autoencoder utilizzano il backpropagation come altre reti neurali. Una rete con capacità eccessiva può memorizzare gli esempi di addestramento o apprendere una funzione quasi identità. La dimensione del collo di bottiglia, la corruzione, le penalità e la validazione su dati non visti la limitano.
La scelta della perdita è importante. Una perdita pixel‑per‑pixel può produrre ricostruzioni di immagini sfocate, mentre le perdite percettive ereditano assunzioni da un’altra rete. La migliore metrica di ricostruzione non è necessariamente la migliore misura di similarità semantica.
Usi e limiti
Gli autoencoder possono apprendere caratteristiche, denoisare segnali, comprimere dati, inizializzare modelli e produrre variabili latenti per la visualizzazione. Per il rilevamento di anomalie, un modello addestrato su dati normali può assegnare un errore di ricostruzione più elevato a input insoliti.
Questo approccio può fallire quando l’autoencoder ricostruisce bene anche le anomalie o quando variazioni innocue sono più difficili da ricostruire rispetto all’anomalia target. Le soglie richiedono dati di validazione etichettati o attentamente revisionati, e l’errore dovrebbe essere monitorato per sottogruppo e condizione operativa.
Autoencoder rispetto ad altri modelli generativi
Un autoencoder deterministico non è automaticamente un modello generativo probabilistico. I VAE definiscono una distribuzione latente strutturata; i GAN addestrano un generatore contro un discriminatore; i modelli di diffusione apprendono un processo di denoising.
La scelta dipende dal fatto se l’obiettivo è ricostruzione, rappresentazione, verosimiglianza, fedeltà del campione, controllabilità o valutazione di anomalie. Un modello più piccolo e specifico per il compito è spesso più pratico di un grande generatore di immagini.
Obiettivi codificatore–decodificatore e rappresentazioni latenti
Un autoencoder apprende un codificatore che mappa l’input x in un codice latente z e un decodificatore che ricostruisce x da z. Se la capacità è illimitata, può apprendere una mappatura identità con poca struttura utile. Collo di bottiglia, regolarizzazione, corruzione, scarsità o vincoli architetturali forzano una rappresentazione che conserva le informazioni selezionate. La perdita di ricostruzione definisce cosa conta come simile: l’errore quadratico medio favorisce la fedeltà media dei pixel, mentre le perdite percettive o specifiche della modalità enfatizzano caratteristiche diverse. Una perdita bassa non garantisce un significato semantico.
Gli autoencoder sotto‑completi limitano la dimensione latente. Gli autoencoder denoising ricostruiscono dati puliti da input corrotto. Le varianti sparse penalizzano l’attivazione; le varianti contrattive penalizzano la sensibilità. Gli autoencoder variazionali apprendono una distribuzione latente probabilistica combinando la ricostruzione con un termine di divergenza, consentendo il campionamento ma modificando l’obiettivo. Autoencoder convoluzionali, sequenziali, a grafo e basati su transformer codificano la struttura della modalità. Scegli la dimensione latente e la regolarizzazione tramite validazione a valle, non solo tramite grafici bidimensionali attraenti.
Rilevamento di anomalie, compressione e valutazione
Per il rilevamento di anomalie, addestrare su dati normali rappresentativi e valutare l’errore di ricostruzione o la verosimiglianza latente, ma le anomalie a volte possono ricostruirsi bene e i casi normali rari possono farlo male. Seleziona soglie su casi di validazione etichettati o revisionati, riporta il richiamo a livello di evento e i falsi allarmi, e testa le variazioni nello stato operativo. Confronta con baseline statistiche semplici e a classe singola. Per la compressione, conta l’intero codec—comprese dimensione del modello, quantizzazione, metadati e calcolo di decodifica—e confronta la qualità a bitrate corrispondente con codec consolidati.
La qualità della rappresentazione può essere valutata tramite probe lineari, stabilità del clustering, recupero, ricostruzione e compiti a valle, ognuno rispondente a una domanda diversa. Evita perdite di informazione quando si apprende il codificatore e si selezionano le soglie. Ispeziona quali caratteristiche la perdita ignora e se gli attributi sensibili rimangono codificati. Un latente compresso non è automaticamente anonimizzato; l’inversione e l’inferenza di attributi possono recuperare informazioni private. Le ricostruzioni generate possono apparire plausibili pur modificando dettagli critici.
Distribuzione e monitoraggio
Versiona insieme codificatore e decodificatore, valida le variazioni numeriche dopo l’esportazione e conserva la scala dell’input. Monitora la distribuzione della ricostruzione, il drift latente, gli avvisi di soglia e i risultati confermati. Nella sorveglianza industriale, condiziona il modello sulla modalità operativa affinché le transizioni normali non siano trattate come guasti. Per la ricostruzione medica o scientifica, non presentare mai un dettaglio generato come evidenza misurata senza validazione e provenienza. Gli autoencoder sono apprendisti di rappresentazioni flessibili, ma sono i vincoli e la perdita — non il nome dell’architettura — a determinare quali informazioni vengono conservate, scartate o fabricate.
Esempio pratico: un autoencoder per anomalie di pompe
Un autoencoder sotto‑completo apprende finestre di vibrazione da operazioni di pompe sane verificate, attraverso carico e temperatura. Viene confrontato con soglie statistiche e metodi a classe singola, e la sua soglia di ricostruzione è selezionata su transizioni normali revisionate e guasti noti. La valutazione utilizza il richiamo degli eventi, il tempo di preavviso, i falsi allarmi per ora operativa e i risultati per pompa, non finestre casuali che collocano campioni adiacenti in addestramento e test.
Il modello di produzione è condizionato dallo stato operativo e espone i pattern residui agli ingegneri. Un errore elevato richiede un’ispezione; non diagnostica la parte né ferma automaticamente la pompa. Disconnessioni del sensore, clipping e carichi non visti generano stati esplicitamente non validi. Il monitoraggio traccia la distribuzione della ricostruzione, la conferma degli avvisi e la salute del sensore. Quando la manutenzione o l’hardware modificano la baseline, il modello vecchio rimane disponibile mentre un candidato viene addestrato su dati revisionati e testato contro incidenti storici.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire le soglie di avviso e un responsabile di risposta, quindi esaminare le evidenze reali dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Gli autoencoder sono una compressione senza perdita?
Non generalmente. Solitamente apprendono rappresentazioni con perdita specifiche per il compito e la distribuzione e richiedono il decodificatore addestrato per ricostruire i dati.
Ogni collo di bottiglia è interpretabile?
No. Un codice compatto può essere utile senza che ogni dimensione corrisponda a un concetto leggibile dall’uomo.
Riferimenti principali












