
Fondamenti di IA
Cos’è la Computer Vision?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Computer vision è il campo che costruisce sistemi in grado di estrarre informazioni utili da immagini e video. Un modello di visione può classificare un’intera immagine, localizzare oggetti, etichettare ogni pixel, leggere testo, stimare la posa, tracciare il movimento o collegare contenuti visivi al linguaggio.
I moderni sistemi di visione non si limitano a riprodurre il processo iniziale di rilevamento dei bordi della percezione umana. Apprendono rappresentazioni specifiche per il compito dai dati, spesso utilizzando reti neurali convoluzionali, vision transformer o modelli di base multimodali.
Punti chiave
- Classificazione, rilevamento, segmentazione, OCR, tracciamento e generazione sono compiti di visione distinti.
- Le CNN incorporano località e condivisione dei pesi; i vision transformer utilizzano l’attenzione sui patch dell’immagine.
- Le etichette possono provenire da esseri umani, supervisione debole, dati sintetici o obiettivi auto‑supervisionati.
- L’accuratezza da sola è insufficiente: la robustezza, la latenza, la privacy, i bias e i costi di fallimento sono importanti.
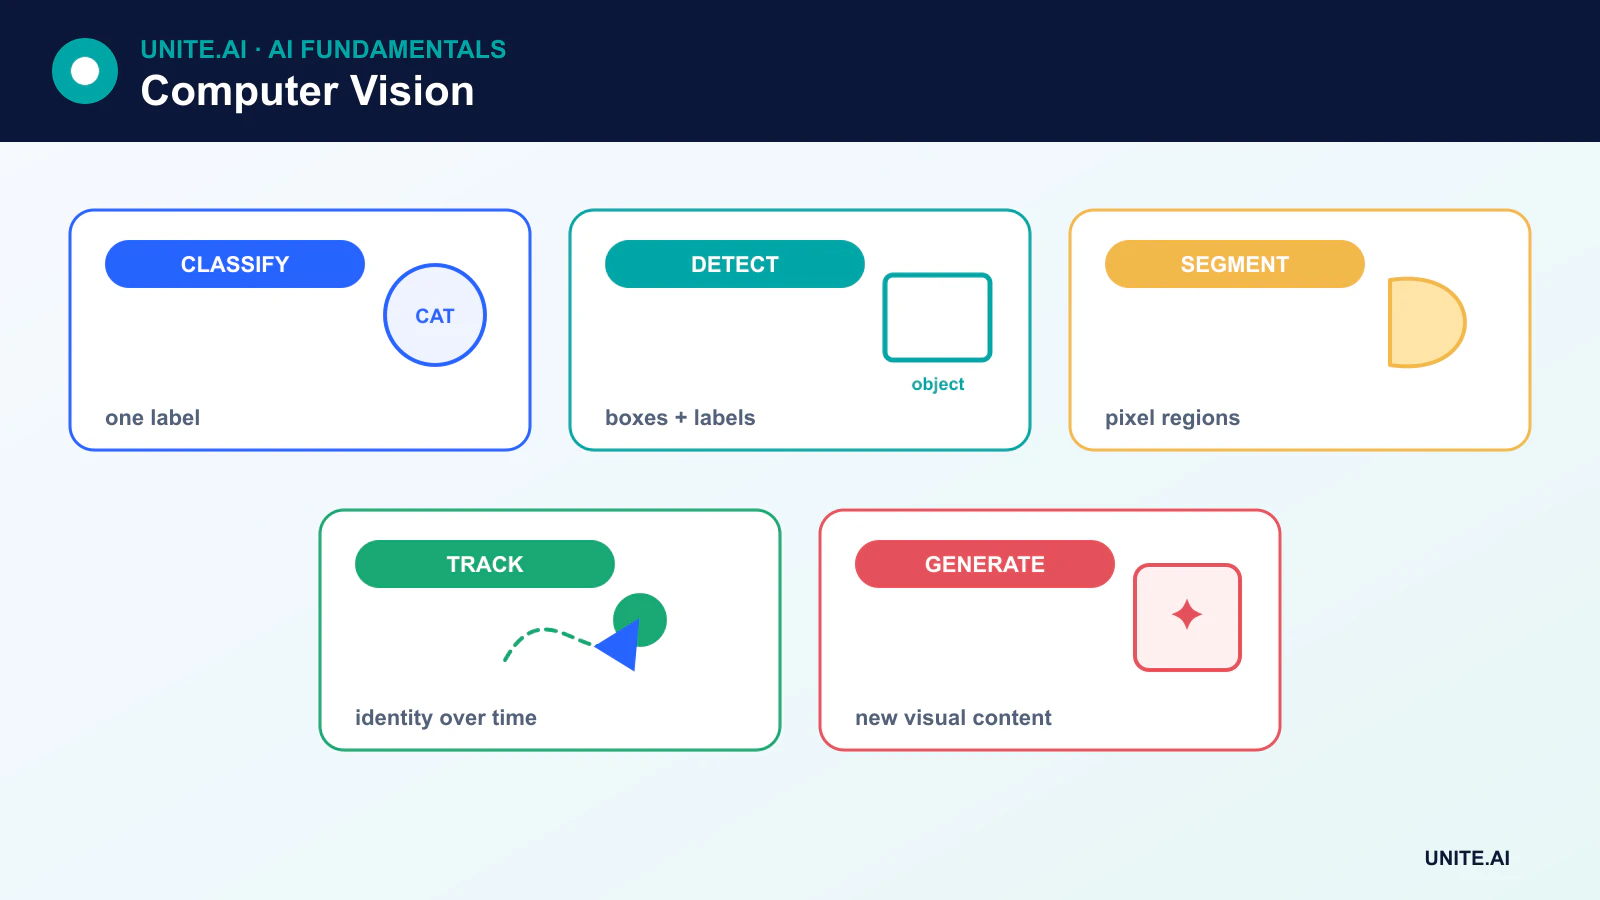
I principali compiti della computer vision
- Classificazione delle immagini assegna una o più etichette a un’immagine. Vedi come funziona la classificazione delle immagini.
- Rilevamento di oggetti prevede categorie e riquadri di delimitazione per più oggetti.
- Segmentazione semantica etichetta ogni pixel per classe, mentre la segmentazione di istanza separa gli oggetti individuali.
- Riconoscimento ottico dei caratteri (OCR) rileva e trascrive il testo.
- Stima della posa prevede punti di riferimento del corpo o dell’oggetto.
- Tracciamento associa le rilevazioni tra i fotogrammi video.
- Generazione e modifica di immagini produce o trasforma contenuti visivi, spesso utilizzando modelli di diffusione.
Come le immagini diventano input per i modelli
Un’immagine digitale è già dati numerici: un tensore contenente i valori dei pixel attraverso le dimensioni spaziali e i canali. Il preprocessing può ridimensionare, normalizzare, ritagliare o aumentare l’immagine. Il video aggiunge una dimensione temporale, mentre le immagini mediche e scientifiche possono aggiungere profondità, lunghezza d’onda o altre modalità.
La computer vision classica utilizzava caratteristiche di bordo, angolo e texture progettate manualmente. I moderni modelli deep solitamente apprendono le caratteristiche in modo congiunto con il compito, sebbene i metodi classici rimangano utili quando i dati sono limitati, le regole ben comprese o il calcolo deve essere minimo.
CNN e caratteristiche locali apprese
Una CNN applica kernel appresi su vicinanze locali. I primi strati possono rispondere a pattern locali, mentre i blocchi successivi li combinano in rappresentazioni rilevanti per il compito. Operazioni di pooling o con stride riducono la risoluzione spaziale, e le connessioni residuali rendono le reti profonde più facili da ottimizzare.
Un classificatore CNN moderno utilizza spesso il pooling globale anziché una grande pila di layer completamente connessi. I rilevatori e le reti di segmentazione aggiungono teste specializzate o percorsi decoder che preservano le informazioni spaziali.
Vision transformer e modelli di base
Un vision transformer suddivide un’immagine in patch, li incorpora e utilizza l’attenzione per modellare le loro relazioni. I transformer possono scalare efficacemente con grandi dataset e pre‑training, mentre le CNN spesso offrono assunzioni incorporate più robuste ed efficienza a scala più piccola.
I modelli multimodali allineano immagini e testo così gli utenti possono cercare, generare didascalie, rispondere a domande o guidare la segmentazione usando il linguaggio. Questi modelli ampliano le capacità ma ereditano anche le debolezze dei dati su scala web, inclusi stereotipi, materiale protetto da copyright e copertura disomogenea di popolazioni e ambienti.
Etichette, auto‑supervisione e dati sintetici
I riquadri di delimitazione, le maschere, i punti di riferimento e le didascalie possono essere costosi da creare. L’apprendimento auto‑supervisionato deriva gli obiettivi dalle stesse immagini, mentre la supervisione debole utilizza etichette rumorose o indirette. I dati sintetici possono aggiungere scenari rari, ma le lacune nella simulazione possono impedire che le prestazioni sintetiche si trasferiscano al mondo reale.
È necessario misurare la qualità dell’annotazione. Etichette ambigue, confini incoerenti e oggetti mancanti pongono un limite alle prestazioni e possono nascondere fallimenti di sottogruppi.
Come vengono valutati i sistemi di visione
La classificazione utilizza metriche come accuratezza, precisione, richiamo, F1 e calibrazione. Il rilevamento usa comunemente l’intersezione su unione (IoU) e la media di precisione (mAP). La segmentazione utilizza l’intersezione su unione o misure in stile Dice. Il tracciamento aggiunge metriche di identità e traiettoria.
La metrica deve corrispondere al contesto di deployment. Un modello può ottenere buoni punteggi su un benchmark curato e fallire comunque sotto pioggia, scarsa illuminazione, angolazioni di camera insolite, nuovi dispositivi o popolazioni sconosciute. La valutazione dovrebbe includere spostamenti di distribuzione, condizioni avversarie e latenza operativa.
Privacy, bias e deployment
Volti, targhe, abitazioni, scansioni mediche e video sul luogo di lavoro possono rivelare informazioni sensibili. La raccolta e la conservazione dovrebbero seguire una base legale ed etica definita, con controlli di accesso e minimizzazione dei dati. L’analisi facciale e l’identificazione biometrica richiedono particolare attenzione perché errori e sorveglianza possono causare danni disuguali.
Il deployment edge può ridurre latenza e trasferimento dati. Edge AI, quantizzazione, pruning e acceleratori specializzati possono rendere i sistemi di visione pratici su telecamere, veicoli, robot e dispositivi mobili, ma la compressione deve essere rivalutata per accuratezza e bias.
Da pixel a compiti visivi
La computer vision trasforma immagini o video in output di compiti come classificazione, rilevamento, segmentazione, tracciamento, posa, profondità, flusso ottico o riconoscimento del testo. La definizione del compito determina l’annotazione: un’etichetta di immagine non può addestrare una localizzazione precisa, e un riquadro di delimitazione non può descrivere completamente una maschera di segmentazione. La geometria della camera, le lenti, l’esposizione, l’illuminazione, il movimento, la compressione e il punto di vista modellano la distribuzione dei dati. Definire l’ambiente operativo e le conseguenze di errore prima di scegliere un modello, poiché una raccolta di immagini benchmark potrebbe non rappresentare il sensore o la scena in uso.
Una pipeline decodifica e orienta i media, ridimensiona o suddivide in tile, normalizza i valori, applica augmentazioni che preservano le etichette, esegue un modello e post‑processa logits, riquadri, maschere o tracciamenti. I rilevatori di oggetti usano soglie di confidenza e soppressione; i tracker associano le rilevazioni nel tempo; la segmentazione può richiedere pulizia morfologica. Conservare le trasformazioni di coordinate affinché gli output si allineino all’immagine originale. Suddividere i dati per persona, camera, luogo o sessione di acquisizione per evitare che fotogrammi quasi identici compaiano sia nel training sia nel set di test.
Valutazione, bias, privacy e operazioni
Le metriche devono corrispondere al compito e all’uso. La classificazione richiede precisione e richiamo specifici per classe; il rilevamento utilizza l’intersezione su unione e la precisione media attraverso soglie; la segmentazione usa IoU o Dice; il tracciamento aggiunge cambi di identità; latenza e durata degli eventi mancati sono importanti per il video. Riportare i risultati per illuminazione, distanza, dispositivo, occlusione, tono della pelle, età e altre condizioni rilevanti. Ispezionare calibrazione ed errori ad alta confidenza. Dati sintetici o aumentati possono colmare lacune ma richiedono confronto con dati di deployment reali e non devono trapelare scene di test.
La visione può raccogliere spettatori, luoghi, dati biometrici e comportamenti sensibili. Minimizzare la cattura e la conservazione, proteggere i flussi, limitare l’uso secondario e fornire avviso o consenso dove richiesto. Testare patch avversarie, replay, occlusione, guasti della camera e spostamento di dominio. Monitorare lo stato del sensore, le statistiche di input, le velocità di output e i risultati confermati; mantenere la revisione umana per decisioni con conseguenze. Sfocare o ritagliare può ridurre l’esposizione ma può anche rimuovere prove. Un alto punteggio in laboratorio non giustifica affermazioni di identità, emozione o intento al di là del compito validato.
Esempio pratico: rilevamento pedoni in un incrocio di magazzino
Le telecamere monitorano un incrocio veicolare limitato, e il modello rileva le persone senza identificarle. I dati coprono giorno e notte, condizioni meteo, abbigliamento, occlusioni, utenti di sedia a rotelle, posizioni delle telecamere e scene vuote, suddivisi per sessione di registrazione. Il rilevatore è valutato per richiamo degli eventi, falsi allarmi, localizzazione, tempo di preavviso e prestazioni a distanza. L’ingegneria della sicurezza definisce la latenza massima tollerata e i controlli fisici indipendenti.
L’allarme visivo può rallentare un veicolo, ma le fermate di emergenza e le barriere non dipendono dal modello appreso. Ostruzioni della camera, fotogrammi congelati, perdita di rete e timeout del modello generano guasti espliciti. La conservazione del video grezzo è minimizzata e gli accessi sono registrati. Il monitoraggio traccia lo stato del sensore, le frequenze di allarme, gli incidenti revisionati e i quasi incidenti per condizione. Qualsiasi spostamento o modifica della disposizione della telecamera innesca una rivalutazione perché la similitudine apparente delle immagini non garantisce la stessa geometria o rischio.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più probabilmente sottoserviti. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
La computer vision è la stessa cosa del riconoscimento delle immagini?
No. Il riconoscimento delle immagini solitamente si riferisce alla classificazione o all’identificazione. La computer vision include anche localizzazione, segmentazione, misurazione, tracciamento, ricostruzione, generazione e ragionamento sulle informazioni visive.
Un sistema di visione vede come un essere umano?
No. Un modello elabora input numerici secondo la sua architettura e l’obiettivo di addestramento. Può superare le persone su un benchmark ristretto, ma fallire su piccole variazioni che un individuo gestisce facilmente.
Riferimenti principali












