Fondamenti di IA
Cosa sono le CNN (Reti Neurali Convoluzionali)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
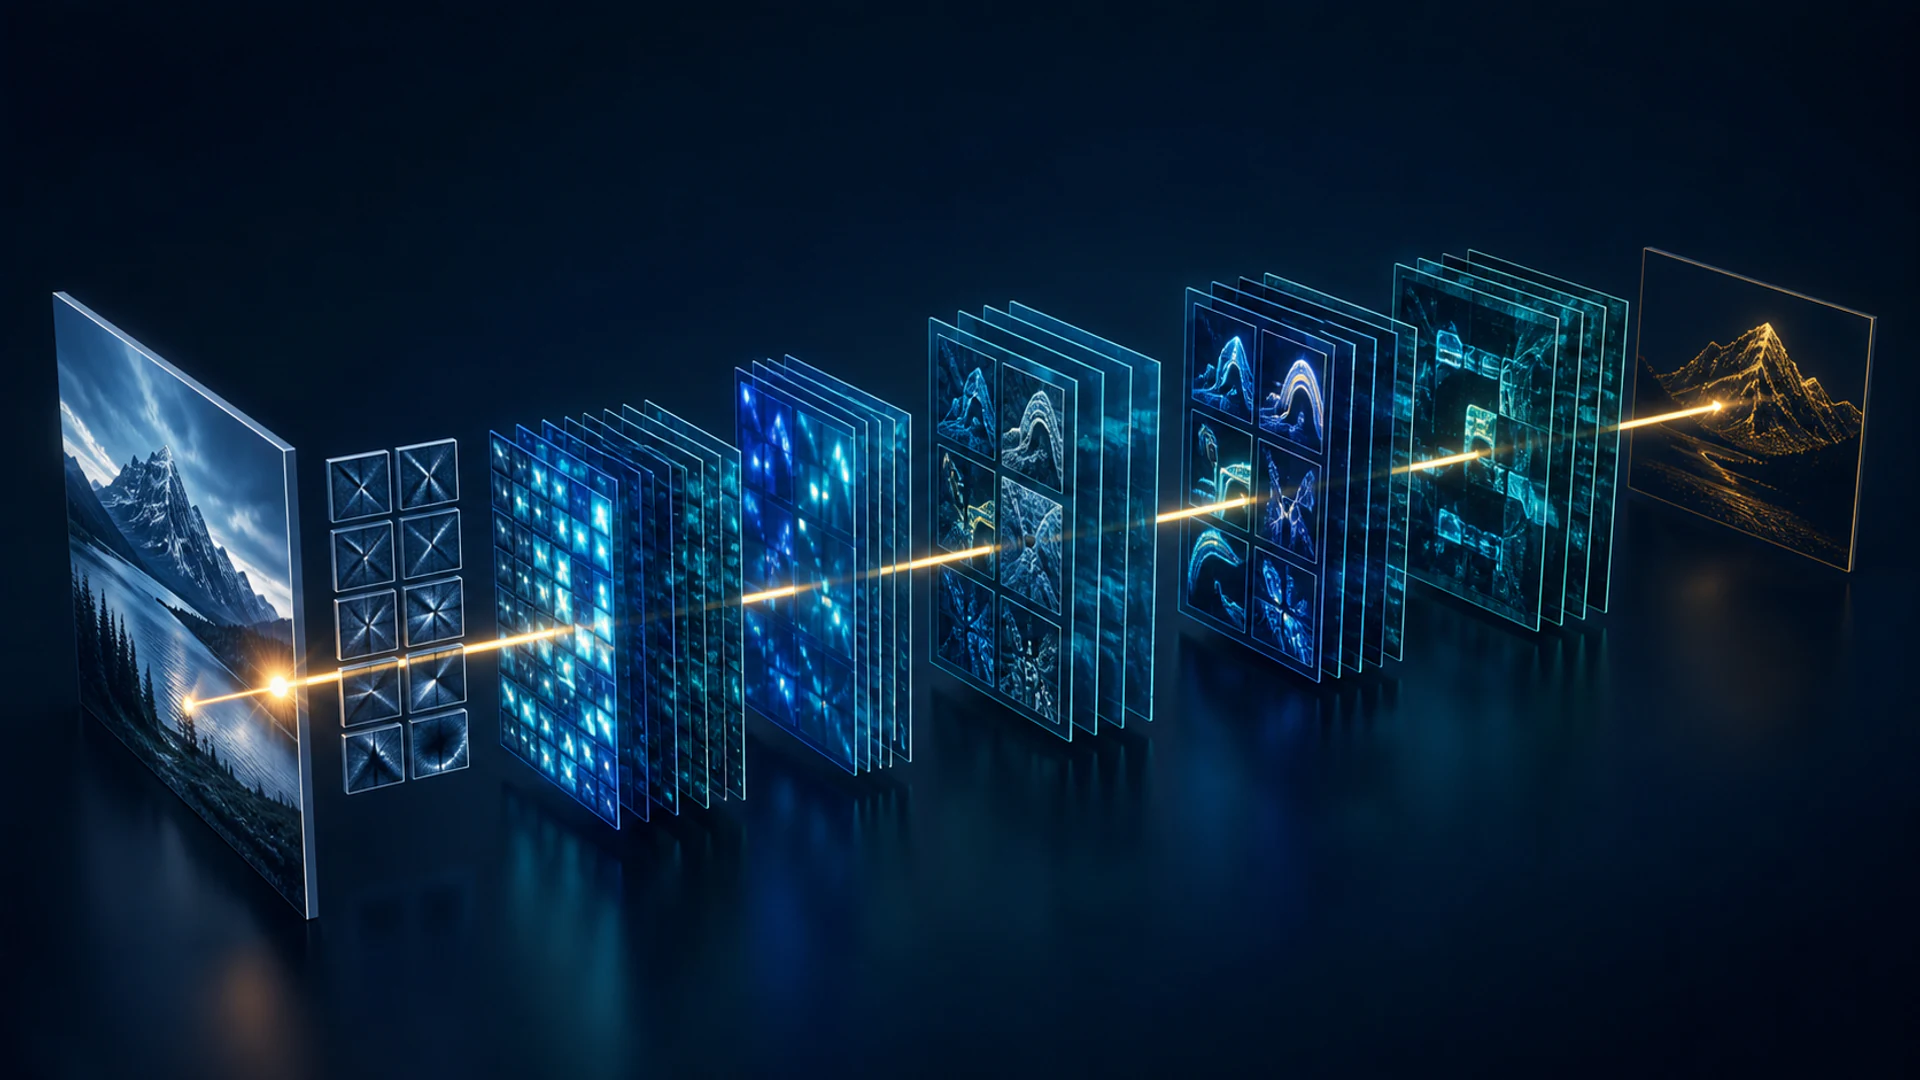
Una rete neurale convoluzionale (CNN) è un’architettura di rete neurale che utilizza filtri appresi su regioni locali di un input. Le CNN sono diventate fondamentali per la moderna visione artificiale perché possono rilevare schemi indipendentemente da dove appaiono e riutilizzare gli stessi parametri su un’intera immagine.
Una CNN non converte un’immagine da forma non numerica a numerica — l’immagine arriva già come tensore di valori di pixel. Il suo scopo è trasformare quel tensore in mappe di caratteristiche utili per la classificazione, il rilevamento, la segmentazione o altri compiti.
Punti chiave
- Una convoluzione combina i valori di input locali con un kernel appreso per produrre una mappa di caratteristiche.
- Stride, padding, dilatazione e pooling controllano la risoluzione spaziale e il campo recettivo.
- La condivisione dei pesi rende le CNN più efficienti in termini di parametri rispetto a una rete completamente connessa sui pixel grezzi.
- I vision transformer offrono un’alternativa, ma le CNN rimangono valide per sistemi efficienti e con dati limitati.
Come funziona la convoluzione
Un kernel è una piccola griglia di pesi addestrabili. In ogni posizione, la CNN moltiplica i valori del kernel per i corrispondenti valori di input, somma i risultati e solitamente aggiunge un bias. Ripetendo questa operazione sull’intero input si ottiene una mappa di caratteristiche.
Per un’immagine a colori, un kernel copre tutti i canali di input. Uno strato utilizza più kernel per creare più canali di output. Durante l’addestramento, la retropropagazione calcola i gradienti per questi pesi del kernel; l’operazione di convoluzione non genera un nuovo set fisso di pesi per ogni immagine.
Stride, padding e dilatazione
- Stride controlla di quanto il kernel si sposta. Uno stride maggiore di uno riduce la risoluzione spaziale.
- Padding aggiunge valori intorno a un input in modo che le informazioni di bordo possano essere elaborate e la dimensione dell’output possa essere controllata.
- Dilation separa gli elementi del kernel, ampliando il campo recettivo senza aumentare proporzionalmente i parametri.
Il campo recettivo è la regione dell’input originale che può influenzare un’unità. Impilare convoluzioni lo espande, consentendo alle caratteristiche successive di combinare informazioni da aree più ampie.
Attivazione, normalizzazione e pooling
Gli strati convoluzionali sono comunemente seguiti da attivazioni non lineari e normalizzazioni. Il pooling riassume le regioni locali mediante un’operazione come il massimo o la media. Le convoluzioni con stride apprese possono anche ridurre la risoluzione.
Il pooling non è obbligatorio. Molte reti moderne utilizzano il global average pooling vicino all’output invece di appiattire una grande mappa di caratteristiche in una pila completamente connessa. Ciò riduce i parametri e permette alla rete di aggregare evidenze spaziali.
Un’architettura CNN moderna
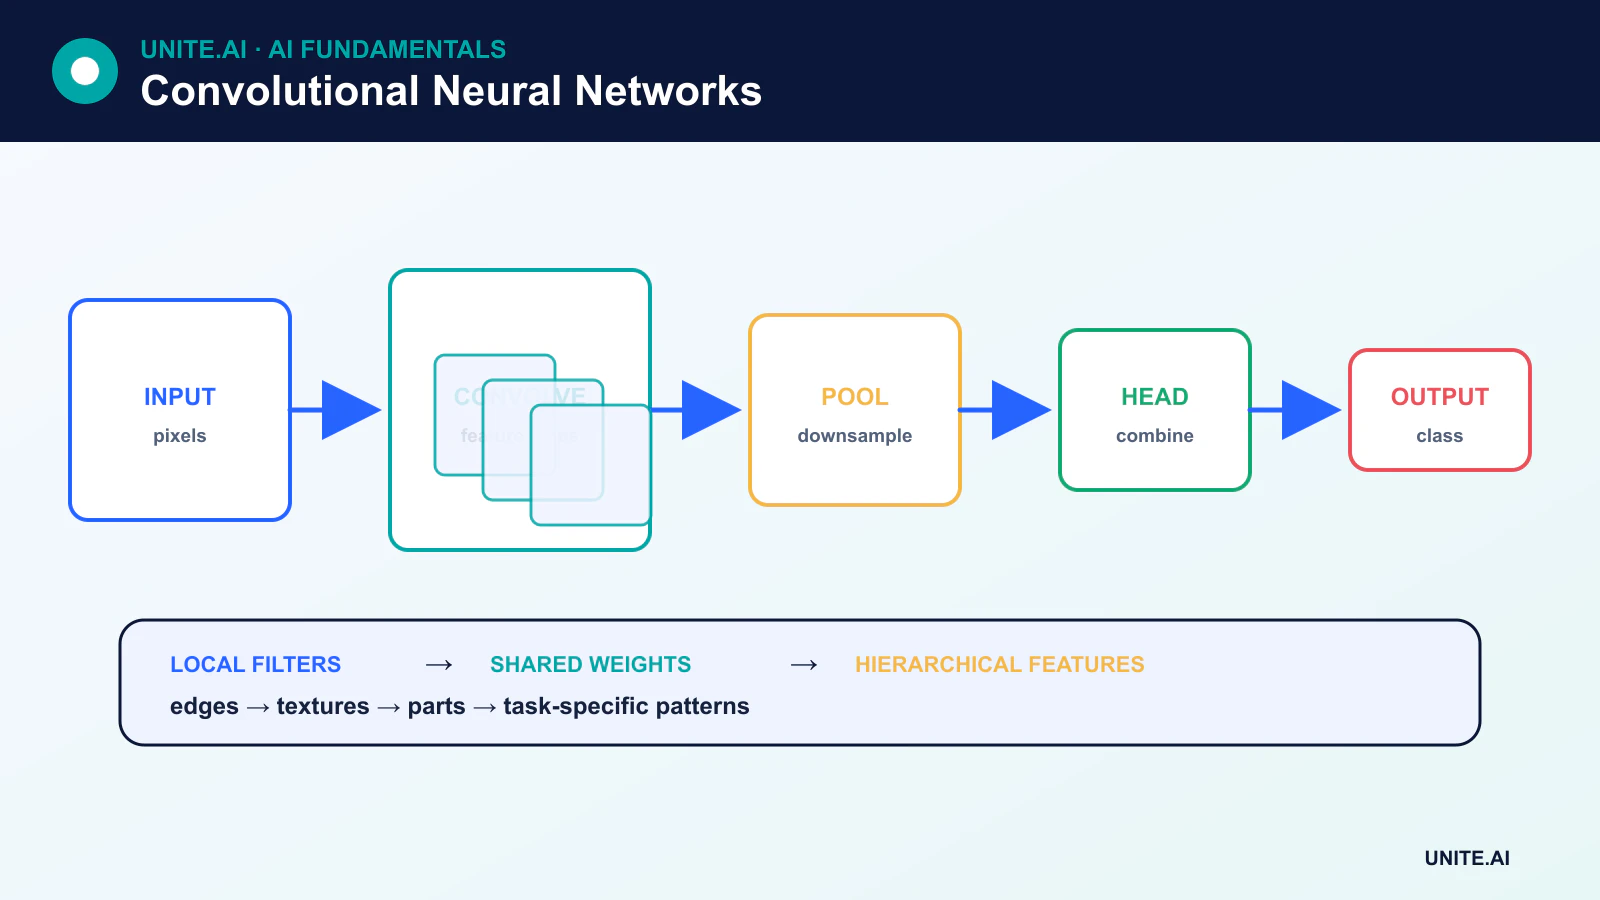
Un modello di visione tipico contiene uno stem, una sequenza di blocchi di caratteristiche, fasi di downsampling e una testa per il compito. Le connessioni residuali consentono a un blocco di apprendere una modifica al proprio input e forniscono un percorso diretto per informazioni e gradienti. Il successo delle reti residuali ha reso pratico l’addestramento di CNN molto più profonde.
Le teste di classificazione producono punteggi di classe. Le teste di rilevamento predicono categorie e riquadri. Le architetture di segmentazione aggiungono percorsi decoder che recuperano i dettagli spaziali. La stessa backbone CNN può essere riutilizzata tramite transfer learning.
Cosa apprendono gli strati CNN
È comune visualizzare i filtri iniziali che rispondono a bordi o texture e le rappresentazioni successive che correlano a parti o oggetti. Questa è un’intuizione utile, ma non è una regola fissa. Le caratteristiche dipendono dal compito, dall’architettura, dai dati, dall’obiettivo e dal processo di addestramento, e alcune unità combinano informazioni che non si mappano chiaramente a un concetto umano.
CNN vs vision transformer
I vision transformer dividono le immagini in patch e usano l’attenzione per modellare le relazioni tra di esse. Possono scalare efficacemente con grandi dataset di pre‑training. Le CNN incorporano direttamente nell’architettura assunzioni di località e di traslazione, il che può renderle più efficienti e più efficaci in termini di dati in contesti più piccoli.
Molti sistemi pratici combinano convoluzione e attenzione. L’architettura più adatta dipende da accuratezza, latenza, memoria, dati di addestramento, hardware e distribuzione — non da quale famiglia sia la più recente.
Limitazioni e considerazioni pratiche
Le CNN possono essere sensibili a cambiamenti di distribuzione, perturbazioni avversarie, scorciatoie di sfondo e dati di addestramento distorti. Non sono perfettamente invarianti a posizione, rotazione, scala o punto di vista. L’augmentazione e le scelte architetturali possono migliorare la robustezza, ma non la garantiscono.
Per la distribuzione, misurare latenza end‑to‑end, memoria, throughput e comportamento dei sottogruppi. Quantizzazione e pruning possono ridurre i costi, specialmente per l’edge AI, ma i modelli compressi devono essere ri‑validati.
Convoluzione, campi recettivi e blocchi CNN moderni
Uno strato convoluzionale scorre i kernel appresi su una griglia e condivide i pesi tra le posizioni. Dimensione del kernel, stride, dilatazione e padding determinano la forma dell’output e il campo recettivo. Gli strati iniziali spesso rispondono a bordi o texture locali; gli strati più profondi combinano informazioni su regioni più ampie, sebbene le rappresentazioni apprese non debbano corrispondere perfettamente a concetti umani. Il pooling o la convoluzione con stride riducono la risoluzione spaziale. I canali trasportano le mappe di caratteristiche, mentre le convoluzioni raggruppate e separabili in profondità scambiano la mescolanza tra canali per ridurre il calcolo. Le connessioni residuali rendono le reti molto profonde più facili da ottimizzare.
Per un’altezza e larghezza di input, il padding controlla il trattamento dei bordi e lo stride controlla il campionamento. Un downsampling aggressivo può cancellare piccoli oggetti; il padding zero può creare artefatti di bordo; la dilatazione espande il contesto senza la stessa crescita dei parametri ma può produrre griglie. La batch normalization dipende dalle statistiche di addestramento, mentre alternative possono comportarsi meglio con batch di piccole dimensioni. Le architetture moderne combinano bottleneck, caratteristiche multi‑scala, attenzione o residuali invertiti. Scegli l’architettura in base alla risoluzione del compito, alla larghezza di banda della memoria, alla latenza e all’hardware di destinazione, piuttosto che solo all’accuratezza nella classificazione di immagini.
Addestramento, interpretazione e distribuzione
Usa augmentazioni che preservano le etichette e riflettono variazioni reali, e suddividi per soggetto o scena prima dell’augmentazione. Il transfer learning è comune: sostituisci la testa del compito, addestrala, poi sblocca cautamente il backbone. Valuta le prestazioni specifiche per classe, la calibrazione, la robustezza a sfocatura, compressione, illuminazione, scala, ritaglio e perturbazioni avversarie. Metodi di visualizzazione come le mappe di caratteristiche e la salienza possono rivelare scorciatoie, ma sono sensibili al metodo e al baseline. Conferma la dipendenza sospetta con immagini controfattuali, test di occlusione o modifiche al dataset.
Le CNN esportate possono essere fuse, quantizzate o compilate per GPU, NPU, browser o microcontrollore. Convalida il grafo distribuito, inclusi preprocessing e postprocessing, sui dispositivi esatti. Misura latenza end‑to‑end, memoria, energia e comportamento termico; la decodifica dell’input può dominare un modello piccolo. Monitora le statistiche della fotocamera e dell’immagine, la distribuzione dell’output e gli errori confermati. Artefatti di modello firmati, canali di aggiornamento protetti e fallimenti eleganti dei sensori fanno parte del design di produzione. Le CNN codificano un utile bias di località, ma non comprendono automaticamente oggetti o scene causali.
Esempio pratico: distribuzione di una CNN su una telecamera di ispezione
Una CNN classifica difetti di superficie da immagini line‑scan ad alta risoluzione. Gli ingegneri suddividono le immagini in tasselli con sovrapposizione affinché i piccoli difetti sopravvivano al downsampling, preservano le coordinate per la revisione e convalidano le augmentazioni rispetto a variazioni ottiche reali. Una CNN residuale e un modello depthwise più leggero sono confrontati con recall equivalente. I test includono difetti di bordo, riflessi, compressione, movimento, lotti di materiale e sostituzioni della telecamera, con lotti di produzione indipendenti riservati alla valutazione finale.
La compilazione fonde e quantizza il modello per un acceleratore edge, ma il grafo distribuito è confrontato con il riferimento su casi di difetti sensibili. Decodifica, tassellatura, inferenza e latenza di merge sono misurate end‑to‑end. Il sistema segnala pixel morti e deriva di esposizione separatamente dai difetti di prodotto. Gli operatori possono ispezionare i tasselli di origine e sovrascrivere i risultati. Le modifiche al modello e alla telecamera vengono rilasciate gradualmente, e la linea mantiene una procedura di ispezione manuale sicura quando la pipeline di visione non è disponibile.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, cambiamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile di risposta, poi rivedi le prove dal mondo reale dopo la distribuzione anziché presumere che le prestazioni offline persistano. Rivaluta ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
Una CNN ha sempre bisogno del pooling?
No. Una CNN può effettuare il downsampling con convoluzioni a stride e può preservare la risoluzione per previsioni dense. Il pooling è uno strumento di progettazione, non un requisito obbligatorio.
I filtri CNN sono progettati manualmente?
In una CNN addestrata, i valori del kernel sono normalmente appresi dai dati. Questo differisce dai filtri di visione classici i cui coefficienti sono scelti in anticipo per operazioni come il rilevamento dei bordi.
Riferimenti principali