
Fondamenti di IA
Che cos’è il backpropagation?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Backpropagation è l’algoritmo usato per calcolare come la perdita di una neural network varia rispetto ai suoi parametri addestrabili. Applica la regola della catena del calcolo all’indietro attraverso le operazioni registrate durante un forward pass.
Backpropagation calcola i gradienti; non decide, da solo, l’aggiornamento. Un ottimizzatore come lo stochastic gradient descent o AdamW utilizza quei gradienti per modificare pesi, bias e altri parametri addestrabili.
Punti chiave
- Il forward pass costruisce valori intermedi e produce una previsione.
- La funzione di perdita converte la previsione e il target in un obiettivo di addestramento scalare.
- Backpropagation utilizza le derivate locali e la regola della catena per calcolare efficientemente i gradienti dei parametri.
- I framework moderni implementano la differenziazione automatica in modalità reverse su un grafo computazionale.
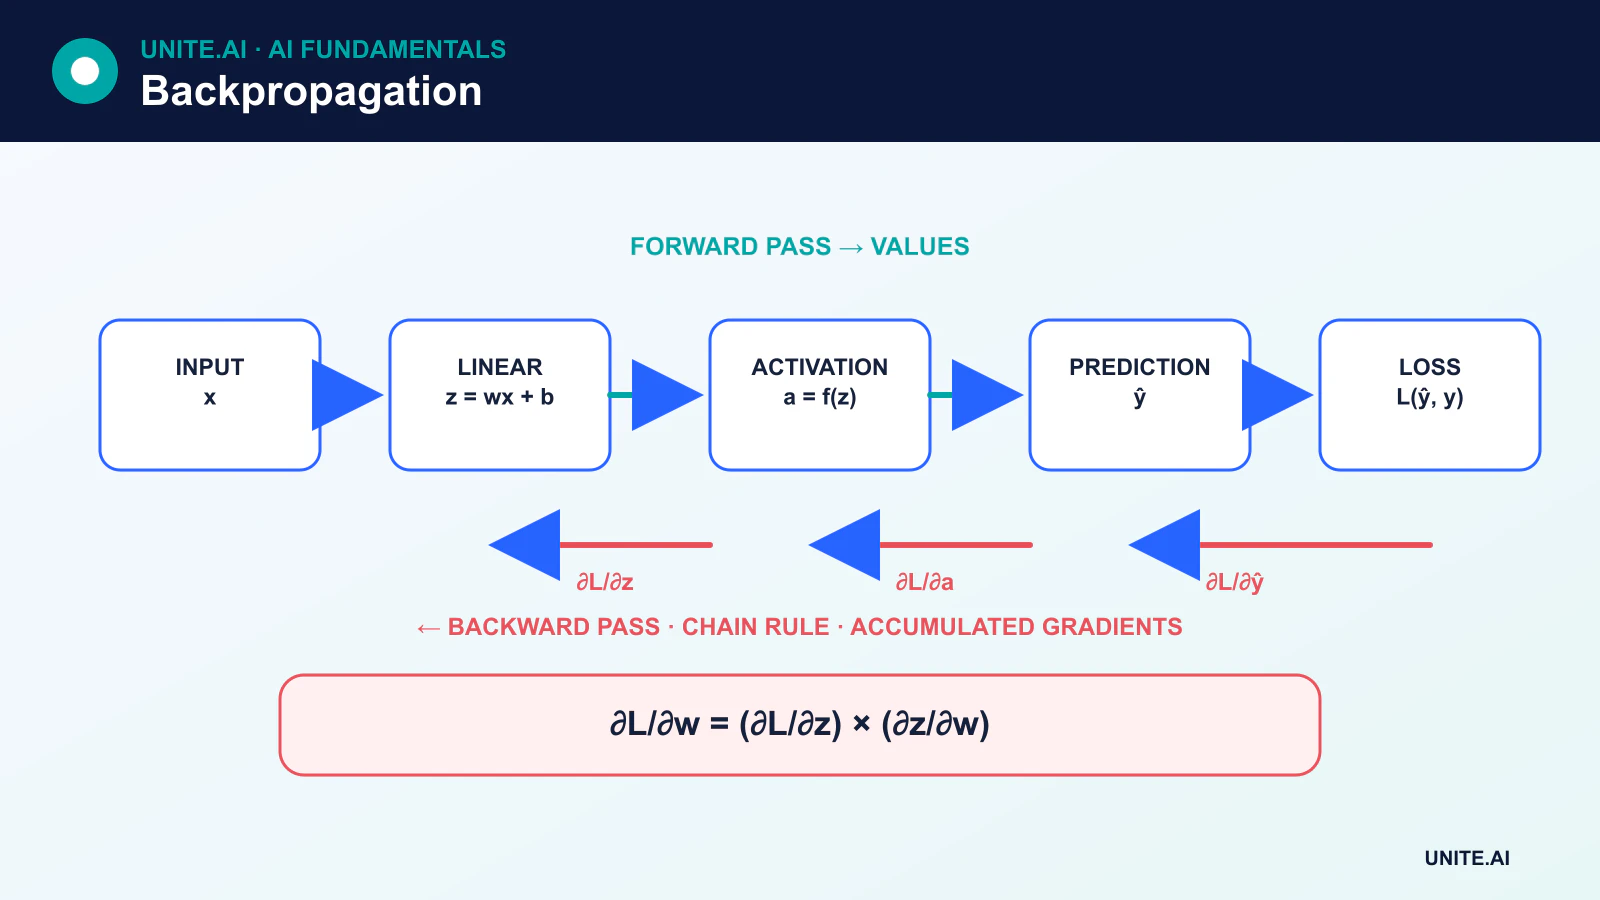
Il forward pass
Consideriamo un’unità semplice:
z = wx + bŷ = activation(z)
L’input è x, mentre w e b sono parametri di peso e bias addestrabili. I bias normalmente cambiano durante l’addestramento così come i pesi. Una rete combina molte di queste operazioni, oltre a normalizzazione, attenzione, convoluzioni, connessioni residuali o altri blocchi differenziabili.
Il forward pass valuta queste operazioni e produce una previsione. Una perdita come la cross‑entropy o l’errore quadratico medio misura l’obiettivo. La perdita più adatta dipende dal compito e dall’interpretazione dell’output.
La regola della catena
Se la perdita L dipende da un valore intermedio z, e z dipende dal parametro w, la regola della catena fornisce:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Una rete profonda contiene molti percorsi. Backpropagation attraversa il grafo computazionale in senso inverso, accumulando contributi quando un valore influisce sulla perdita attraverso più di un percorso. Il risultato è un gradiente per ogni parametro addestrabile che ha partecipato al calcolo forward.
Un piccolo esempio numerico
Supponiamo ŷ = wx + b, con x = 2, w = 3 e b = 1. La previsione è 7. Se il target è 5 e la perdita è L = ½(ŷ - y)², allora:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
L’ottimizzatore può quindi spostare w e b nella direzione del gradiente negativo. Questa formula è specifica per l’unità lineare scelta e la perdita di errore quadratico; una regola universale di backpropagation è la regola della catena sul grafo reale, non una singola equazione “errore” fissa.
Backpropagation vs. discesa del gradiente
Gradient descent è un metodo di ottimizzazione. Backpropagation fornisce i gradienti necessari. Un passo di addestramento di solito segue:
- Cancella o reimposta i gradienti memorizzati.
- Esegui il forward pass.
- Calcola la perdita.
- Esegui il backward pass.
- Applica l’aggiornamento dell’ottimizzatore.
Separare questi concetti facilita la comprensione di momentum, AdamW, accumulo di gradienti e addestramento a precisione mista.
Differenziazione automatica
Framework come PyTorch registrano le operazioni e costruiscono un grafo durante il forward pass. La differenziazione automatica in modalità reverse calcola quindi in modo efficiente i prodotti vettore‑Jacobian dagli output ai parametri. Questo è più generale rispetto alla codifica manuale delle derivate per una rete fissa ed è fondamentale per i moderni framework di deep learning.
Alcune operazioni non sono differenziabili o hanno derivate instabili. I framework definiscono subgradienti o convenzioni documentate in certi casi, ma i professionisti devono comunque comprendere tensori staccati, operazioni in‑place e precisione numerica.
Gradienti che svaniscono ed esplodono
Moltiplicazioni ripetute attraverso molte layer o passi temporali possono rendere i gradienti estremamente piccoli o grandi. I gradienti che svaniscono rallentano l’apprendimento nei layer precedenti; i gradienti che esplodono destabilizzano gli aggiornamenti. Attivazioni della famiglia ReLU, inizializzazioni accurate, connessioni residuali, normalizzazione, ricorrenze con gate e clipping dei gradienti aiutano, ma nessuna è una cura universale.
Verifica dei gradienti
Il controllo dei gradienti a differenze finite confronta un gradiente analitico o automatico con un’approssimazione numerica. È lento ma utile per il debug di operazioni personalizzate. Monitorare le norme dei gradienti e rilevare valori NaN o infiniti può rivelare instabilità durante l’addestramento.
La regola della catena attraverso un grafo computazionale
Backpropagation calcola in modo efficiente i gradienti di una perdita scalare rispetto a ogni parametro differenziabile. Un forward pass registra i valori intermedi in un grafo computazionale. Partendo dalla perdita, la differenziazione automatica in modalità reverse applica la regola della catena, moltiplicando le derivate locali e accumulando i contributi dove i percorsi si incontrano. Per uno strato y=f(x,w), la sensibilità a monte di y si combina con le derivate parziali per produrre sensibilità per x e w. Backpropagation calcola i gradienti; l’ottimizzatore decide come i parametri cambiano.
Un semplice strato affine produce y=Wx+b. Il gradiente per W è il prodotto esterno del gradiente a monte e dell’input, il gradiente per b somma i valori a monte, e il gradiente dell’input si moltiplica per la matrice dei pesi trasposta. Le attivazioni aggiungono derivate elemento per elemento. Convoluzione, normalizzazione, attenzione e riuso ricorrente seguono lo stesso principio del grafo ma richiedono forme di tensore corrette, broadcasting, masking e condivisione dei parametri. I framework liberano le attivazioni salvate dopo il backward a meno che non siano mantenute, così la memoria spesso cresce con batch, profondità e lunghezza della sequenza.
Fallimenti dei gradienti, verifica e pratica ingegneristica
Il prodotto di molte derivate può svanire o esplodere. Attivazioni simili a ReLU, inizializzazioni accurate, normalizzazione, connessioni residuali, gating e clipping dei gradienti affrontano meccanismi diversi. Attivazioni saturate e operazioni non differenziabili possono bloccare segnali utili; il backpropagation troncato limita la storia della sequenza; la precisione mista può subire underflow senza scaling della perdita. I gradienti che esplodono sono un sintomo, quindi il clipping dovrebbe accompagnare l’indagine su learning rate, dati, architettura ed errori numerici anziché nasconderli.
Verifica le operazioni personalizzate con controlli dei gradienti a differenze finite su piccoli input a doppia precisione, evitando punti non differenziabili. Ispeziona le norme dei gradienti, NaN, parametri inattivi e se i gradienti raggiungono i moduli attesi. Cancella deliberatamente i gradienti accumulati e distingui il comportamento di addestramento da quello di valutazione per dropout e normalizzazione. Il checkpoint ricomputa le attivazioni per risparmiare memoria; l’addestramento distribuito deve aggregare i gradienti in modo coerente. Una perdita di addestramento decrescente mostra che esiste un percorso di ottimizzazione, non che i gradienti siano concettualmente corretti, i dati privi di perdite o che il modello generalizzi.
Esempio pratico: verifica di un layer neurale personalizzato
Un ingegnere implementa un layer spettrale differenziabile per una rete audio. Un piccolo test a doppia precisione confronta i gradienti automatici con differenze finite centrali su input e parametri, escludendo i punti in cui l’operazione è intenzionalmente non differenziabile. Forma, broadcasting, padding e conversione da complesso a reale ricevono casi separati. Il test verifica i gradienti accumulati quando un parametro è riutilizzato e conferma che i frame audio mascherati non producono gradiente.
Durante l’addestramento, i cruscotti monitorano le norme dei gradienti e delle attivazioni, NaN, parametri inattivi e lo scaling della perdita. Un batch deliberatamente corrotto conferma che la validazione intercetta output non finiti prima di un aggiornamento dell’ottimizzatore. Le implementazioni a precisione mista ed esportate sono confrontate con il riferimento. I test di ripresa del checkpoint includono lo stato dell’ottimizzatore e l’ordine casuale. Il layer non è accettato solo perché la perdita totale diminuisce; i gradienti unitari, la stabilità numerica e la generalizzazione a valle devono tutti fornire prove coerenti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni al contorno, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più probabilmente trascurati. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile di risposta, quindi rivedere le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disabilitato o sostituito.
Domande frequenti
Il backpropagation aggiorna i pesi?
Backpropagation calcola i gradienti. L’ottimizzatore applica un aggiornamento usando tali gradienti, il suo tasso di apprendimento e possibilmente uno stato come momentum o momenti adattivi.
Il backpropagation è biologicamente realistico?
Il backpropagation standard è un algoritmo ingegneristico e non è accettato come modello dettagliato dell’apprendimento nei cervelli biologici. L’analogia neurale storica non dovrebbe essere considerata equivalente a livello biologico.
Riferimenti principali












