Fondamenti di IA
Cos’è l’overfitting?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Overfitting si verifica quando un modello cattura pattern o rumore che funzionano eccezionalmente bene sui dati di addestramento ma non riescono a generalizzare a nuovi esempi. Un modello overfittato può avere un errore di addestramento molto basso, mentre le prestazioni di validazione o nel mondo reale sono sostanzialmente peggiori.
Il problema opposto è underfitting: il modello o il processo di addestramento non riescono a catturare sufficientemente il segnale anche sul set di addestramento. Una buona modellazione bilancia l’adattamento con la generalizzazione invece di perseguire una performance di addestramento perfetta.
Punti chiave
- Le sole prestazioni di addestramento non possono diagnosticare la generalizzazione.
- L’interruzione anticipata dovrebbe basarsi sul comportamento di validazione, mai su decisioni ripetute sul set di test finale.
- Più dati possono aiutare, ma più caratteristiche o capacità possono anche peggiorare l’overfitting.
- Regolarizzazione, augmentazione, cross‑validation, prevenzione delle perdite di dati e valutazione appropriata affrontano cause diverse.
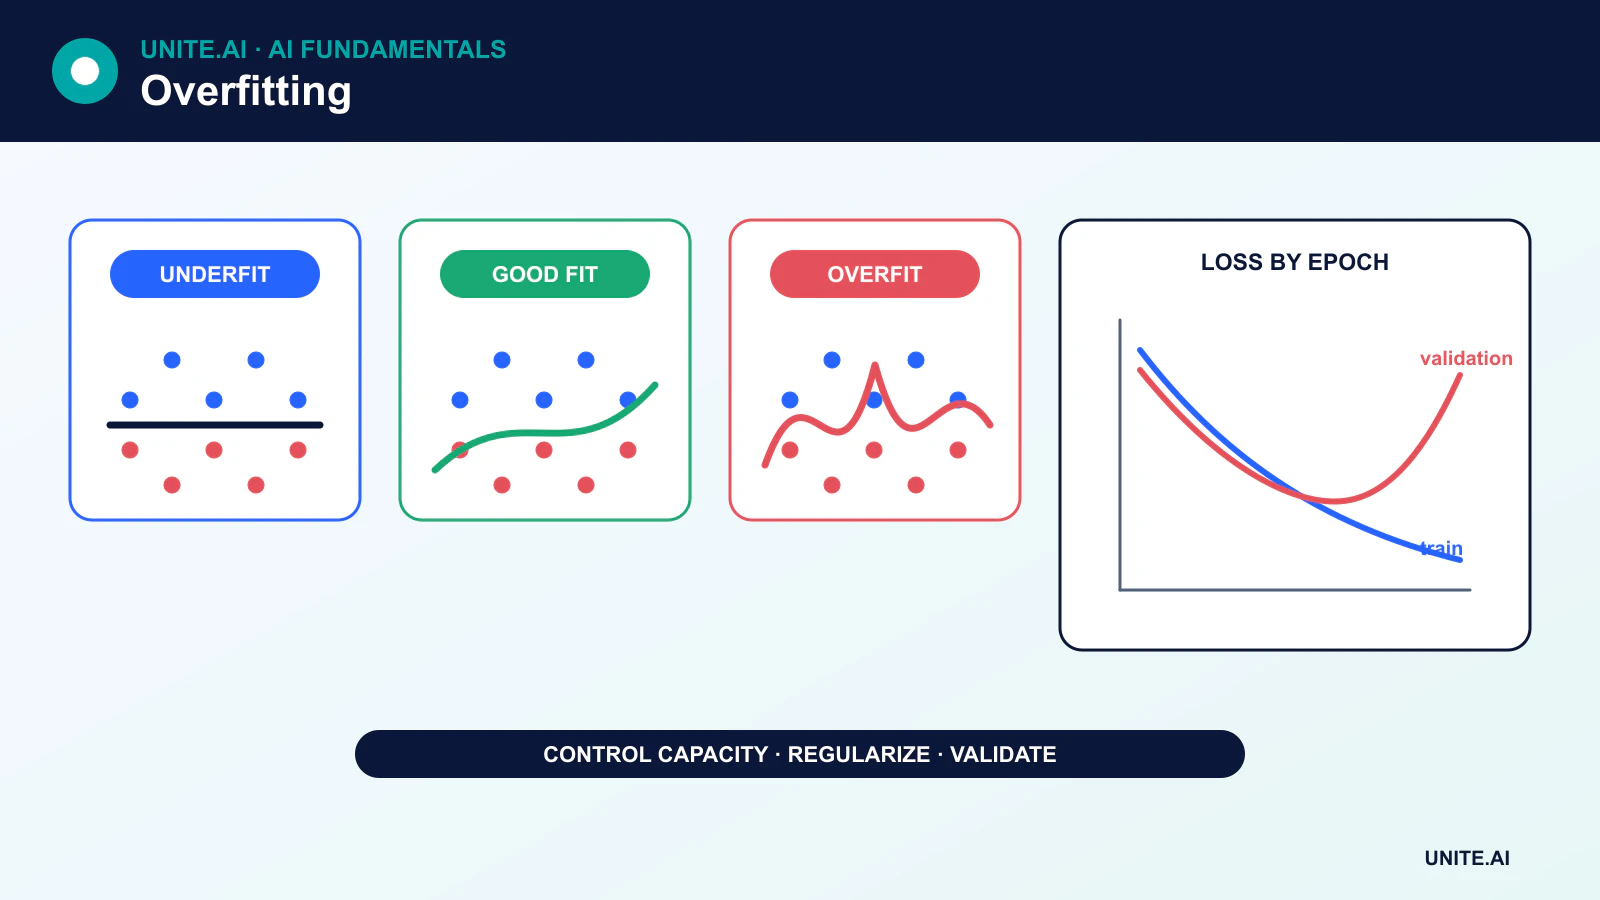
Adattamento, underfitting e overfitting
Un modello è underfittato quando le sue ipotesi sono troppo restrittive, le sue caratteristiche omettono segnali importanti, l’ottimizzazione è inadeguata o l’addestramento è insufficiente. Aggiungere caratteristiche rilevanti o capacità può aiutare, ma aggiungere semplicemente caratteristiche arbitrarie può aumentare rumore e overfitting.
Un modello è overfittato quando la sua capacità efficace è troppo alta rispetto alle informazioni presenti nei dati di addestramento. Esempi includono un albero decisionale decision tree profondo che crea foglie molto piccole, un polinomio che segue fluttuazioni casuali, o una rete neurale che memorizza gli esempi.
Il ruolo di dati di training, validazione e test
- Dati di training adattano i parametri del modello.
- Dati di validazione selezionano l’architettura, gli iperparametri, le soglie e il momento di arresto.
- Dati di test forniscono una stima finale dopo che tali scelte sono state completate.
Se il set di test guida ripetutamente le decisioni, diventa parte del processo di sviluppo e non fornisce più una stima finale imparziale. La cross‑validation può sfruttare più efficientemente i dati limitati, ma tutta la pre‑elaborazione e la selezione delle caratteristiche devono avvenire all’interno di ogni fold di training.
Early stopping
Durante l’addestramento, la perdita di training di solito continua a diminuire. La perdita di validazione può diminuire inizialmente e poi aumentare quando il modello si specializza sul rumore del training. L’early stopping salva il checkpoint con il miglior obiettivo di validazione o si interrompe dopo che la validazione non è migliorata per un periodo di pazienza definito.
Il checkpoint corretto non è quello con la perdita di training più bassa. Un set di test finale separato viene valutato dopo che le decisioni di early stopping e di tuning sono state completate.
Regularization methods
Weight penalties
La regolarizzazione L2 o il weight decay scoraggiano valori di parametro elevati. La regolarizzazione L1 può favorire coefficienti sparsi. I loro effetti dipendono dal modello e dall’ottimizzatore; AdamW, ad esempio, separa il weight decay dall’aggiornamento adattivo.
Dropout and stochastic regularization
Il dropout maschera casualmente le attivazioni durante il training. Altri metodi eliminano percorsi, perturbano le caratteristiche o smussano le etichette. Queste tecniche modificano l’obiettivo di training e devono essere disattivate o gestite in modo appropriato durante l’inferenza.
Data augmentation
L’augmentazione crea variazioni realistiche — come ritagli, rotazioni, rumore o parafrasi — che dovrebbero preservare il target. Trasformazioni non valide possono modificare l’etichetta e danneggiare il modello. Per la visione, strumenti come Albumentations aiutano a implementare pipeline controllate.
Capacity control
Alberi più poco profondi, meno parametri, selezione delle caratteristiche, potatura e classi ipotetiche più semplici possono ridurre la varianza. La potatura degli alberi è guidata da criteri, non da una rimozione casuale dei dettagli appresi.
Data leakage can look like exceptional performance
Il leakage si verifica quando informazioni non disponibili al momento della previsione entrano nel training o nella valutazione. Esempi comuni includono la normalizzazione basata sull’intero dataset, la suddivisione di record ripetuti tra i fold, l’uso di dati futuri per prevedere il passato, o l’inclusione di una caratteristica derivata dal target.
Il leakage non è un semplice overfitting, ma crea lo stesso divario fuorviante tra i risultati offline e la messa in produzione. La strategia di suddivisione dovrebbe rispettare tempo, identità, posizione e i processi di generazione dei dati.
Distribution shift is a separate problem
Un modello può generalizzare alla sua distribuzione di test e comunque fallire quando i dati di produzione cambiano. Nuovi dispositivi, politiche, popolazioni, stagioni o comportamenti avversari possono modificare la relazione tra input e target. Il monitoraggio e la rivalutazione periodica sono necessari anche quando il modello originale non era overfittato.
Diagnosing overfitting
Utilizzare curve di apprendimento, varianza della cross‑validation, metriche di sottogruppi, calibrazione e ispezione degli errori. Se sia le prestazioni di training sia quelle di validazione sono scarse, concentrarsi su underfitting, caratteristiche, etichette o ottimizzazione. Se il training è forte e la validazione è debole, investigare capacità, leakage, regolarizzazione e rappresentatività prima di raccogliere semplicemente più dati.
Why overfitting happens and how to detect it
L’overfitting si verifica quando un modello apprende pattern che riducono l’errore di training ma non generalizzano alla popolazione target. Le cause includono capacità eccessiva rispetto ai dati effettivi, rumore nelle etichette, entità ripetute, selezione flessibile delle caratteristiche, leakage e ottimizzazione contro lo stesso set di validazione. Un divario crescente tra le prestazioni di training e di validazione è una prova comune, ma un divario ridotto non esclude l’overfitting se entrambi i set condividono contaminazioni o differiscono dalla produzione. Le curve di apprendimento in funzione del volume dei dati e della capacità aiutano a distinguere varianza da bias.
Il leakage è particolarmente ingannevole: informazioni future, duplicati, sovrapposizione di soggetti, pre‑elaborazione adattata a tutti i dati o etichette codificate nei metadati possono produrre ottimi punteggi su dati di hold‑out. Suddividere per l’unità che sarà nuova al momento della messa in produzione — paziente, cliente, macchina, posizione o tempo — prima di adattare trasformazioni o augmentazioni. Mantenere un set di test finale sigillato mentre si scelgono caratteristiche, architettura e soglie. Se i team ispezionano ripetutamente i risultati del test, il set di test diventa un altro set di validazione e necessita di sostituzione o correzione formale.
Regularization, model selection, and production drift
Ridurre l’overfitting con dati più rappresentativi, capacità ridotta, weight decay, dropout, early stopping, augmentazione, ensemble o vincoli che riflettano la struttura del dominio. Ogni metodo ha compromessi: l’augmentazione può distorcere le etichette, il dropout modifica l’ottimizzazione e gli ensemble aumentano i costi di servizio. La cross‑validation stima la variabilità della selezione, ma i fold raggruppati o sensibili al tempo devono preservare il confine di produzione. Confrontare con un modello semplice e riportare l’incertezza tra i fold o i seed invece di selezionare l’esecuzione più favorevole.
La produzione può rivelare una forma diversa di fallimento della generalizzazione quando cambiano input, utenti, incentivi o misurazioni. Monitorare le distribuzioni delle caratteristiche e delle previsioni, la calibrazione, i risultati dei sottogruppi e la verità a terra ritardata. Non riaddestrare automaticamente su feedback non revisionati; le decisioni del modello possono influenzare le etichette che successivamente vede. Diagnosticare se il fallimento deriva da drift, pipeline di dati, cambiamenti di policy o un target non valido. L’overfitting è controllato dal design sperimentale e dalla disciplina del ciclo di vita, non da una singola impostazione di regolarizzazione.
Worked example: eliminating leakage in a fraud model
Un classificatore di frode iniziale ottiene punteggi estremamente alti perché eventi ripetuti di carte e commercianti compaiono in righe di training e test casuali, e le informazioni di chargeback registrate settimane dopo sono incluse come caratteristica. Il team ricostruisce il tempo di disponibilità di ogni caratteristica, rimuove i campi post‑decisione, raggruppa per conto e utilizza una suddivisione temporale in avanti. Le prestazioni calano bruscamente ma ora stimano la decisione reale. Una baseline di regole semplici e le curve di apprendimento guidano la complessità del modello necessaria.
La regolarizzazione e l’early stopping sono sintonizzati solo all’interno dei fold storici. La valutazione finale riporta precisione alla capacità di revisione, recall, calibrazione e costo per tipo di frode e segmento di cliente. In produzione, le etichette confermate arrivano in ritardo e sono influenzate da quali transazioni sono state revisionate, così il monitoraggio separa il drift del punteggio dalle stime dei risultati. Il riaddestramento utilizza casi giudicati e replay rispetto alla policy corrente. Il progetto preferisce un punteggio onesto più basso a uno alto ma trapelato che non può sopravvivere al deployment.
Implementation evidence and operational readiness
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima del tuning. Testare casi ordinari, condizioni di confine, input malformati o mancanti, shift di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a fasi, preservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi esaminare le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, policy, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disattivato o sostituito.
Frequently asked questions
Can a simple model overfit?
Sì. La selezione ripetuta di caratteristiche, la sintonizzazione delle soglie o la valutazione sullo stesso holdout possono overfittare il processo di sviluppo anche quando il modello finale è semplice.
Does more training data always solve overfitting?
No. Più dati rappresentativi e correttamente etichettati possono aiutare, ma dati duplicati, di parte, trapelati o fuori dominio potrebbero non farlo. L’obiettivo di apprendimento e il design della valutazione rimangono importanti.
Primary references