Fondamenti di IA
Cosa sono le RNN e le LSTM nel Deep Learning?

 Aggiungi Unite.AI alle tue fonti preferite su Google
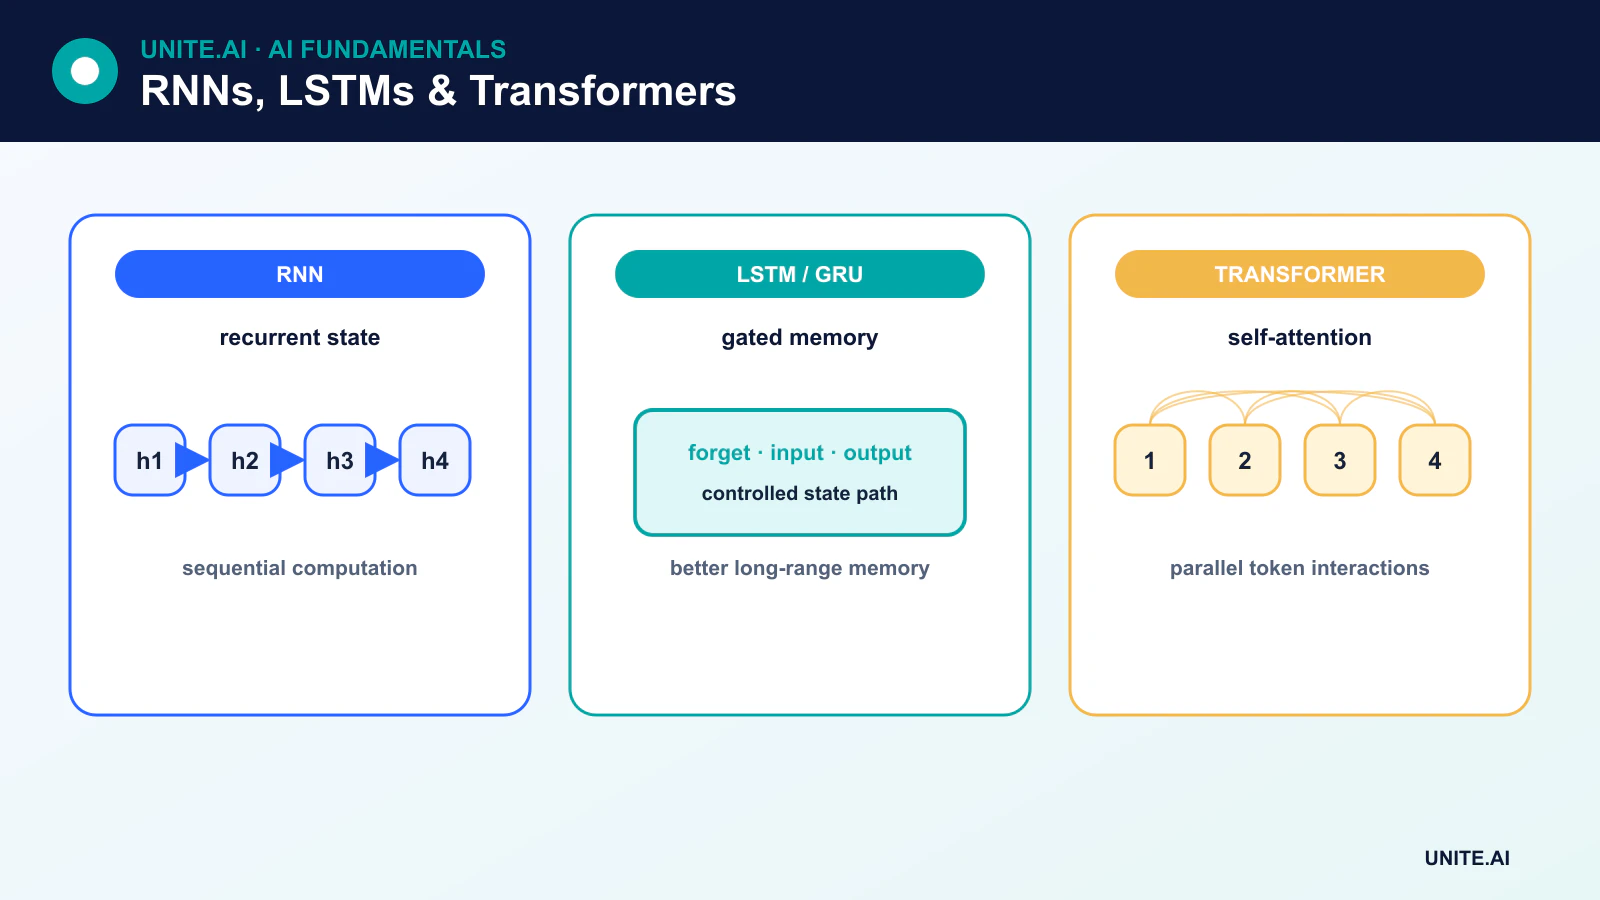
Reti neurali ricorrenti (RNN) elaborano sequenze aggiornando uno stato nascosto nel tempo. Long short-term memory (LSTM) sono RNN con porte progettate per preservare e controllare le informazioni in modo più efficace rispetto a un’unità ricorrente di base.
Le RNN e le LSTM hanno un tempo dominato molti compiti linguistici, ma i moderni grandi chatbot si basano principalmente sui transformer. I modelli ricorrenti rimangono utili per lo streaming, le serie temporali, il parlato, il controllo e i sistemi con risorse limitate, dove lo stato incrementale e la bassa latenza sono importanti.
Punti chiave
- Una RNN riutilizza gli stessi parametri a ogni passo della sequenza e trasporta uno stato nascosto in avanti.
- L’addestramento nel tempo può generare gradienti che svaniscono o esplodono.
- Una LSTM aggiunge uno stato di cella e porte di ingresso, dimenticanza e uscita.
- I transformer gestiscono le relazioni a lungo raggio e l’addestramento parallelo in modo diverso; nessuna delle due architetture è la migliore per ogni implementazione.
Come funziona una RNN di base
Al passo t, un’unità ricorrente semplice combina l’input corrente xₜ con lo stato nascosto precedente hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Lo stato nascosto è un riepilogo appreso utilizzato per il passo successivo e, a seconda del compito, come output. Un diagramma “srotolato” disegna una copia per ogni passo temporale, ma tutte le copie condividono i parametri. L’output non è semplicemente copiato indietro come nuovo input grezzo; la ricorrenza trasmette lo stato nascosto attraverso una trasformazione definita.
Backpropagation nel tempo
Le RNN vengono addestrate con backpropagation nel tempo (BPTT). La sequenza srotolata forma un grafo computazionale profondo, e backpropagation calcola come la perdita dipenda dai parametri ricorrenti condivisi.
La moltiplicazione ripetuta può far ridurre i gradienti verso zero o farli crescere senza limiti. I gradienti che svaniscono impediscono l’apprendimento di dipendenze lunghe; i gradienti che esplodono generano aggiornamenti instabili. Il clipping dei gradienti affronta i gradienti esplosivi, mentre le porte, l’inizializzazione, la normalizzazione e finestre di addestramento più brevi possono aiutare.
All’interno di una cella LSTM
Una LSTM mantiene un cell state cₜ in aggiunta allo stato nascosto hₜ. Le sue porte sono controlli appresi, dipendenti dai dati:
- La porta di dimenticanza controlla quanto dello stato di cella precedente viene conservato.
- La porta di ingresso controlla quanta informazione candidata viene scritta.
- La porta di uscita controlla quanta informazione della cella contribuisce allo stato nascosto.
Le uscite sigmoid tra zero e uno fungono da porte morbide, mentre un candidato trasformato tramite tanh fornisce nuovo contenuto. Il percorso additivo dello stato di cella aiuta i gradienti a persistere, ma le LSTM non garantiscono una memoria illimitata né eliminano tutti i problemi di ottimizzazione.
GRU e ricorrenza bidirezionale
Un’unità ricorrente con porte (GRU) combina i meccanismi di gating in una cella ricorrente più semplice, senza uno stato di cella separato in stile LSTM. Le GRU possono addestrarsi più velocemente e ottenere prestazioni simili in alcuni compiti.
Una RNN bidirezionale elabora una sequenza completa in entrambe le direzioni e combina gli stati. Può utilizzare il contesto futuro per il tagging o la codifica, ma è inappropriata per lo streaming causale quando gli input futuri non sono ancora disponibili.
Modelli sequence-to-sequence
Le RNN encoder-decoder mappano una sequenza in un’altra. L’attenzione è stata introdotta per permettere a un decoder di consultare diversi stati dell’encoder invece di basarsi su un unico vettore fisso. Questa linea di ricerca ha portato all’architettura transformer, che ha sostituito la ricorrenza con blocchi basati sull’attenzione.
RNN vs transformer
I transformer elaborano le posizioni di addestramento in parallelo e creano percorsi di attenzione brevi tra token distanti. Le RNN elaborano lo stato in modo sequenziale, limitando il parallelismo ma offrendo uno stato ricorrente di dimensione costante durante lo streaming. L’inferenza dei transformer può richiedere una cache chiave-valore in crescita, mentre una RNN comprime la storia nel suo stato nascosto e può perdere dettagli.
Scegli in base alla lunghezza della sequenza, alla scala dei dati, all’hardware, alla latenza, alla memoria e al fatto se il compito è offline o in streaming. Le architetture ibride e a spazio di stato offrono ulteriori compromessi.
Casi d’uso attuali
Le RNN e le LSTM rimangono rilevanti per la previsione, il rilevamento di anomalie, l’elaborazione di sensori, i componenti vocali, la scrittura a mano, il controllo embedded e la modellazione di sequenze a bassa latenza. Non sono la spiegazione predefinita per gli attuali grandi modelli linguistici o i chatbot AI.
Ricorrenza, porte e memoria di sequenza
Una rete neurale ricorrente elabora una sequenza combinando l’input corrente con uno stato nascosto trasportato dai passi precedenti. I pesi condivisi consentono lunghezze di sequenza variabili, e lo srotolamento espone il calcolo nel tempo per l’addestramento. Le RNN di base possono rappresentare dipendenze temporali ma i gradienti moltiplicati ripetutamente su sequenze lunghe tendono a svanire o esplodere. La backpropagation troncata limita memoria e calcolo, mentre il clipping dei gradienti controlla aggiornamenti estremi. Lo stato nascosto è un riepilogo appreso, non una memorizzazione fedele di ogni token precedente.
Le reti Long short-term memory aggiungono uno stato di cella e porte di ingresso, dimenticanza e uscita che regolano scrittura, conservazione ed esposizione delle informazioni. Le unità ricorrenti con porte usano una struttura più semplice di reset e aggiornamento. Le varianti bidirezionali usano il contesto futuro e quindi non possono streammare causalmente senza ritardo. Modelli ricorrenti impilati, residual e potenziati dall’attenzione aumentano la capacità. Padding e maschere devono impedire che elementi di sequenza artificiali influenzino lo stato o la perdita, e lo stato dovrebbe essere resettato ai veri confini di sequenza per evitare perdite tra esempi.
Addestramento, confronto e servizio stateful
Le RNN e le LSTM rimangono utili per lo streaming, modelli compatti on-device, serie temporali e carichi di lavoro dove lo stato sequenziale è efficiente. I transformer parallelizzano l’addestramento e modellano le interazioni a lungo raggio in modo diverso ma possono richiedere più memoria e cache. Confronta le architetture su accuratezza, latenza, throughput, memoria, consumo energetico e prestazioni al variare della lunghezza della sequenza. Valuta la previsione con split temporali scorrevoli, il linguaggio con metriche sensibili alla sequenza e il rilevamento di anomalie con misure a livello di evento. Ispeziona i fallimenti dopo lunghi intervalli, cambi di regime, campioni mancanti e confini di sequenza bruschi.
Il deployment stateful deve associare lo stato nascosto alla sessione corretta, farlo scadere, crittografarlo se sensibile e resettarlo dopo errori o cambi di modello. Eventi fuori ordine o duplicati possono corrompere lo stato; includi timestamp, numeri di sequenza e idempotenza. Monitora età dello stato, lunghezza della sequenza, dati mancanti, drift dell’output e latenza. La quantizzazione richiede una validazione sensibile alle porte perché piccole variazioni numeriche possono accumularsi nel tempo. La memoria delle RNN consente il contesto, ma può anche conservare informazioni private o obsolete, quindi la conservazione e i controlli utente devono far parte del design.
Esempio pratico: una LSTM per sequenze di sensori in streaming
Un’utilità usa una LSTM per prevedere il carico a breve termine a partire da misurazioni recenti, calendario e condizioni meteo. Le sequenze sono costruite con ordine temporale rigoroso; lo stato nascosto si resetta ai confini dei feeder e il padding è mascherato. Baseline stagionali naive e gradient-boosted sono confrontate con la LSTM su finestre scorrevoli. I test coprono intervalli mancanti, meteo ritardato, festività, interruzioni e lunghezze di sequenza oltre l’addestramento tipico.
Il servizio di streaming associa lo stato a un feeder, rifiuta duplicati fuori ordine e fa scadere lo stato dopo lunghi intervalli o aggiornamenti del modello. Una previsione statistica sicura sostituisce l’output quando i sensori o lo stato sono invalidi. L’inferenza quantizzata è verificata su sequenze lunghe per drift accumulato. Il monitoraggio traccia età dello stato, dati mancanti, latenza, bias e errore di intervallo. Il modello è riaddestrato solo dopo cambiamenti della rete e i risultati revisionati mostrano che le relazioni temporali apprese non generalizzano più.
Evidenza di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni al limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenza, uso improprio e i gruppi o ambienti più probabilmente sottoserviti. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere evidenza da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile di risposta, poi rivedi le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che le fonti dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e un chiaro punto in cui dovrebbe essere disattivato o sostituito.
Domande frequenti
Una LSTM è sempre migliore di una RNN di base?
No. Le porte aiutano molti problemi di dipendenze lunghe ma aggiungono calcolo e parametri. Una RNN di base può essere adeguata per sequenze brevi e semplici, e un’altra architettura può essere migliore per contesti molto lunghi.
Una LSTM può elaborare una cronologia illimitata?
No. Il suo stato ha una capacità finita, i gradienti e i dati di addestramento impongono limiti, e i dettagli rilevanti possono essere sovrascritti. Le prestazioni su contesti lunghi devono essere misurate piuttosto che inferite dal nome dell’architettura.
Riferimenti principali