Fondamenti di IA
Cosa sono le reti neurali?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Una rete neurale artificiale è un modello matematico parametrizzato composto da strati di operazioni connesse. Durante l’addestramento, la rete regola i suoi parametri in modo che gli input vengano mappati a output utili. Le reti neurali possono approssimare relazioni non lineari complesse e apprendere rappresentazioni direttamente da testo, immagini, audio, serie temporali e altri dati.
Il nome è storicamente ispirato ai neuroni biologici, ma le reti moderne sono sistemi ingegneristici piuttosto che simulazioni realistiche del cervello. Termini come “neurone” e “apprendimento” sono abbreviazioni utili e non devono essere confusi con prove di cognizione simile a quella umana.
Punti chiave
- Un neurone calcola una somma pesata, aggiunge un bias addestrabile e applica una funzione di attivazione.
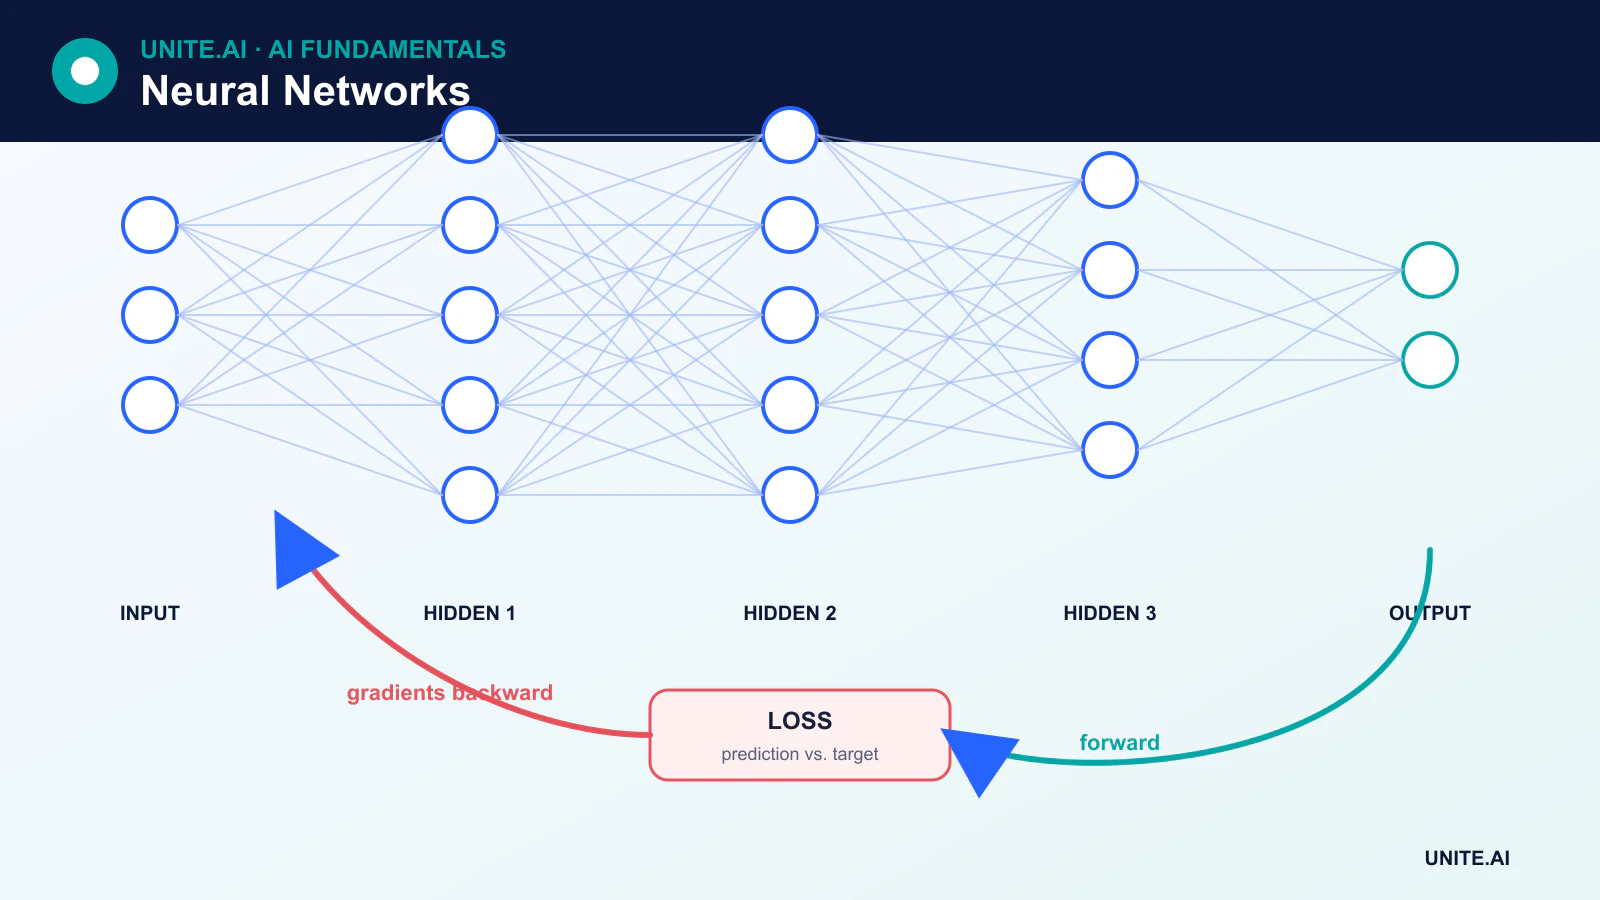
- Un passaggio in avanti genera previsioni; una funzione di perdita misura l’errore; la retropropagazione calcola i gradienti; un ottimizzatore aggiorna i parametri.
- MLP, CNN, RNN e transformer organizzano le connessioni in modo diverso.
- Più strati o parametri non producono automaticamente un modello migliore o più affidabile.
Da un singolo neurone artificiale a una rete
Per un vettore di input x, un’unità di base calcola:
z = Wx + boutput = activation(z)
W contiene pesi addestrabili e b è un bias addestrabile. La funzione di attivazione introduce non linearità. I pesi non “passano attraverso” l’attivazione da soli; l’attivazione viene applicata alla somma pesata e al bias.
Un perceptron multilayer (MLP) impila strati densi. Lo strato di input rappresenta le caratteristiche, gli strati nascosti le trasformano e lo strato di output è progettato per il compito — ad esempio, logit di classe o un valore di regressione.
Come le reti neurali apprendono
- Il modello inizializza i parametri addestrabili.
- Un passaggio in avanti elabora un batch e produce previsioni.
- Una funzione di perdita confronta le previsioni con l’obiettivo di addestramento.
- Retropropagazione utilizza la regola della catena per calcolare i gradienti.
- Un ottimizzatore, come lo stochastic gradient descent o AdamW, aggiorna pesi e bias.
La retropropagazione è diventata centrale per l’addestramento delle reti neurali grazie a lavori sviluppati e diffusi nel corso di diversi decenni; non è stata creata per la prima volta nell’era recente del deep learning. I framework moderni implementano la differenziazione automatica in modalità reverse, così i professionisti non devono derivare manualmente ogni gradiente.
Perché le funzioni di attivazione sono importanti
Senza attivazioni non lineari, più strati lineari ordinari si riducono a una singola trasformazione lineare. ReLU è ampiamente usato perché è semplice ed efficiente. GELU e SiLU sono comuni nelle architetture moderne. Sigmoid e softmax rimangono utili per particolari interpretazioni dell’output, ma sigmoid può saturare negli strati nascosti e contribuire al problema del gradiente che svanisce.
Principali architetture di reti neurali
Reti neurali convoluzionali
CNN applicano filtri appresi su quartieri locali e condividono i parametri tra le posizioni. Queste proprietà le rendono efficienti per immagini e altri segnali a griglia.
Reti ricorrenti
RNN, LSTM e GRU aggiornano uno stato nascosto lungo una sequenza. Rimangono utili per compiti di streaming e serie temporali, sebbene la ricorrenza limiti l’elaborazione parallela e possa faticare con dipendenze lunghe.
Transformer
Transformer usano l’attenzione per creare rappresentazioni dipendenti dal contesto. Connessioni residuali, normalizzazione, informazioni di posizione e blocchi feed‑forward sono parti fondamentali dell’architettura. I Transformer ora costituiscono la base di molti grandi modelli linguistici e multimodali.
Autoencoder e reti generative
Autoencoder apprende rappresentazioni tramite ricostruzione. GAN, modelli di diffusione e reti autoregressive generano nuovi campioni usando obiettivi e procedure di addestramento differenti.
Componenti che rendono le reti profonde addestrabili
I sistemi moderni usano più di strati e attivazioni. Le connessioni residuali consentono a informazioni e gradienti di aggirare i blocchi. La normalizzazione stabilizza le attivazioni. La regolarizzazione, l’augmentazione dei dati, il dropout e il decadimento dei pesi possono ridurre l’overfitting. Gli strati di embedding mappano elementi discreti come token in vettori. L’attenzione permette a una rappresentazione di dipendere dinamicamente da altri elementi.
Punti di forza e limitazioni
Le reti neurali possono apprendere caratteristiche da dati grezzi ad alta dimensionalità e scalare con la quantità di dati e di calcolo. Possono anche richiedere grandi set di dati, hardware specializzato e una messa a punto accurata. Le loro previsioni possono essere poco calibrate, fragili sotto cambiamenti di distribuzione, vulnerabili a manipolazioni avversarie o difficili da spiegare.
L’architettura dovrebbe seguire il compito e i vincoli di deployment. Per molti problemi tabulari, un ensemble di alberi o un modello lineare può essere più veloce e più facile da validare. Per applicazioni ad alto rischio, le prestazioni del modello devono essere valutate per sottogruppo e modalità di errore, non solo tramite un benchmark aggregato.
Strati, attivazioni e flusso di informazione
Una rete neurale compone funzioni parametrizzate. Ogni unità forma una combinazione pesata degli input, aggiunge un bias e passa il risultato attraverso un’attivazione come ReLU, sigmoid, tanh o GELU. Impilare gli strati consente caratteristiche gerarchiche e confini decisionali non lineari. La larghezza controlla il numero di unità per strato; la profondità controlla le trasformazioni successive; la connettività e la condivisione dei pesi definiscono l’architettura. L’output della rete dipende da preprocessing, parametri, normalizzazione e modalità di inferenza insieme. Un neurone è un’operazione matematica, non un vero neurone biologico o un concetto indipendente di significato.
La propagazione in avanti calcola le previsioni; una perdita quantifica l’errore; la retropropagazione applica la regola della catena ai gradienti; un ottimizzatore aggiorna i parametri. Inizializzazione, tasso di apprendimento, statistiche del batch, percorsi residuali e normalizzazione influenzano se i gradienti svaniscono, esplodono o rimangono utili. La regolarizzazione comprende decadimento dei pesi, dropout, augmentazione, early stopping e vincoli architetturali. Tracciare il comportamento di addestramento e validazione, ispezionare le statistiche di gradienti e attivazioni, e confrontare esecuzioni ripetute. Una rete grande può memorizzare i dati di addestramento, mentre una piccola può sotto‑adattarsi o perdere strutture necessarie.
Selezione dell’architettura, valutazione e deployment
I perceptron multilayer elaborano vettori fissi; le reti convoluzionali sfruttano la struttura locale; i modelli ricorrenti e a spazio di stato elaborano sequenze; i transformer usano l’attenzione; le reti a grafo scambiano informazioni lungo gli archi. Gli ibridi sono comuni. Scegliere in base al bias induttivo, ai dati, alla dimensione della sequenza o dell’immagine, alla latenza, alla memoria, all’interpretabilità e all’hardware disponibile. Valutare rispetto a un baseline lineare o ad albero ed eseguire ablazioni per capire quale complessità è rilevante. Il solo conteggio dei parametri non prevede qualità, costo di inferenza o requisiti di dati.
Il servizio richiede preprocessing congelato, un grafo esportato o compilato, validazione numerica e test di risorse sotto carico realistico. Quantizzazione e pruning possono ridurre le dimensioni ma potrebbero alterare il comportamento delle classi rare. Monitorare input, output, calibrazione, latenza e risultati confermati; testare dati avversari e spostati. Proteggere modelli, dipendenze e dati tramite artefatti firmati, controllo degli accessi e revisione della catena di fornitura. Le spiegazioni da attivazioni individuali o saliency richiedono verifica causale e comportamentale. Le reti neurali sono approssimatori di funzioni flessibili, non garanzie di comprensione, verità o robustezza.
Esempio pratico: un forecast di domanda neurale
Un rivenditore prevede la domanda settimanale di un articolo a partire da vendite, promozioni, prezzo, festività, disponibilità e condizioni meteo. La rete viene confrontata con baseline stagionali naive, lineari e ad albero usando divisioni temporali scorrevoli. Le promozioni future sono incluse solo quando realmente note al momento della previsione, mentre le rotture di stock sono modellate perché le vendite osservate possono sottostimare la domanda. La valutazione utilizza errore assoluto ponderato, bias, copertura dell’intervallo e risultati per velocità dell’articolo e negozio.
Il pipeline di servizio versiona la disponibilità, il modello e l’orizzonte e rifiuta una previsione quando gli input richiesti sono obsoleti. I pianificatori vedono gli intervalli e possono sovrascrivere con motivi registrati. Il monitoraggio rileva feed mancanti, variazioni di errore, bias e previsioni anomale; i risultati di business sono separati dall’accuratezza della previsione perché la politica di ordine influisce anche sull’inventario. Un aggiornamento del modello è ombreggiato attraverso diversi cicli, e il forecast precedente rimane disponibile per rollback durante interruzioni stagionali o del fornitore.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni al contorno, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a tappe, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato di salute delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi esaminare le prove nel mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto richiede anche procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
Ogni rete neurale è deep learning?
No. Una piccola rete con un solo strato nascosto è una rete neurale, mentre il deep learning si riferisce generalmente a architetture con più fasi di elaborazione apprese. Il confine è convenzionale piuttosto che una soglia scientifica rigorosa.
Le reti neurali memorizzano i loro dati di addestramento?
Conservano i parametri appresi, non una copia ricercabile ordinaria del set di dati. Tuttavia, i modelli di grandi dimensioni possono memorizzare e riprodurre esempi di addestramento individuali, creando rischi di privacy e di copyright che devono essere verificati.
Riferimenti principali