
Fondamenti di IA
Cos’è la Data Science?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Data science è la pratica di trasformare i dati in conoscenza difendibile, previsioni o decisioni. Combina competenze di dominio, statistica, informatica, ingegneria dei dati, visualizzazione e comunicazione. Un modello può far parte del lavoro, ma la disciplina inizia prima della modellazione e continua dopo il deployment.
La domanda più importante non è “Quale algoritmo dovremmo usare?”. È “Quale decisione stiamo supportando, quale evidenza la risponderebbe, e come sapremo se il risultato rimane utile?”
Key takeaways
- Data science è un flusso di lavoro di evidenza end-to-end, non un sinonimo di machine learning.
- La definizione del problema, la misurazione e la governance dei dati spesso determinano il successo più della complessità del modello.
- Le domande predittive e causali richiedono assunzioni e progetti di valutazione differenti.
- Un’analisi distribuita richiede monitoraggio, documentazione e comunicazione adeguati ai suoi utenti.
Start with a decision and an estimand
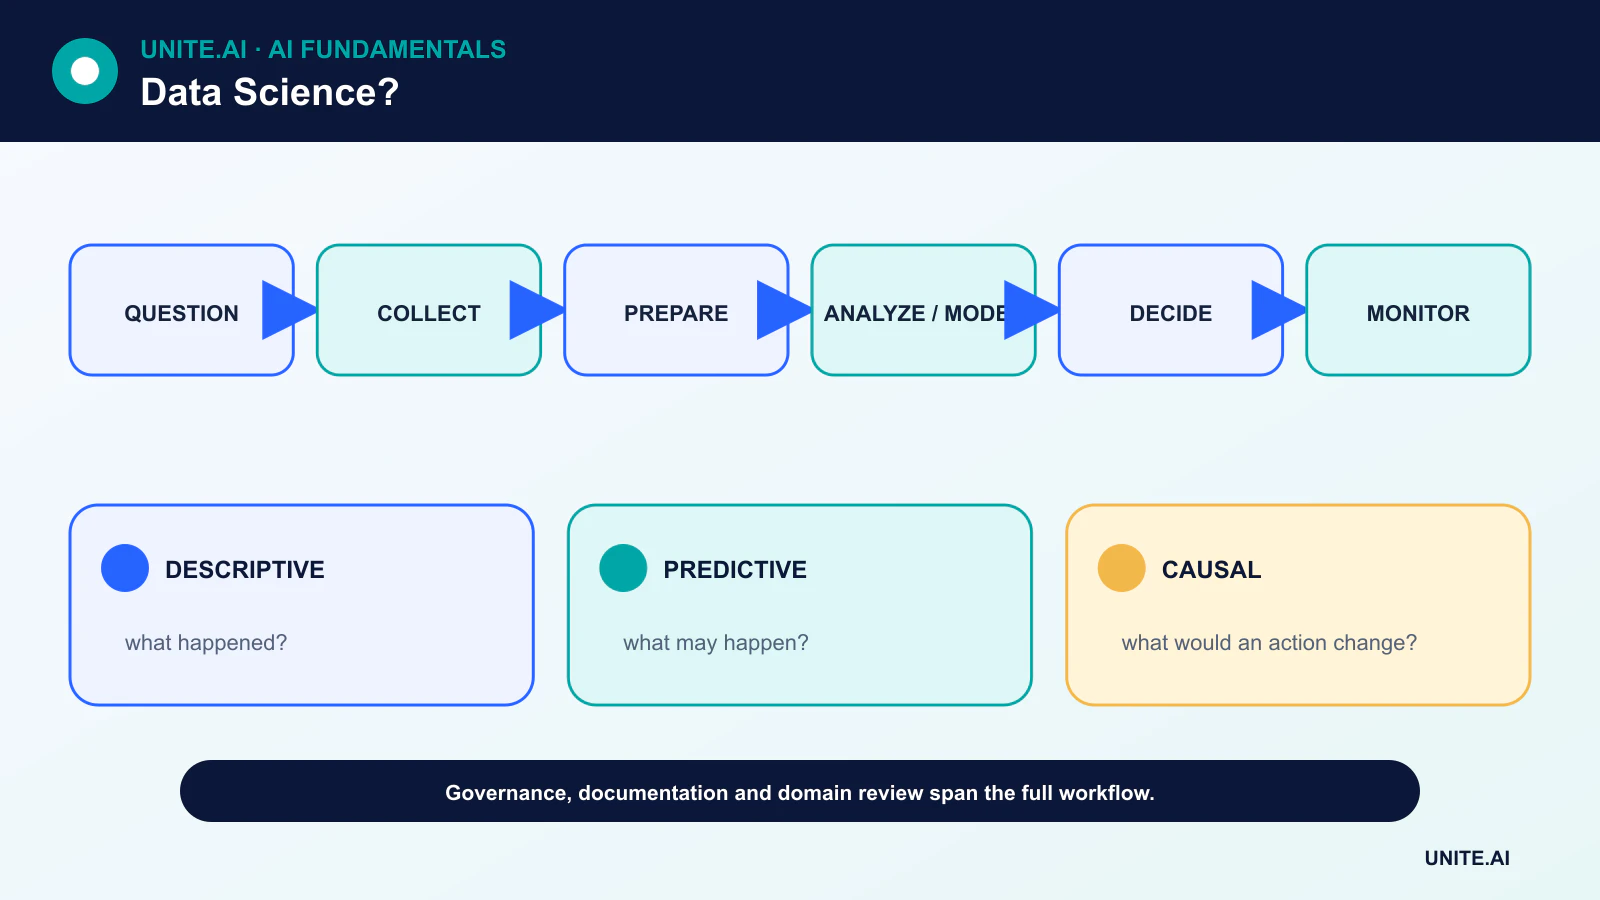
Un progetto dovrebbe identificare l’utente, la decisione, l’intervento e il costo dell’errore. Per una domanda descrittiva, l’obiettivo può essere una percentuale o una tendenza. Per la previsione, può essere la domanda futura o il rischio. Per una domanda causale, l’estimand descrive l’effetto di un intervento definito sotto le assunzioni dichiarate.
Obiettivi vaghi come “trovare insight” rendono impossibile la valutazione. Un obiettivo misurabile crea un confine per la raccolta dei dati e impedisce all’analisi di espandersi in tutti i campi disponibili.
Collect, govern and understand data
I team inventariare le fonti, la proprietà, il consenso, la conservazione, la provenienza e l’accesso. Distinguono i dati strutturati e non strutturati, definiscono unità e timestamp, e verificano se i record rappresentano la popolazione e il periodo di tempo di interesse.
La pulizia non consiste solo nell’eliminare le righe mancanti. Include la risoluzione di duplicati, valori impossibili, ambiguità di etichette, deriva dello schema, censura e join che cambiano l’unità di analisi. Ogni trasformazione dovrebbe essere riproducibile e documentata.
Explore before modeling
L’analisi esplorativa studia le distribuzioni, le mancanze, le relazioni e i potenziali artefatti di misurazione. La visualizzazione può rivelare outlier e differenze di sottogruppo che una media riassuntiva nasconde. L’esplorazione dovrebbe informare le ipotesi senza essere scambiata per evidenza confermatoria.
L’ingegneria delle caratteristiche, la riduzione della dimensionalità e l’apprendimento di rappresentazione possono migliorare la modellazione, ma le trasformazioni devono essere adattate solo sui dati di training per evitare leakage.
Choose methods for the question
La stima statistica quantifica l’incertezza attorno alle quantità di interesse. Il machine learning è utile quando l’obiettivo principale è la performance predittiva su nuovi dati. Esperimenti e metodi di inferenza causale sono necessari quando l’obiettivo è l’effetto di un intervento.
Una baseline dovrebbe essere sufficientemente semplice da comprendere. Modelli più complessi devono giustificare il loro costo aggiuntivo attraverso una migliore performance su dati di test, incertezza calibrata, valore operativo o una capacità necessaria come l’elaborazione di immagini o linguaggio.
Evaluate, communicate and monitor
La valutazione dovrebbe corrispondere alla decisione. Un classificatore può richiedere precisione, recall, calibrazione e analisi di sottogruppi anziché solo accuratezza; un sistema di previsione necessita di backtesting sensibile al tempo. L’overfitting e il leakage sono fallimenti di processo, non solo proprietà del modello.
La comunicazione include assunzioni, incertezza, limitazioni e azioni consigliate. Una volta che un modello o dashboard è utilizzato, i team monitorano la qualità degli input, il drift dei risultati, il comportamento degli utenti e l’impatto a valle. Un processo decisionale ritirato necessita di un archivio e di una chiara proprietà così come uno distribuito richiede un operatore.
The data-science lifecycle and analytical questions
Data science combina conoscenza di dominio, statistica, informatica e comunicazione per trasformare i dati in evidenza per le decisioni. Inizia distinguendo descrizione, diagnosi, previsione e inferenza causale. Un dashboard che riporta cosa è accaduto, un modello che prevede chi abbandonerà, e un esperimento che stima se un intervento modifica l’abbandono rispondono a domande diverse. Definisci unità, popolazione, finestra temporale, risultato, azione e costo degli errori prima di estrarre i dati. Molti progetti falliti risolvono un proxy misurabile che non può supportare la decisione prevista.
L’acquisizione richiede provenienza, permessi, disegno del campionamento e un contratto dati. L’esplorazione verifica distribuzioni, mancanze, duplicati, outlier, relazioni, cambiamenti di misurazione e potenziali leakage. Le scelte di pulizia sono assunzioni analitiche: eliminare righe mancanti, imputare valori o limitare outlier può cambiare popolazione e conclusione. Versiona i dati grezzi in modo immutabile e le trasformazioni come codice, e crea un dizionario dati con unità e significato. Suddividi i dati di valutazione prima di apprendere le trasformazioni o testare ripetutamente le ipotesi.
Modeling, inference, and reproducibility
L’inferenza statistica quantifica l’incertezza sotto assunzioni; la modellazione predittiva stima la performance fuori campione; l’analisi causale richiede identificazione tramite design o assunzioni difendibili. Seleziona metodi che corrispondono alla domanda e al processo generatore di dati. Confronta con baseline semplici, usa validazione raggruppata o sensibile al tempo, e riporta incertezza e sensibilità. Un’alta correlazione o importanza delle caratteristiche non stabilisce causalità. Test multipli, gradi di libertà del ricercatore e reporting selettivo possono fabbricare pattern convincenti, perciò la preregistrazione o una fase confermativa chiaramente separata può aiutare.
La riproducibilità include codice, ambiente, snapshot dei dati, semi casuali, definizioni di query e un registro delle decisioni manuali. I test automatizzati dovrebbero coprire schemi, invarianti di business, trasformazioni e metriche. I notebook sono utili per l’esplorazione ma il lavoro di produzione richiede pipeline modulari e revisionabili. La revisione tra pari dovrebbe mettere in discussione assunzioni, leakage, validità del target e se i risultati si generalizzano. Comunica le dimensioni dell’effetto, l’incertezza, le limitazioni e le controprove anziché solo la significatività statistica o un punteggio di modello.
Deployment and decision impact
Se l’analisi guida un processo ricorrente, assegna proprietari, monitora freschezza dei dati e qualità dei risultati, e definisci rollback o ritiro. Proteggi le informazioni personali e confidenziali mediante minimizzazione, controllo degli accessi, conservazione e output sicuri. Valuta gli effetti sui sottogruppi e come gli utenti rispondono al modello; i loop di feedback possono modificare i dati futuri. Misura se la decisione ha migliorato l’obiettivo reale, non solo se un modello è stato distribuito. La data science ha successo quando l’evidenza cambia l’azione in modo affidabile e trasparente—non quando un’organizzazione accumula dashboard, funzionalità o esperimenti senza proprietà.
Worked example: measuring a retention intervention
Un team di prodotto osserva una minore retention e definisce un utente attivo, una coorte, una finestra, esclusioni e una decisione. Gli analisti controllano l’instrumentazione, gli eventi mancanti e il mix di acquisizione prima della modellazione. Le coorti descrittive identificano dove avviene il calo, un modello predittivo priorizza i partecipanti alla ricerca, e un esperimento randomizzato di onboarding stima se il cambiamento proposto migliora la retention. Queste sono tre analisi distinte con assunzioni e output separati.
Il notebook, le query, lo snapshot dei dati, la definizione della metrica e il piano dell’esperimento sono versionati e revisionati tra pari. I risultati riportano la dimensione dell’effetto e l’incertezza con guardrail per la domanda di supporto e l’accessibilità. Un dashboard monitora l’esperimento ma non sostituisce l’analisi predefinita. Se l’intervento ha successo, il rollout rimane graduale e verifica il comportamento a lungo termine. Il lavoro è considerato valido solo se supporta una decisione riproducibile, non perché è stato prodotto un modello complesso o un grafico visivamente accattivante.
Implementation evidence and operational readiness
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e la conseguenza di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione di dipendenze, uso improprio e i gruppi o ambienti più probabilmente sottoserviti. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere l’evidenza da un prototipo attraente.
Prima del lancio, assegna autorità per il rilascio, eccezioni, modifiche, rollback e ritiro. Usa un rollout graduale, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare qualità degli input, comportamento degli output, versione del modello o della regola, salute delle dipendenze, override umani e risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allerta e un responsabile della risposta, poi rivedi le evidenze reali dopo il deployment anziché presumere che la performance offline persista. Rivaluta ogni volta che fonti dati, utenti, modelli, fornitori, politiche, hardware o obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Frequently asked questions
Is data science the same as data analytics?
I termini si sovrappongono. La data science spesso include la costruzione di prodotti dati e sistemi predittivi, mentre l’analisi può concentrarsi maggiormente sul supporto decisionale descrittivo e diagnostico. L’uso organizzativo varia.
Does every data-science project need AI?
No. Una query, un grafico, un esperimento o una stima statistica ben progettati possono essere più utili e affidabili di un modello complesso.
Primary references











