Fondamenti di IA
Cos’è un Data Warehouse? Architettura, ETL e casi d’uso

 Aggiungi Unite.AI alle tue fonti preferite su Google
Un data warehouse è un sistema di dati analitico che integra le informazioni provenienti da fonti operative e le organizza per la reportistica, l’intelligence aziendale e l’analisi ripetibile. Separa molti carichi di lavoro analitici dalle applicazioni che registrano le transazioni.
I moderni data warehouse possono essere colonnari, distribuiti, serverless o collegati a storage a oggetti. Il lavoro fondamentale rimane coerente: ingestione governata, significato modellato, cronologia, prestazioni delle query, sicurezza, qualità e consegna affidabile agli utenti.
Punti chiave
- I sistemi operativi ottimizzano le transazioni correnti; i data warehouse ottimizzano l’analisi storica su più fonti.
- ETL trasforma prima del caricamento, mentre ELT carica prima e trasforma all’interno della piattaforma analitica.
- I modelli dimensionali, normalizzati e a tabelle larghe soddisfano diversi carichi di lavoro e esigenze di governance.
- La fiducia dipende da tracciabilità, test, freschezza, controllo degli accessi, definizioni semantiche e monitoraggio dei costi.
Fonti, ingestione e archiviazione
I dati possono arrivare tramite batch, change‑data capture, stream, file e API. Uno strato di landing preserva il contesto della sorgente; le trasformazioni standardizzano i tipi, deduplicano i record, gestiscono eventi tardivi e creano entità analitiche riutilizzabili.
Ciò estende il flusso di lavoro ETL. ELT utilizza la potenza di calcolo del warehouse per la trasformazione, mentre ETL può ridurre o convalidare i dati prima del caricamento. La scelta corretta dipende da latenza, privacy, scala e catena di strumenti.
Modellare i dati per le domande
I modelli dimensionali organizzano i fatti misurabili attorno a dimensioni descrittive come cliente, prodotto e tempo. I modelli core normalizzati possono preservare le relazioni aziendali, mentre i mart denormalizzati semplificano le query comuni.
Uno strato semantico fornisce definizioni coerenti per le metriche. Senza di esso, i team possono produrre diversi valori di fatturato o ritenzione apparentemente validi a partire dalle stesse righe. I dati strutturati richiedono comunque un significato concordato.
Warehouse, lake e lakehouse
Un data lake tipicamente memorizza file e dati grezzi o elaborati diversi nello storage a oggetti. Un warehouse fornisce tabelle analitiche gestite e servizi di query. I design lakehouse aggiungono metadati delle tabelle, transazioni e governance allo storage del lake.
Questi sono modelli architettonici, non garanzie. Le organizzazioni spesso li combinano tramite un data fabric o uno strato di governance condiviso. Carico di lavoro, competenze, interoperabilità e costo del ciclo di vita contano più dell’etichetta.
Qualità, sicurezza e operazioni
Definire proprietari, contratti, obiettivi di freschezza, tracciabilità, test, conservazione e accesso a righe o colonne. Separare i dati personalmente identificabili, utilizzare il principio del minimo privilegio e auditare le query sensibili. I backfill e le modifiche allo schema richiedono procedure controllate e osservabili.
Misurare i refresh riusciti, il ritardo dei dati, i fallimenti dei test, le prestazioni delle query, l’adozione, l’impatto degli incidenti e il costo per carico di lavoro. Un warehouse è utile quando le persone possono tracciare una metrica ai dati governati e riprodurre il risultato.
Modellazione dimensionale e semantica
Una tabella dei fatti registra eventi o misurazioni periodiche a un livello di granularità dichiarato, ad esempio una riga d’ordine o un dispositivo per ora. Le dimensioni forniscono contesto descrittivo. Dichiarare la granularità prima di selezionare le colonne evita di mescolare livelli che causano conteggi doppi. Le misure additive possono essere sommate su tutte le dimensioni; le misure semi‑additive richiedono attenzione nel tempo.
Le chiavi surrogate separano la cronologia del warehouse dagli identificatori di origine in evoluzione. Le dimensioni a lento cambiamento definiscono come gestire le variazioni degli attributi: sovrascrivere, preservare una nuova riga storica o mantenere valori precedenti limitati. Il metodo corretto segue la domanda analitica e gli obblighi di conservazione.
Una metrica semantica dovrebbe definire formula, filtri, comportamento temporale, valuta, esclusioni, proprietario e test. Definizioni centralizzate riducono le incoerenze, ma la governance dovrebbe consentire modifiche proposte e versionamento. Un unico strato semantico diventa un collo di bottiglia se gli utenti non possono ispezionarlo o estenderlo responsabilmente.
Architettura moderna di storage e query
Lo storage colonnare mantiene i valori di una colonna insieme, migliorando la compressione e la scansione solo dei campi necessari. Il partizionamento elimina grandi sezioni per data o altra chiave; il clustering colloca valori correlati; le viste materializzate e le cache riutilizzano i risultati. Scelte di partizionamento scadenti generano file piccoli, squilibri o scansioni complete costose.
I motori di query massivamente paralleli dividono scansioni, join e aggregazioni tra i worker. Il movimento dei dati durante i join può dominare il tempo di esecuzione, quindi distribuzione, statistiche e ordine dei join sono importanti. L’autoscaling e i servizi serverless semplificano la capacità ma richiedono controlli sui costi, priorità dei carichi di lavoro e limiti alle query incontrollate.
I formati di tabella lakehouse aggiungono metadati, snapshot, evoluzione dello schema e semantica delle transazioni sui file oggetto. Migliorano l’interoperabilità ma introducono responsabilità di catalogo e manutenzione. I formati aperti riducono il lock‑in solo quando i motori di calcolo, la governance e le procedure operative possono effettivamente usarli.
Pipeline affidabili e prodotti dati
Le pipeline dovrebbero essere idempotenti o in grado di riconciliare i duplicati. I watermark e il tempo degli eventi gestiscono gli arrivi tardivi; i backfill riproducono le trasformazioni storiche; i contratti di schema definiscono cambiamenti compatibili. I test sui dati coprono unicità, completezza, valori accettati, relazioni e invarianti di business, non solo se un job è stato eseguito.
Considerare i dataset importanti come prodotti con proprietari, documentazione, aspettative di servizio, scoperta, supporto e utenti. La tracciabilità collega i campi sorgente attraverso le trasformazioni ai report, rendendo più veloce l’impatto dei cambiamenti e l’indagine sugli incidenti. Le politiche di accesso dovrebbero propagarsi o essere rivalutate quando i dati vengono copiati.
Un programma di warehouse ha successo quando le decisioni diventano più affidabili e rapide, non quando il volume di storage cresce. Ritirare le tabelle inutilizzate, rendere visibili i costi di query e storage, rivedere gli accessi sensibili e misurare se i team confidano e riutilizzano le metriche governate anziché mantenere fogli di calcolo privati.
Esempio pratico: progettare un data warehouse per l’analisi delle vendite
Definire la granularità del fatto come una riga d’ordine completata, quindi collegare le dimensioni prodotto, cliente, canale, promozione, geografia e data tramite chiavi surrogate. Conservare gli eventi di stato dell’ordine in una tabella dei fatti separata invece di mescolare snapshot e transazioni. Fatturato, quantità, sconto, imposta e costo richiedono valuta esplicita, regole di reso, cancellazione e riconoscimento. La definizione della metrica dovrebbe produrre la stessa risposta in dashboard, notebook e riconciliazione finanziaria.
L’ingestione cattura le modifiche della sorgente, archivia dati grezzi immutabili, valida lo schema e li trasforma in modelli di staging e dimensionali testati. Gli aggiornamenti tardivi devono correggere il periodo storico appropriato senza duplicare i fatti. Confrontare il conteggio delle righe e i totali monetari con i sistemi sorgente, testare unicità e relazioni, e registrare la tracciabilità dal campo del report alla sorgente. I backfill utilizzano codice versionato e validazione isolata prima di sostituire le tabelle affidabili.
L’accesso separa gli identificatori dei clienti dagli aggregati ampiamente disponibili e applica il principio del minimo privilegio per ruolo e scopo. La gestione del carico di lavoro mantiene le dashboard esecutive reattive mentre gli analisti eseguono query esplorative. Monitorare freschezza, test falliti, costo delle query, tabelle inutilizzate e modifiche semantiche. Un warehouse ha successo quando le metriche governate supportano decisioni ripetibili; la semplice centralizzazione dei dati può centralizzare la confusione se la proprietà, la qualità e le definizioni rimangono irrisolte.
Il disaster recovery dovrebbe specificare la copertura dei backup, le copie cross‑region, il ripristino di cataloghi e permessi, la perdita di dati accettabile e il tempo di recupero. Testare il ripristino in un ambiente isolato e verificare le metriche, non solo i file. Le chiavi di crittografia, la configurazione dell’identità, il codice di orchestrazione e le definizioni semantiche fanno parte del sistema recuperabile. Un warehouse che può ripristinare petabyte ma non può riprodurre le politiche di accesso o i calcoli affidabili non ha recuperato il suo servizio analitico.
Checklist di implementazione pratica
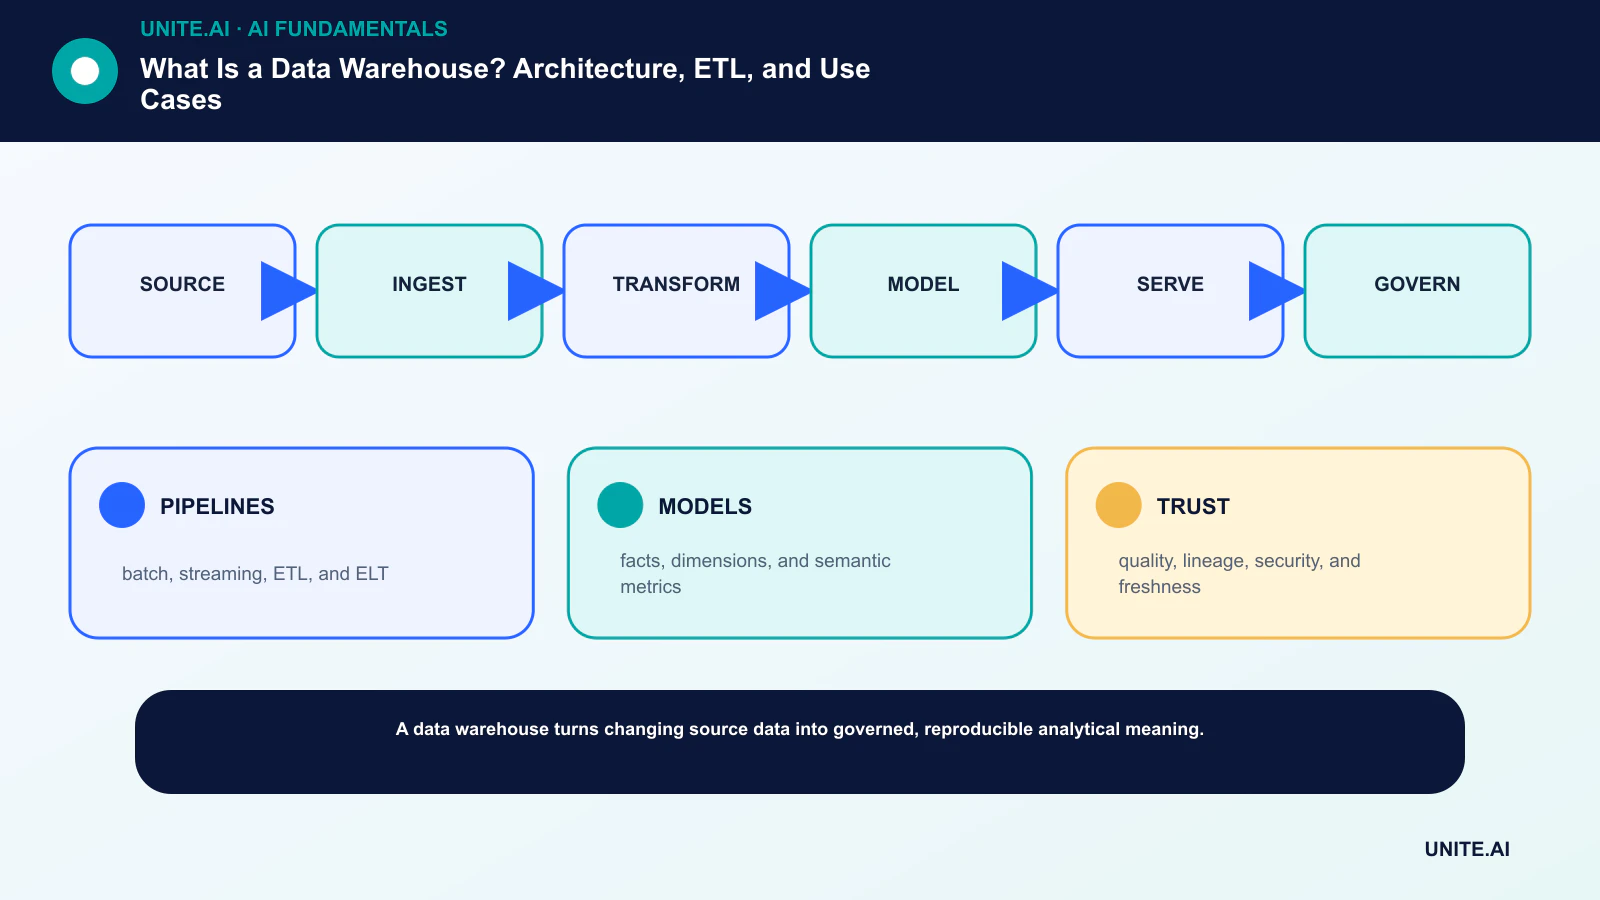
Trasformare il concetto in un flusso di lavoro delimitato e testabile: source → ingest → transform → model → serve → govern. Assegnare un proprietario responsabile, documentare i dati e le dipendenze, stabilire una baseline semplice, definire criteri di accettazione e di arresto, testare i fallimenti rappresentativi e definire monitoraggio, rollback e revisione prima di ampliare l’ambito. Registrare versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, eseguire una revisione di readiness documentata con le persone che costruiscono, gestiscono, proteggono e sono influenzate dal sistema. Testare casi normali, condizioni limite, fallimenti di dipendenze e usi impropri; conservare le evidenze e i rischi non risolti. Definire chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesaminare la decisione dopo l’arrivo di dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- PIPELINE: batch, streaming, ETL e ELT.
- MODELLI: fatti, dimensioni e metriche semantiche.
- FIDUCIA: qualità, tracciabilità, sicurezza e freschezza.
Domande frequenti
Un data warehouse è semplicemente un grande database?
È un database o una piattaforma analitica progettata per l’analisi integrata e storica. La sua modellazione, ingestione, governance e i modelli di carico di lavoro differiscono da un database di applicazioni transazionali.
Un’azienda dovrebbe utilizzare ETL o ELT?
Molti ne usano entrambi. Trasformare in anticipo quando privacy, convalida o larghezza di banda lo richiedono; trasformare dopo il caricamento quando la potenza di calcolo del warehouse e l’iterazione rapida sono vantaggiose.
Riferimenti principali