Fondamenti di IA
Cos’è l’ETL? Estrarre, Trasformare, Caricare spiegato

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveL'ETL integra fonti di dati sparse in un unico repository per l'analisi e il processo…
Vedi di più
- L'ETL integra fonti di dati sparse in un unico repository per l'analisi e il processo decisionale.
- Gli strumenti ETL no-code eliminano la necessità di codifica e consentono ai lavoratori non tecnici di eseguire l'ETL.
- Lo Zero ETL potrebbe sostituire le pipeline tradizionali con il trasferimento diretto dei dati in tempo quasi reale.
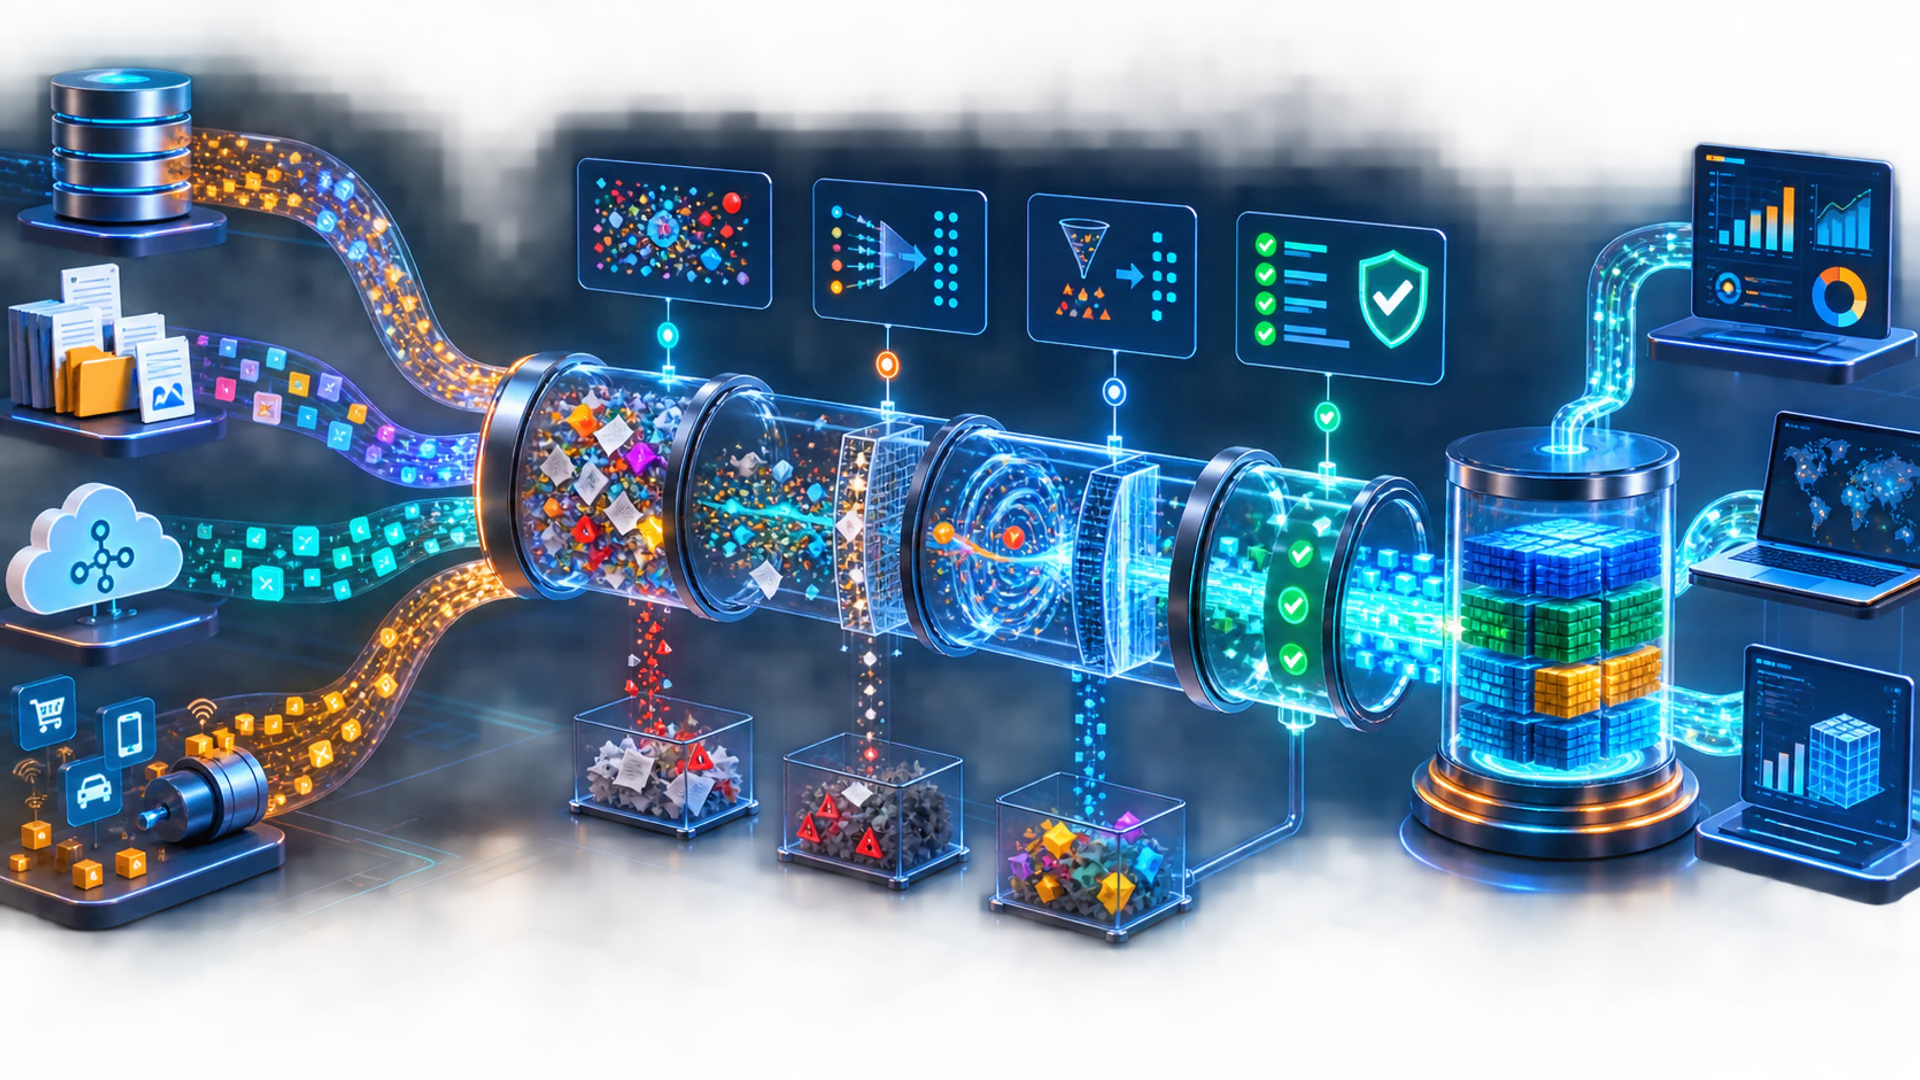
ETL—estrazione, trasformazione, caricamento—è un modello di integrazione dati che legge i dati dai sistemi sorgente, li valida e li ristruttura, quindi li scrive in una destinazione adatta ad analisi, reporting, apprendimento automatico o operazioni.
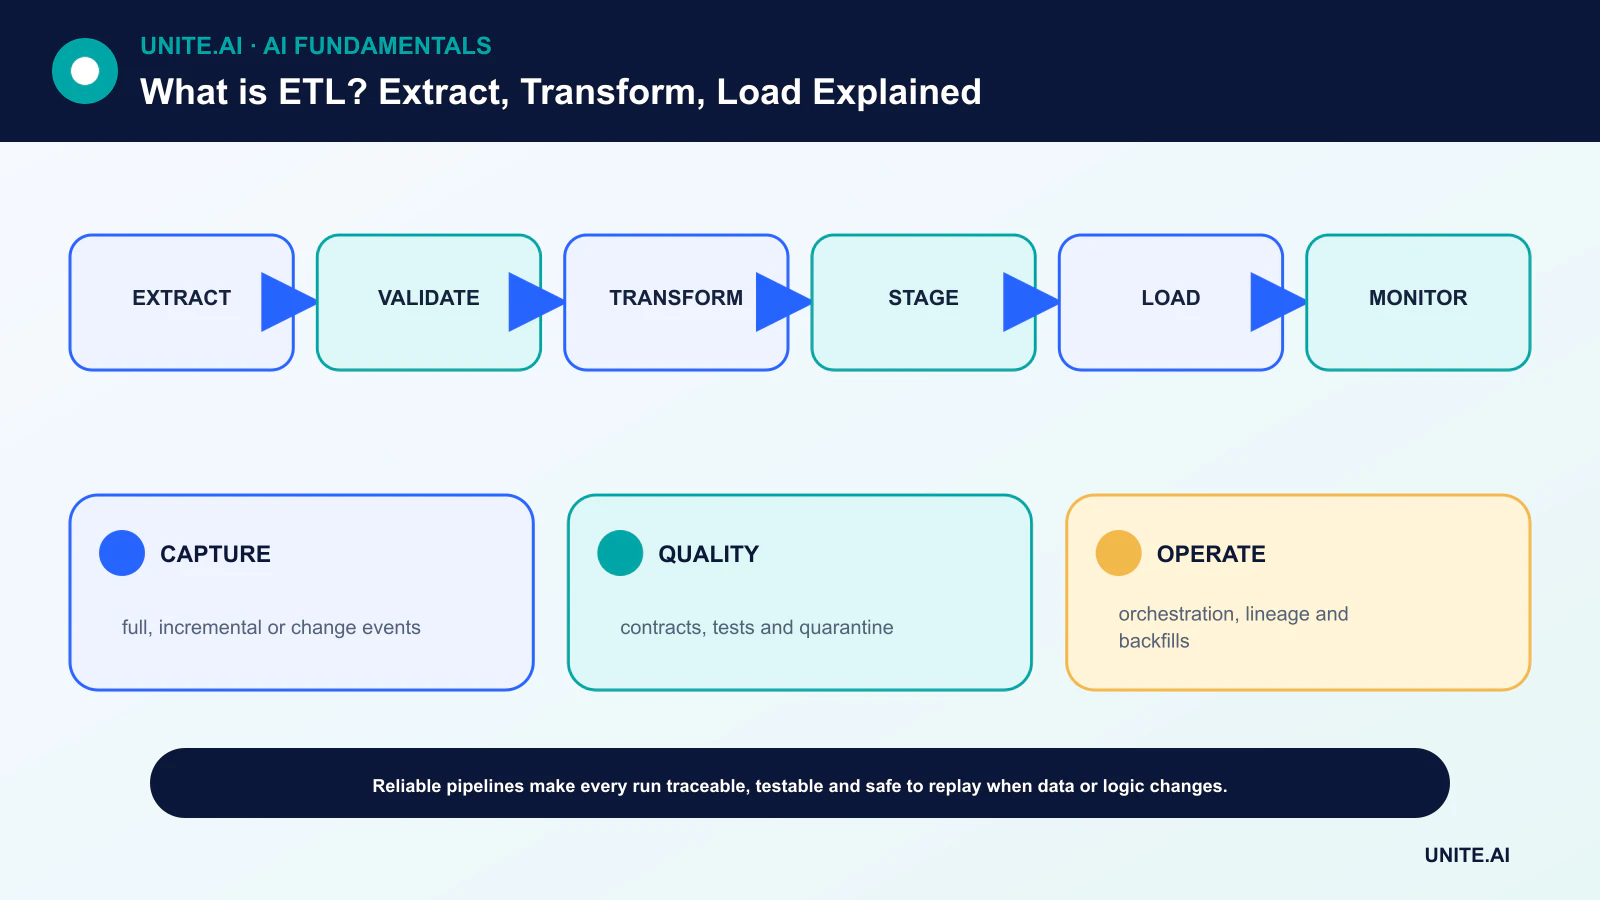
Una pipeline ETL di produzione è più di tre semplici componenti. Richiede un’esecuzione ripetibile, controlli di schema e qualità, tracciabilità, orchestrazione, osservabilità, sicurezza e un modo sicuro per retroalimentare o riprodurre i dati quando la logica cambia.
Punti chiave
- L’estrazione dovrebbe minimizzare l’impatto sulla sorgente e registrare quale intervallo o set di modifiche è stato acquisito.
- Le trasformazioni codificano il significato di business, quindi necessitano di controllo di versione, test e responsabilità.
- I caricamenti dovrebbero essere idempotenti o, in alternativa, proteggere da duplicati e fallimenti parziali.
- ETL rispetto a ELT riguarda principalmente dove avviene la trasformazione; i sistemi moderni spesso utilizzano entrambi.
Estrarre dati in modo affidabile
Le sorgenti possono includere database, file, API, flussi di eventi e applicazioni. Un’estrazione completa copia un set completo; un’estrazione incrementale legge i record modificati dall’ultimo checkpoint. Il change-data capture consuma i log del database o gli eventi per ridurre le scansioni ripetute.
Registra gli identificatori della sorgente, i limiti temporali e i checkpoint. Rispetta i limiti di velocità e le semantiche delle transazioni. Se una sorgente modifica lo schema in modo silenzioso, fallisci in modo sicuro o metti in quarantena i record anziché caricare dati ambigui come se nulla fosse accaduto.
Trasformare con contratti espliciti
Le trasformazioni standardizzano tipi e unità, analizzano i record, uniscono le sorgenti, rimuovono o segnalano i duplicati, applicano regole di business e calcolano le feature. Separano i dati non validi da quelli mancanti ma accettabili, e conservano prove sufficienti per ricondurre un output ai suoi input.
Versiona le trasformazioni con la stessa disciplina della consegna del software. I test dovrebbero coprire schema, intervalli, integrità referenziale, distribuzioni attese ed esempi noti. Un contratto dati definisce le aspettative tra produttore e consumatore.
Caricare in modo sicuro e ripetibile
Un caricamento può aggiungere eventi, unire record modificati, sostituire una partizione o ricostruire una tabella. L’idempotenza significa che rieseguire lo stesso input produce lo stesso stato della destinazione. Transazioni, tabelle di staging e scambi atomici riducono l’esposizione a aggiornamenti parziali.
Il partizionamento e l’indicizzazione dovrebbero corrispondere ai pattern di consumo. Proteggi i campi sensibili e applica le autorizzazioni di destinazione prima che i dati diventino interrogabili. I requisiti di conservazione e cancellazione devono accompagnare i dati.
ETL, ELT, batch e streaming
L’ETL tradizionale trasforma in un motore separato prima del caricamento. L’ELT carica prima dati grezzi o leggermente elaborati, quindi utilizza la potenza di calcolo della destinazione per la trasformazione. Un data warehouse o lakehouse cloud può rendere l’ELT conveniente, ma non elimina il lavoro di qualità o governance.
Le pipeline batch elaborano intervalli limitati; le pipeline streaming elaborano eventi continui con semantica di tempo e ordinamento definita. Molte architetture usano l’ingestione streaming seguita da riconciliazione periodica, poiché dati tardivi o corretti sono normali.
Orchestrazione, tracciabilità e osservabilità
Un orchestratore pianifica i task, rispetta le dipendenze, riprova i fallimenti definiti e registra lo stato. I retry necessitano di limiti e task idempotenti. I backfill dovrebbero essere isolati e consapevoli della capacità, così la riparazione storica non interrompe i dati attuali.
Monitora freschezza, volume, schema, qualità, durata e costo. La tracciabilità e lo strato di metadati di un data fabric aiutano i consumatori a capire quale versione ha prodotto un dataset e cosa si è rotto a monte.
Estrazione: sorgenti, contratti e acquisizione incrementale
L’ETL sposta i dati dai sistemi sorgente, li trasforma in strutture governate e carica una destinazione. L’estrazione può utilizzare file, query di database, API, log, stream o change-data capture. Definisci la proprietà della sorgente, lo schema, le chiavi, i timestamp, il fuso orario, le unità, la semantica di cancellazione e il caricamento consentito. Le estrazioni complete sono semplici ma costose; l’acquisizione incrementale riduce il volume ma richiede watermark, posizioni di log o campi di versione e una strategia per record tardivi e corretti.
Non presumere che un successo API significhi un’estrazione completa. Registra conteggi, checksum, lacune di sequenza, paginazione, limiti di velocità, retry e snapshot della sorgente. Conserva i dati grezzi immutabili dove la politica lo consente affinché le trasformazioni possano essere riprodotte. Proteggi credenziali e campi sensibili, e rendi i retry idempotenti. Le modifiche allo schema dovrebbero essere classificate come compatibili o breaking tramite contratti, piuttosto che scoperte quando una dashboard a valle cambia silenziosamente.
Trasformare e caricare con semantica riproducibile
Le trasformazioni analizzano i tipi, standardizzano le unità, rimuovono duplicati, uniscono, applicano regole di business, gestiscono la cronologia e derivano fatti e dimensioni. Ogni regola necessita di test e tracciabilità. Applica la pre‑elaborazione statistica solo sui dati di training appropriati quando l’ETL alimenta il ML. Le dimensioni a cambiamento lento determinano se le modifiche agli attributi sovrascrivono o preservano la cronologia. Dichiarare il grain del fatto prima dell’unione; gli errori many‑to‑many creano misure duplicate che possono sopravvivere ai controlli di riga di base.
Il caricamento può aggiungere, unire, sostituire partizioni o aggiornare record. Usa tabelle di staging e scambi atomici dove possibile così i lettori non vedono stati parziali. Impone unicità, relazioni, valori accettati, completezza e invarianti di business. Gestisci eventi tardivi e backfill con tempo dell’evento e codice versionato. La riconciliazione rispetto ai totali della sorgente è essenziale per dati finanziari e operativi. L’ELT carica dati grezzi prima della trasformazione nella destinazione; i requisiti di governance e correttezza rimangono.
Operazioni e recupero
L’orchestrazione gestisce dipendenze, pianificazioni, retry, concorrenza e avvisi. Monitora freschezza, volume, qualità, durata, costo e impatto a valle. Un job fallito dovrebbe riprendere o riprodurre senza duplicazioni. Versiona codice e schemi, mantieni la tracciabilità e testa i backfill in isolamento. Il disaster recovery include dati grezzi, cataloghi, autorizzazioni, stato dell’orchestrazione e definizioni semantiche. L’ETL è affidabile quando un utente può ricondurre una metrica alle sorgenti e riprodurla dopo una modifica, non solo quando una pipeline verde è completata.
Esempio pratico: una pipeline di ordine incrementale
Un job ETL legge i log di cambiamento del database per ordini e articoli, memorizza eventi immutabili, valida sequenza e schema, e li unisce in una tabella di fatti del data warehouse a livello di riga d’ordine. Il tempo dell’evento e la versione di aggiornamento gestiscono correzioni tardive; chiavi deterministiche rendono il replay idempotente. Le dimensioni conservano la cronologia selezionata di clienti e prodotti tramite chiavi surrogate. Conteggi di righe, totali degli ordini, tasse, resi e cancellazioni vengono riconciliati con i periodi di origine.
Una modifica a un campo sorgente che rompe il modello interrompe la promozione verso le tabelle attendibili e avvisa i proprietari con la tracciabilità a valle. I backfill vengono eseguiti con codice versionato in isolamento e confrontati prima di uno scambio atomico. La politica di accesso limita gli identificatori dei clienti, e la cancellazione si propaga alle copie derivate consentite. Il monitoraggio copre freschezza, volume, qualità, costo e impatto sui dashboard. I test di recupero ricostruiscono un periodo dagli eventi grezzi e ripristinano lo stato dell’orchestrazione. Un scheduler verde è insufficiente a meno che i numeri di business rimangano riproducibili e riconciliati.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento critico. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più a rischio di essere trascurati. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allerta e un responsabile di risposta, quindi esamina le prove dal mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivaluta ogni volta che le sorgenti dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui disattivarlo o sostituirlo.
Domande frequenti
L’ETL è obsoleto nelle piattaforme di dati cloud?
No. Alcune piattaforme favoriscono l’ELT, ma le responsabilità di estrazione, trasformazione e caricamento esistono ancora. I team spesso combinano entrambi i modelli.
Cosa rende una pipeline ETL idempotente?
Può elaborare in modo sicuro lo stesso input nuovamente senza creare uno stato di destinazione duplicato o incoerente, solitamente tramite chiavi stabili, checkpoint e scritture transazionali.
Riferimenti principali