Fondamenti di IA
Cos’è un Data Fabric?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Punti chiaveA data fabric coordinates distributed data through shared metadata and policy without…
Vedi di più
- A data fabric coordinates distributed data through shared metadata and policy without forcing one physical store.
- Data fabric and data mesh differ in focus but can coexist through domain ownership on shared technical services.
- Success requires measuring discovery time, access lead time, and trusted metric reuse rather than connector counts.
Un data fabric è un modello architetturale per scoprire, collegare, governare e distribuire i dati attraverso sistemi distribuiti. Fornisce uno strato condiviso di metadati e di controllo affinché persone e applicazioni possano trovare dati affidabili senza costringere ogni set di dati in un unico archivio fisico.
Un data fabric non è un prodotto unico e non elimina le differenze dei sistemi di origine. Il suo valore dipende da metadati accurati, proprietà chiare, politiche applicabili, integrazione affidabile e prove che i consumatori ricevano dati adeguati al loro scopo.
Punti chiave
- Un piano di controllo ricco di metadati collega cataloghi, lineage, qualità, politiche e accessi.
- I dati possono rimanere distribuiti e essere copiati, trasmessi in streaming, trasformati o virtualizzati in base al carico di lavoro.
- Il data fabric è orientato alla tecnologia; il data mesh enfatizza la proprietà di dominio e i dati come prodotto.
- L’automazione aiuta a scalare la governance, ma i proprietari responsabili definiscono ancora significato, qualità e uso consentito.
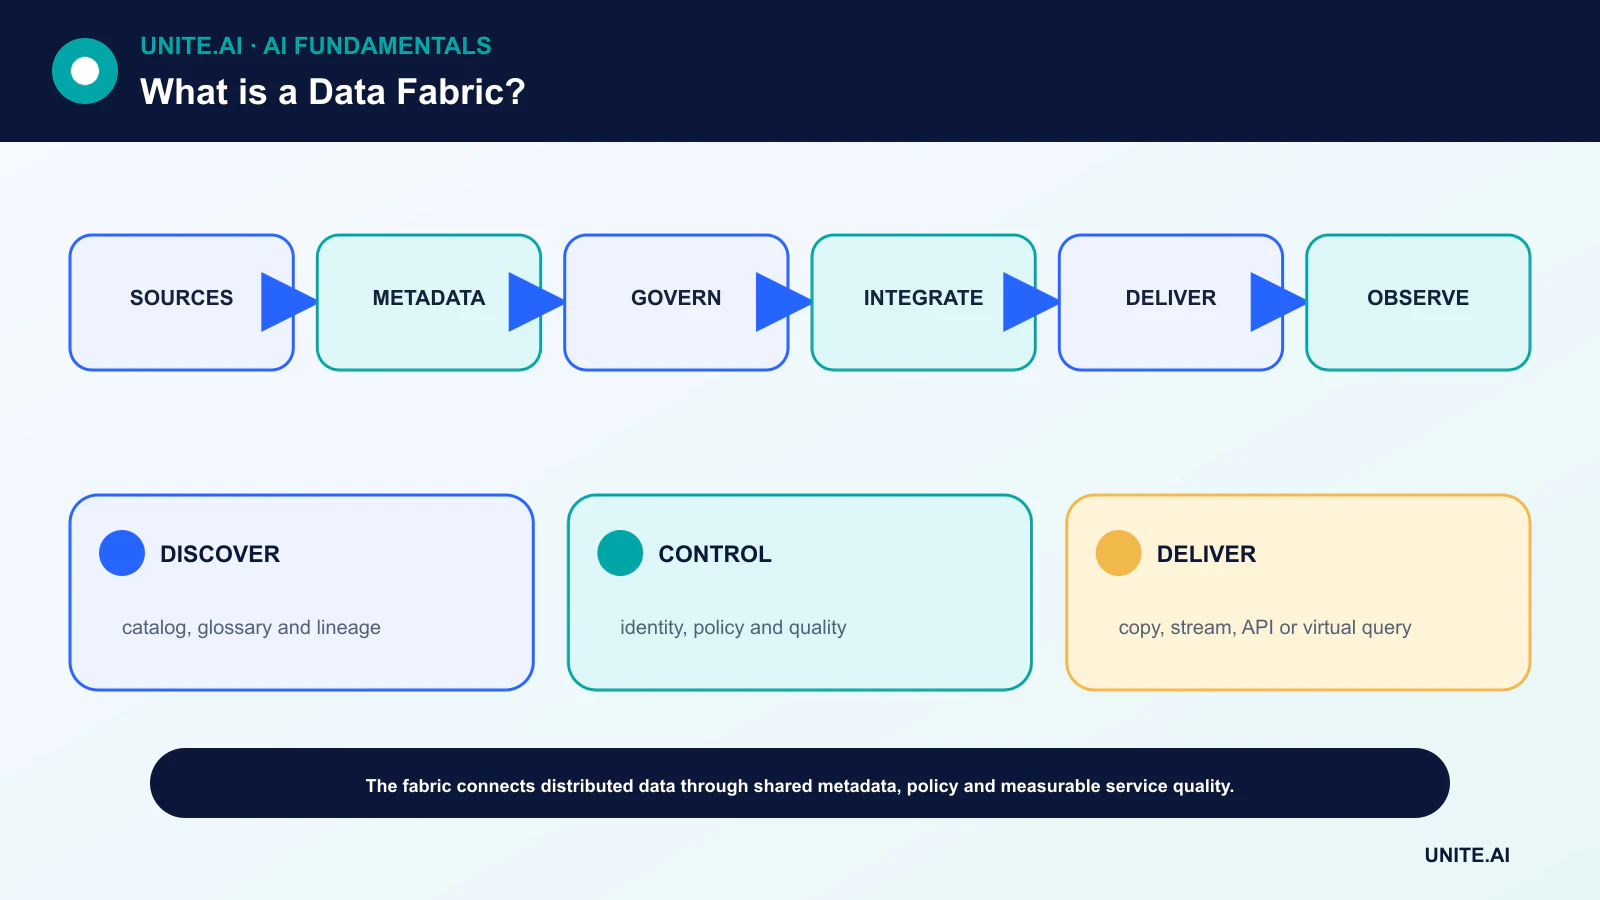
Il piano di controllo e il piano dati
Il piano dati contiene database, file, flussi, API e le pipeline che li spostano o li interrogano. Il piano di controllo registra metadati tecnici e di business: schemi, proprietari, classificazioni, misure di qualità, lineage, politiche e utilizzo.
Un catalogo o un grafo di conoscenza può collegare questi fatti in modo che un consumatore possa scoprire un dataset e comprenderne il contesto. Il fabric utilizza quindi i metadati per guidare l’accesso, la trasformazione, l’osservabilità e l’applicazione delle politiche su piattaforme eterogenee.
Integrazione senza un archivio obbligatorio
Alcuni carichi di lavoro copiano i dati tramite ETL; altri utilizzano change-data capture, flussi di eventi, API o virtualizzazione delle query. Il modello corretto dipende da freschezza, prestazioni, coerenza, sovranità, costo e limiti del sistema di origine.
L’accesso virtuale può ridurre la duplicazione ma può esporre i consumatori a latenza e disponibilità della sorgente. La materializzazione fisica migliora le prestazioni e la riproducibilità, ma genera responsabilità di sincronizzazione e di ciclo di vita.
Governance, semantica e qualità
Un glossario aziendale fornisce un significato condiviso a termini come cliente, ordine o conto attivo. Il lineage mostra da dove proviene un campo e come è cambiato. La classificazione e la politica determinano chi può accedere a record sensibili e per quale scopo.
Le regole di qualità dovrebbero essere associate a casi d’uso specifici. La completezza sufficiente per una dashboard può essere inadeguata per decisioni automatizzate. Un fabric dovrebbe evidenziare freschezza, storico di validazione e limitazioni note, anziché limitarsi a etichettare un asset come certificato.
Data fabric, mesh e lakehouse
Il data mesh è un approccio sociotecnico che assegna ai team di dominio la responsabilità dei prodotti dati interoperabili. Un data fabric enfatizza servizi tecnici condivisi e l’automazione dei metadati. Le organizzazioni possono combinarli: la proprietà di dominio può operare attraverso un fabric comune.
Un lakehouse combina la flessibilità del data lake con la gestione e le funzionalità di query tipiche di un data warehouse. Può essere una piattaforma partecipante, ma non è l’intero fabric cross‑system. Allo stesso modo, un data warehouse o un catalogo da soli non forniscono tutte le funzioni di integrazione e di politica.
Implementazione e valutazione
Iniziare con un caso d’uso cross‑system di valore e fare un inventario delle fonti minime, dei proprietari, delle politiche e delle aspettative di livello di servizio. Stabilire identità, standard di metadati, contratti, test e osservabilità prima di aggiungere raccomandazioni automatizzate.
Misurare il tempo di scoperta, il tempo di approvazione dell’accesso, i tassi di incidenti, la freschezza dei dati, il riutilizzo e la fiducia dei consumatori. Collegare il fabric alla governance dei dati strutturati e non strutturati e alla cybersecurity; la connettività senza controllo può aumentare l’esposizione.
Architettura del data‑fabric e piano dei metadati
Un data fabric è un approccio architetturale per collegare dati distribuiti tramite metadati condivisi, governance, integrazione e servizi di accesso. Non è un unico database o prodotto. Le fonti possono rimanere in data warehouse, lake, sistemi operazionali, flussi e piattaforme SaaS, mentre i cataloghi descrivono i dataset, il lineage traccia le trasformazioni, le politiche controllano l’accesso e le definizioni semantiche rendono i concetti riutilizzabili. Virtualizzazione, replica, API e pipeline sono metodi di consegna complementari scelti in base a latenza, scala, capacità della sorgente e necessità di coerenza.
I metadati attivi catturano schemi, proprietà, utilizzo, qualità, classificazioni, lineage, modelli di query ed eventi operativi e possono guidare l’automazione. Un grafo di conoscenza può collegare concetti aziendali a campi fisici e politiche. L’automazione può raccomandare join, rilevare drift, propagare classificazioni o instradare incidenti, ma i metadati inferiti richiedono fiducia e gestione. Un catalogo non collegato alla consegna e ai controlli diventa debito di documentazione; l’integrazione automatizzata senza proprietà semantica genera incoerenze più rapide.
Integrazione, governance e prodotti dati
Batch ETL, change-data capture, stream, federazione e reverse ETL hanno diverse semantiche di freschezza e di errore. Definire fonti autoritative, identificatori, contratti, orari degli eventi, dati in ritardo, cancellazioni e riconciliazione. Le query virtuali evitano copie ma dipendono dalle prestazioni e dalla disponibilità della sorgente; la materializzazione migliora la velocità ma crea obblighi di freschezza e conservazione. Le politiche sui dati sensibili devono seguire i dati o rivalutate per dati derivati, cache, embedding e esportazioni.
Considerare i dataset di alto valore come prodotti con proprietari, utenti, documentazione, aspettative di servizio, test e supporto. La proprietà federata consente ai domini di gestire il significato mentre gli standard condivisi preservano l’interoperabilità. I team centrali forniscono capacità di piattaforma e governance, non la proprietà di ogni campo. Misurare il tempo di scoperta, il riutilizzo, la qualità dei dati, il lead time di accesso, la risoluzione degli incidenti, l’adozione di metriche affidabili e i costi. Il numero di voci di catalogo o connettori non è prova che le persone possano trovare e utilizzare dati affidabili.
Strategia di implementazione
Iniziare con un percorso cross‑domain i cui ritardi e rischi sono noti. Inventariare le fonti e i contratti, stabilire identità e classificazione, collegare lineage e qualità, quindi automatizzare i controlli ripetuti. Evitare un tentativo pluriennale di modellare l’intera impresa prima di fornire valore. Testare interruzioni della fonte, modifiche allo schema, revoca di accessi, eventi in ritardo e ripristino di emergenza. Un data fabric ha successo quando i dati distribuiti diventano più facili da governare e utilizzare senza cancellare le realtà operative e la responsabilità dei sistemi di origine.
Esempio pratico: un data fabric per i clienti
Un’azienda collega dati di commercio, supporto, marketing e prodotto mantenendo i sistemi operazionali come fonti autorevoli. Un catalogo condiviso collega le definizioni di cliente, account, ordine, consenso e interazione ai campi fisici. Il change-data capture alimenta prodotti governati, mentre la virtualizzazione serve ricerche correnti a basso volume e le tabelle materializzate supportano l’analisi. Identità, lineage, qualità e politiche sono implementati prima che uno strato di personalizzazione AI possa utilizzare i dati.
Una revoca del consenso si propaga attraverso tabelle del warehouse, indici di ricerca, embedding e sistemi di attivazione, con evidenza di completamento. I contratti di schema e i test di riconciliazione rilevano le modifiche alle fonti. I proprietari pubblicano le aspettative di freschezza e qualità, e i metadati di utilizzo aiutano a eliminare copie inutilizzate. Il pilota misura il lead time di accesso, il riutilizzo di metriche affidabili, la risoluzione degli incidenti e la conformità alla privacy. Il fabric è considerato di successo perché un percorso cross‑domain diventa affidabile e governabile, non perché un fornitore abbia collegato il maggior numero di fonti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti introdotti deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le interventi manuali di correzione e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi esaminare le prove reali dopo il dispiegamento anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Un data fabric sposta tutti i dati in un unico luogo?
No. Può coordinare i dati che rimangono distribuiti e scegliere lo spostamento fisico o la virtualizzazione in base al carico di lavoro.
Un data fabric è lo stesso di un data mesh?
No. Il fabric descrive principalmente un’architettura abilitante e l’automazione; il mesh descrive principalmente la proprietà decentralizzata del dominio e le responsabilità dei prodotti dati. Possono coesistere.
Riferimenti principali