
Fondamenti di IA
Che cos’è l’ingegneria delle piattaforme? Piattaforme, esperienza dello sviluppatore e guardrail

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’ingegneria delle piattaforme è la pratica di costruire e gestire capacità interne condivise che aiutano i team software a consegnare ed eseguire le applicazioni tramite flussi di lavoro self‑service supportati. La piattaforma è trattata come un prodotto i cui utenti sono sviluppatori e altri team tecnici.
Una piattaforma non è automaticamente un portale, un cluster Kubernetes o una raccolta di script. Diventa utile quando riduce il carico cognitivo e i tempi di consegna, migliorando al contempo affidabilità, sicurezza, osservabilità e coerenza organizzativa.
Punti chiave
- Inizia con la ricerca tra gli sviluppatori e le frizioni ricorrenti, non con una stack di strumenti predefinita.
- Offri percorsi dorati opzionali e supportati con chiare vie di fuga per eccezioni legittime.
- Esporre le capacità tramite API, template, automazione e documentazione; un portale è solo un’interfaccia.
- Misura i risultati per gli utenti e l’adozione del prodotto insieme a consegna, affidabilità, sicurezza e costi.
Piattaforma come prodotto interno
Un team di piattaforma identifica gli utenti interni, i percorsi, i punti di dolore e i risultati desiderati. Mantiene una roadmap, livelli di servizio, documentazione, supporto e cicli di feedback come qualsiasi team di prodotto. L’adozione è guadagnata per utilità, non imposta nominando un team centrale.
Ciò estende la collaborazione DevOps. I team di applicazione mantengono la proprietà dei loro servizi mentre la piattaforma fornisce capacità riutilizzabili e policy.
Capacità, portali e percorsi dorati
Le capacità possono includere repository, ambienti, CI/CD, segreti, identità, infrastruttura, osservabilità, cataloghi di servizi, costi e integrazione degli incidenti. Un portale per sviluppatori può esporle, ma l’orchestrazione e i servizi operativi rendono la piattaforma reale.
Un percorso dorato è un modo ben supportato per eseguire un compito comune. Deve incorporare impostazioni predefinite sicure e rimanere trasparente. I team hanno bisogno di un percorso di eccezione governato quando i requisiti differiscono.
Architettura e guardrail
Utilizza interfacce stabili e API dichiarative affinché la piattaforma possa evolvere dietro di esse. Separa il piano di controllo dai carichi di lavoro, delimita le credenziali, conserva i metadati di proprietà e rendi le modifiche generate revisionabili e reversibili.
Integra i controlli DevSecOps, le policy e la provenienza degli artefatti nei flussi di lavoro. I guardrail dovrebbero fornire feedback rapido e rimedi azionabili anziché rifiuti inspiegabili.
Misurare e evolvere
Misura il tempo al primo deployment, il lead time, il recupero da cambi falliti, la disponibilità della piattaforma, il carico di supporto, l’adozione, la soddisfazione, lo stato di sicurezza e i costi. Evita di contare i login al portale come proxy di una consegna migliorata.
Strumenta la piattaforma mediante le pratiche di IT operations e intervista regolarmente gli utenti. Elimina i percorsi inutilizzati, standardizza dove la ripetizione è costosa e consenti la diversità dove genera valore di prodotto.
Piattaforme di sviluppo interne e percorsi dorati
Una piattaforma di sviluppo interna è un prodotto che espone infrastrutture e capacità operative approvate tramite interfacce self‑service. Può combinare un portale, un catalogo di servizi, template, API, strumenti da riga di comando, flussi di lavoro di deployment, segreti, ambienti e osservabilità. La piattaforma non sostituisce il cloud o Kubernetes; li organizza in capacità utilizzabili.
Un percorso dorato è un modo opinato e supportato per completare un compito comune, ad esempio creare un servizio con repository, pipeline CI, runtime, dashboard, avvisi e metadati di proprietà. Deve essere l’opzione più semplice e sicura, consentendo eccezioni giustificate. Un percorso obbligatorio che non può supportare carichi di lavoro reali diventa un collo di bottiglia o viene aggirato.
I team di piattaforma dovrebbero trattare gli sviluppatori come clienti e le capacità come prodotti. Interviste di scoperta, analisi d’uso, dati di supporto, roadmap, documentazione e obiettivi di livello di servizio sono importanti quanto l’automazione. L’adozione è prova di utilità, ma da sola non dimostra che la consegna, l’affidabilità, la sicurezza o l’esperienza dello sviluppatore siano migliorate.
Piani di controllo, interfacce e modello operativo
Il piano di controllo della piattaforma riconcilia l’intento dichiarato dallo sviluppatore con le risorse sottostanti. Una definizione di servizio può richiedere un runtime, un database, una regione e un livello di affidabilità; i controller traducono ciò in configurazioni cloud, di rete, policy e osservabilità. Le astrazioni stabili dovrebbero nascondere la complessità incidentale senza occultare lo stato operativo necessario per il debug.
Le interfacce possono includere portali web, API, configurazioni basate su Git, CLI e componenti di pipeline riutilizzabili. L’interfaccia migliore dipende dalla frequenza dei compiti e dal flusso di lavoro dell’utente. Ogni interfaccia richiede autenticazione, autorizzazione, validazione, cronologia di audit, spiegazioni degli errori e versionamento. Il self‑service senza gestione del ciclo di vita genera risorse abbandonate e proliferazione di configurazioni.
Un team di piattaforma possiede capacità condivise e percorsi già tracciati, mentre i team di applicazione mantengono la responsabilità del comportamento del software e dei risultati di business. I team di sicurezza, affidabilità, finanza e infrastruttura contribuiscono con policy e servizi. Confini di responsabilità espliciti impediscono che la piattaforma diventi una coda di ticket non responsabile o un tentativo di centralizzare ogni decisione ingegneristica.
Misurare il valore ed evitare il fallimento della piattaforma
Misura il lead time al primo deployment in produzione, il tempo di provisioning dell’ambiente, la frequenza di deployment, il tasso di fallimento dei cambi, il tempo di recupero, il carico cognitivo, il volume di supporto, l’affidabilità e l’adozione dei controlli di sicurezza. Segmenta i risultati per team e carico di lavoro. Un lancio di template più veloce ha valore limitato se le modifiche successive rimangono lente o gli incidenti diventano più difficili da diagnosticare.
I fallimenti comuni includono costruire prima di comprendere gli utenti, copiare lo stack di una grande azienda, esporre infrastruttura grezza dietro un portale, imporre una standardizzazione prematura e ottimizzare per la produzione del team di piattaforma. Inizia con un percorso ricorrente doloroso, mappa i suoi passaggi e le attese, fornisci un percorso end‑to‑end snello e itera basandoti sui risultati osservati.
Le piattaforme devono evolvere senza destabilizzare tutti i servizi. Usa contratti versionati, finestre di deprecazione, migrazioni automatizzate, test di compatibilità e proprietà chiare. Traccia le dipendenze della piattaforma affinché un’interruzione del piano di controllo non blocchi tutti i deployment o danneggi i carichi di lavoro in esecuzione. Documenta le procedure di emergenza (break‑glass) e testa regolarmente il recupero da un fallimento della piattaforma.
Esempio pratico: un percorso self‑service per una nuova API
Uno sviluppatore seleziona un template API approvato e fornisce nome del servizio, proprietario, classificazione dei dati, linguaggio e livello di affidabilità. La piattaforma crea un repository, una policy di dipendenza, una pipeline CI, un ambiente di test, una configurazione di deployment, una voce del catalogo servizi, dashboard, avvisi e un runbook iniziale. La policy valida nomi, regioni, permessi e esposizione di rete prima del provisioning, mentre gli artefatti generati rimangono ispezionabili e di proprietà del team.
La piattaforma espone le operazioni di ciclo di vita — creare ambiente, deploy, scalare, ruotare un segreto, visualizzare i log, effettuare rollback e ritirare — tramite API stabili e un portale. I carichi di lavoro in esecuzione continuano se il portale è non disponibile. Le eccezioni utilizzano un punto di estensione documentato e una scadenza anziché una modifica manuale non tracciata. Template versionati e migrazioni automatizzate impediscono che miglioramenti della piattaforma interrompano silenziosamente i servizi esistenti.
Misura il tempo dalla creazione del repository a un deployment di produzione sano, lo sforzo dello sviluppatore, la domanda di supporto, i fallimenti di cambi, il recupero, la conformità alle policy e l’adozione per tipologia di carico di lavoro. Intervista gli utenti che abbandonano il percorso e analizza dove attendono o sfuggono all’astrazione. Il team di piattaforma dovrebbe dare priorità alla frizione ricorrente più grande, pubblicare affidabilità e roadmap, e ritirare le capacità inutilizzate. Un catalogo curato non è una piattaforma se i team hanno ancora bisogno di ticket per ogni operazione significativa.
L’adozione dovrebbe avvenire a tappe. Inizia con team volontari e una classe di carico di lavoro, dimostra le operazioni del giorno due, poi migra con strumenti e supporto. Pubblica gli obiettivi di servizio della piattaforma e lo stato delle dipendenze, e progetta una via di emergenza (break‑glass) controllata ma utilizzabile durante le interruzioni. Il chargeback o lo showback possono evidenziare i costi delle risorse, ma i team di prodotto hanno anche bisogno di impostazioni predefinite sensate affinché la governance finanziaria non diventi un’altra coda di approvazione manuale.
Checklist di implementazione pratica
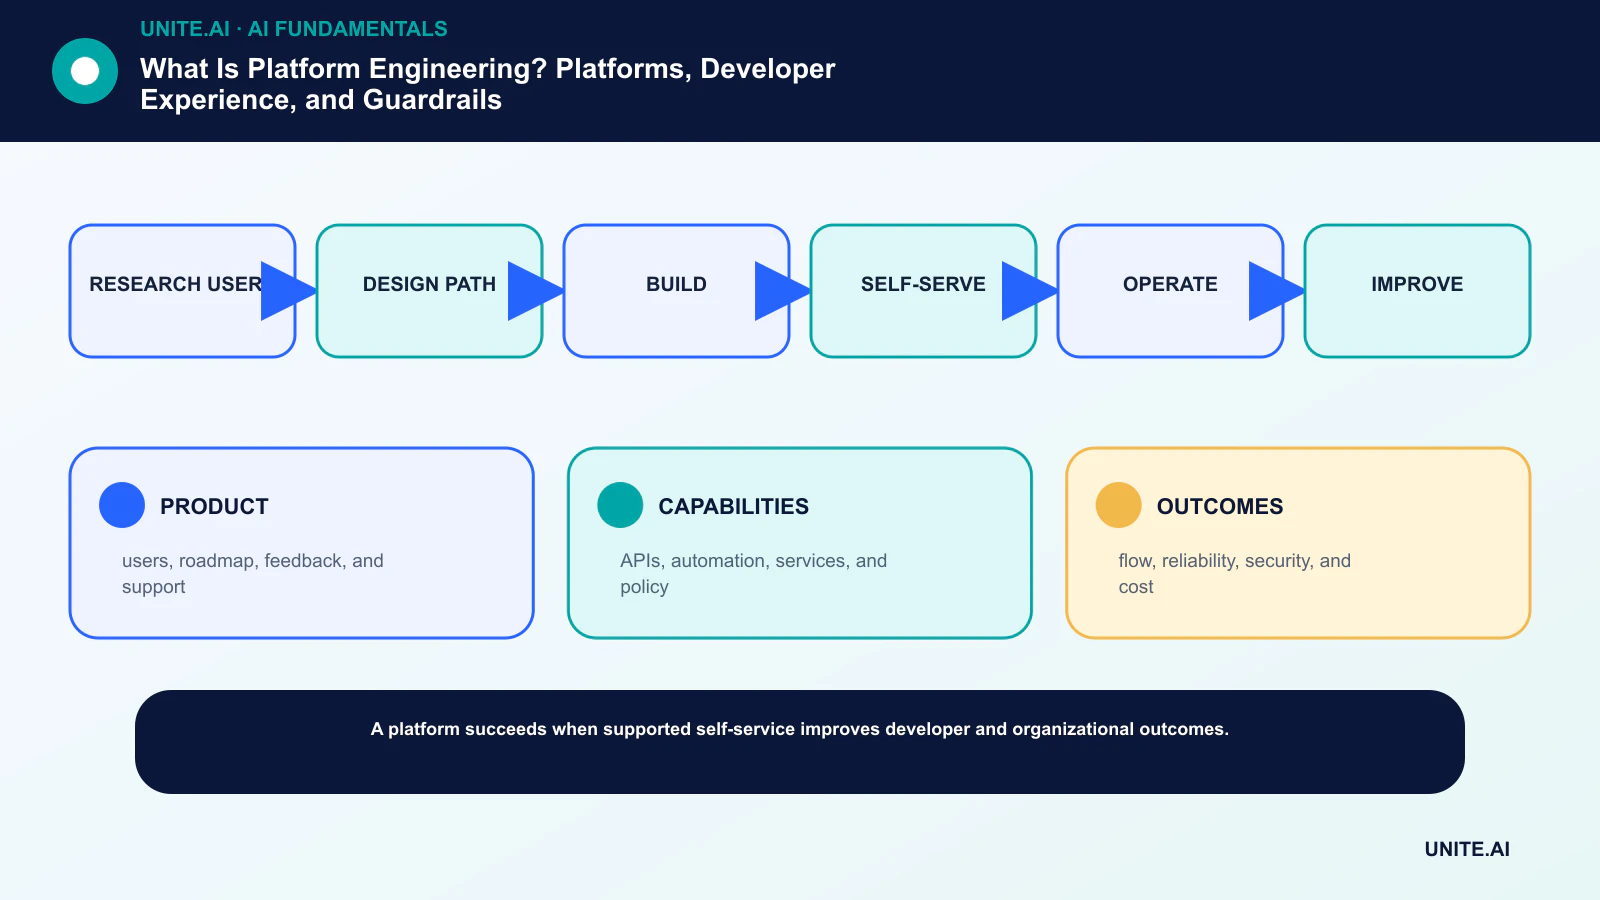
Trasforma il concetto in un flusso di lavoro limitato e verificabile: ricerca utenti → progettazione percorso → costruzione → self‑service → operatività → miglioramento. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare l’ambito. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, esegui una revisione di readiness documentata con le persone che costruiscono, operano, mettono in sicurezza e sono interessate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi irrisolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione dopo l’arrivo dei dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- PRODOTTO: utenti, roadmap, feedback e supporto.
- CAPACITÀ: API, automazione, servizi e policy.
- RISULTATI: flusso, affidabilità, sicurezza e costi.
Domande frequenti
L’ingegneria delle piattaforme sta sostituendo DevOps?
No. L’ingegneria delle piattaforme è un modo per scalare i principi DevOps fornendo prodotti condivisi e capacità self‑service. La collaborazione e la proprietà del servizio rimangono fondamentali.
Un portale di sviluppo interno è la piattaforma?
Di solito no. Un portale è un’interfaccia. La piattaforma include anche API, automazione, infrastruttura, policy, servizi, documentazione, supporto e proprietà operativa.
Riferimenti principali











