
Fondamenti di IA
Cos’è AIOps? Intelligenza artificiale per le operazioni IT

 Aggiungi Unite.AI alle tue fonti preferite su Google
AIOps applica l’apprendimento automatico e l’automazione ai dati delle operazioni IT affinché i team possano rilevare comportamenti anomali, ridurre gli avvisi duplicati, collegare eventi correlati, classificare le cause probabili e raccomandare o eseguire azioni di risposta.
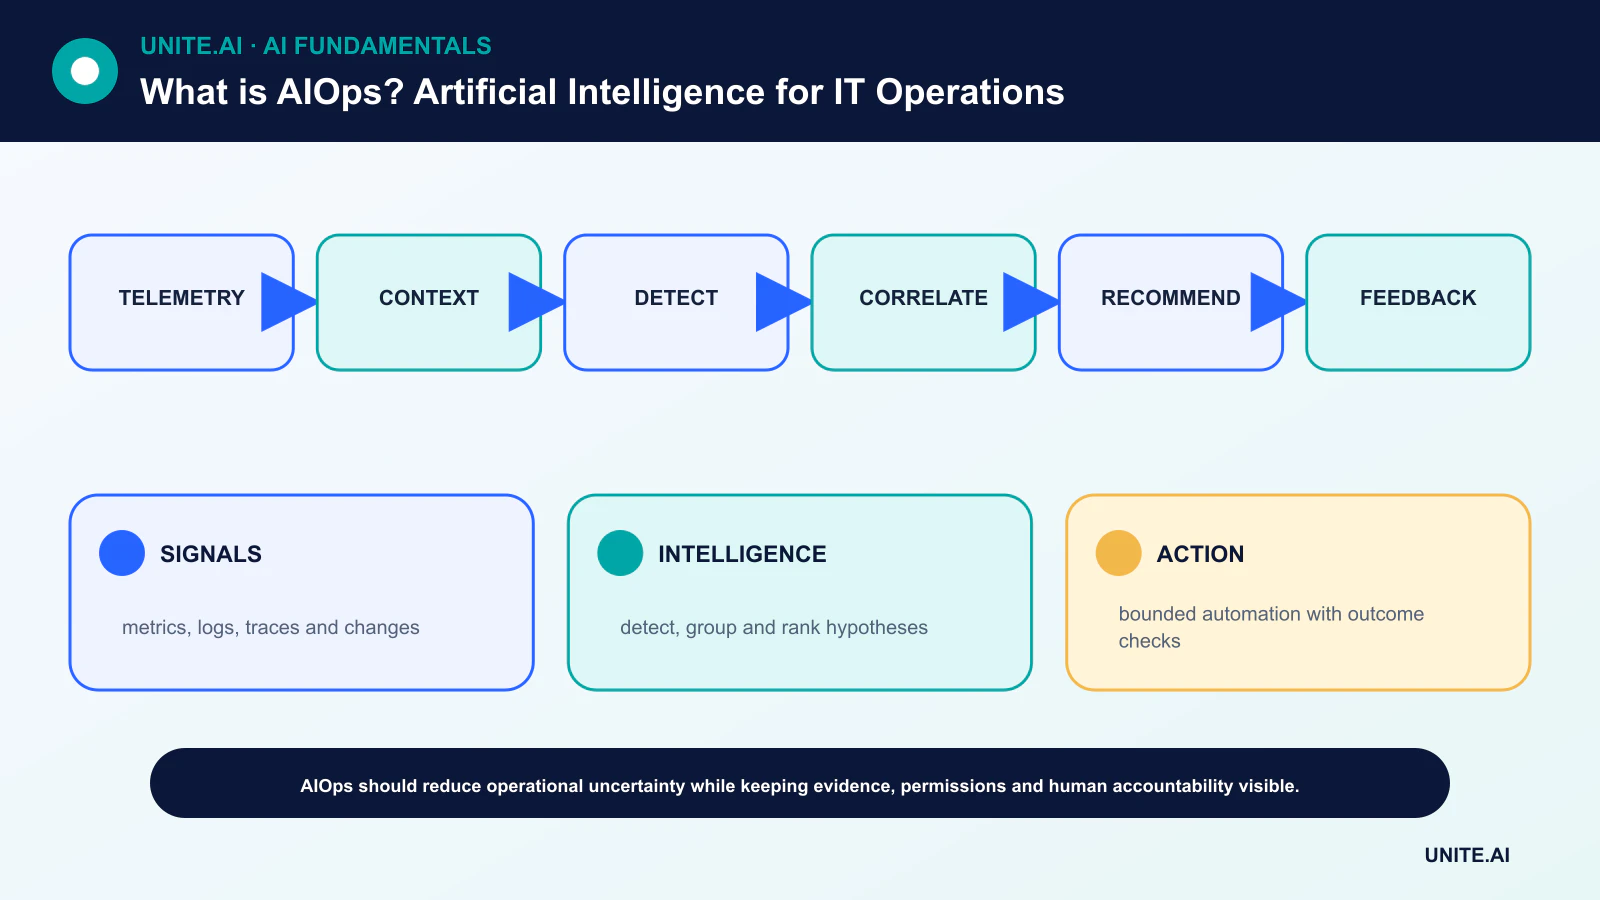
AIOps non è una sostituzione autonoma delle operazioni. È uno strato all’interno di un sistema ITOps, e il suo valore dipende dalla qualità della telemetria, dalla topologia dei servizi, dalla cronologia delle modifiche, dal feedback umano e dai limiti di automazione sicura.
Punti chiave
- Normalizzare gli eventi e aggiungere il contesto del servizio prima di applicare modelli sofisticati.
- Il rilevamento delle anomalie identifica deviazioni, non necessariamente guasti o cause radice.
- La correlazione e la classificazione delle cause probabili dovrebbero mostrare le evidenze e l’incertezza.
- La rimedio automatizzato richiede il principio del minimo privilegio, approvazioni, canarini, rollback e monitoraggio dei risultati.
Costruire uno strato di dati operativi
Le piattaforme AIOps acquisiscono metriche, log, tracce, avvisi, ticket, topologia, distribuzioni e modifiche di configurazione. Timestamp, identificatori e proprietà del servizio devono essere riconciliati affinché il sistema possa collegare i segnali che si riferiscono allo stesso incidente.
Contesti mancanti o incoerenti causano correlazioni false. Anche la conservazione dei dati, l’accesso e la privacy sono importanti perché i log possono contenere credenziali o informazioni personali. Applicare la stessa governance prevista per gli altri sistemi di dati di produzione.
Rilevamento e riduzione del rumore
Soglie statiche funzionano per limiti noti; metodi statistici e di machine-learning possono modellare la stagionalità o pattern multivariati. La deduplicazione raggruppa notifiche ripetute, mentre la soppressione elimina gli avvisi non azionabili secondo regole definite.
Un’anomalia è solo una deviazione dal comportamento atteso. Rilasci pianificati, campagne di traffico e cicli di business possono essere insoliti ma sani. Valutare precisione, richiamo, ritardo di rilevamento e carico di lavoro dell’operatore invece di celebrare il numero di avvisi rimossi.
Correlazione e causa probabile
La correlazione degli eventi collega i sintomi attraverso un grafo di dipendenze e una finestra temporale. Un modello di causa probabile può classificare componenti o modifiche recenti che potrebbero spiegare l’incidente. Questo priorizza l’indagine; non stabilisce causalità.
Mostrare le evidenze contributive, le ipotesi alternative e la confidenza. Explainable AI è particolarmente importante quando un operatore deve decidere se isolare un servizio o effettuare il rollback di una distribuzione.
Da raccomandazione ad automazione
Un runbook può raccogliere diagnostica, riavviare un worker senza stato o aumentare la capacità. I copiloti possono sintetizzare gli incidenti e recuperare le procedure. Gli agenti possono pianificare chiamate a strumenti, ma le autorizzazioni di produzione devono essere ristrette e le azioni validate rispetto allo stato attuale.
Iniziare con raccomandazioni in sola lettura. Promuovere azioni mature tramite simulazione, approvazione umana, canarini e rollback automatico. Registrare gli input, la versione del modello, l’autorizzazione e il risultato per ogni azione.
Valutazione e feedback operativo
Riprodurre incidenti storici senza far trapelare le loro etichette finali nelle caratteristiche. Testare su nuovi servizi e modifiche, misurare soppressioni false, tempo di rilevamento, tempo di mitigazione, accettazione da parte dell’operatore e ricorrenza. Confrontare con regole esistenti e baseline semplici.
Il drift si verifica quando l’architettura, il traffico o le pratiche di risposta cambiano. Chiudere il ciclo consentendo agli operatori di correggere correlazioni e risultati, quindi verificare se il sistema riduce il lavoro manuale senza nascondere rischi o creare compiacenza nell’automazione.
Pipeline dati e analitica AIOps
AIOps applica metodi statistici e di machine‑learning ai dati operativi come metriche, log, tracce, eventi, topologia, ticket e modifiche. La pipeline raccoglie e normalizza i segnali, li arricchisce con il contesto di servizio e di proprietà, rileva anomalie, correla eventi correlati, stima le cause probabili e raccomanda o attiva azioni. La qualità dipende da timestamp, identificatori, topologia e registri delle modifiche. Un modello sofisticato non può correlare in modo affidabile gli avvisi che si riferiscono allo stesso servizio con nomi incoerenti.
Il rilevamento delle anomalie apprende baseline per servizio, stagione e stato operativo; soglie statiche possono essere più adatte per limiti di sicurezza noti. La correlazione degli eventi raggruppa i sintomi in un incidente usando tempo, topologia, testo e pattern storici. La classificazione delle cause radice propone ipotesi ma può confondere il primo guasto osservato con la vera causa o perdere una dipendenza condivisa assente dalla topologia. Riassunti in linguaggio naturale possono assistere i responder, ma devono collegarsi alle evidenze grezze e indicare l’incertezza.
Automazione, valutazione e feedback
Iniziare con supporto decisionale e rimedio reversibile a basso rischio. Ogni azione automatizzata richiede autorizzazione, precondizioni, ambito limitato, timeout, verifica delle postcondizioni, rollback e tracciatura di audit. Il modello non deve concedersi credenziali né trattare il testo dei log come istruzioni affidabili. I responder umani dovrebbero accettare, rifiutare o correggere le raccomandazioni, e tali risultati dovrebbero aggiornare regole o dati di addestramento tramite revisione anziché apprendimento autonomo incontrollato.
Valutare la riduzione degli avvisi senza perdere incidenti, tempo di anticipo del rilevamento, precisione della correlazione, classificazione delle cause radice, successo della rimedio, tempo di recupero, ricorrenza e carico di lavoro del responder. Utilizzare replay storici e fault iniettati, ma tenere conto di etichette di incidente incomplete. Misurare per servizio e tipo di incidente; una media può nascondere guasti pericolosi in sistemi critici rari. Confrontare con regole deterministiche e osservabilità migliorata prima di aggiungere complessità AI.
Governance e modalità di guasto
AIOps può amplificare le lacune di telemetria, automatizzare una diagnosi errata o creare azioni correlate a livello di flotta. Isolare gli ambienti, limitare la concorrenza, mantenere un interruttore di emergenza al di fuori del modello e simulare il fallimento della piattaforma AIOps stessa. Proteggere log e ticket che contengono segreti o dati personali. Monitorare il drift del modello, la freschezza della topologia, azioni false e override. AIOps supporta operazioni affidabili quando rende più rapide le evidenze e le azioni limitate; non è una sostituzione autonoma della proprietà del servizio, del comando di incidente o del giudizio ingegneristico.
Esempio pratico: AIOps per un incidente di pagamento
AIOps raggruppa un picco di errori API, saturazione del database e avvisi regionali in un unico incidente e lo arricchisce con una distribuzione recente, la topologia e il proprietario. Classifica la distribuzione come probabile contributore ma espone la telemetria grezza e le alternative. Una politica deterministica sospende ulteriori rollout; un comandante umano dell’incidente approva lo spostamento del traffico dopo aver verificato che capacità e coerenza dei dati siano sicuri.
Il sistema misura la precisione del raggruppamento, il tempo di anticipo del rilevamento, l’accuratezza della classificazione, l’accettazione del responder, il recupero e le rimedi errate in replay storici e giornate di simulazione. Tutte le azioni automatizzate hanno limiti, idempotenza, controlli di postcondizione e rollback. I log sono sanificati e il testo malevolo non può diventare un comando. Dopo l’incidente, la causa confermata e i risultati delle azioni aggiornano le regole revisionate e i dati di valutazione. La piattaforma AIOps assiste le evidenze e il coordinamento; non sostituisce mai il comando di incidente o l’autorizzazione esterna.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più probabilmente trascurati. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a tappe, conservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato di salute delle dipendenze, gli override umani e i risultati confermati senza raccogliere dati sensibili non necessari. Definire le soglie di avviso e un responsabile della risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disabilitato o sostituito.
Domande frequenti
AIOps è la stessa cosa dell’osservabilità?
No. L’osservabilità fornisce ed esplora i segnali del sistema; AIOps utilizza analisi e automazione su tali segnali. Ognuno può esistere senza l’altro.
AIOps può determinare automaticamente la causa radice?
Può classificare le ipotesi e raccogliere le evidenze, ma le affermazioni causali richiedono topologia, contesto delle modifiche e validazione. Molti incidenti hanno cause interagenti.
Riferimenti principali












