
Fondamenti di IA
Che cos’è l’automazione degli incidenti? Flussi di lavoro, salvaguardie e casi d’uso

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’automazione degli incidenti utilizza software per rilevare, arricchire, instradare, coordinare e talvolta risolvere incidenti operativi o di sicurezza. Collega i segnali di monitoraggio con runbook, sistemi di ticketing, comunicazioni, controlli di accesso e azioni di recupero, così gli operatori trascorrono meno tempo a copiare dati e più tempo a prendere decisioni.
L’automazione non elimina la responsabilità umana. Un programma sicuro distingue i passaggi deterministici a basso rischio da azioni che possono influire su clienti o produzione, applicando quindi approvazioni, credenziali limitate, tracciamenti di audit, timeout e rollback in base all’impatto.
Punti chiave
- Automatizzare la raccolta ripetibile di evidenze prima di tentare una rimedio autonomo.
- Utilizzare gravità, affidabilità, raggio d’azione e reversibilità per scegliere il livello di approvazione.
- Considerare ogni runbook come codice di produzione versionato, con test e un responsabile.
- Misurare rilevamento, riconoscimento, recupero, ricorrenza e impatto sull’utente, non solo il volume di allerta.
Dal segnale alla risposta coordinata
Un flusso di lavoro può deduplicare gli avvisi, allegare le distribuzioni recenti e i log, identificare il proprietario del servizio, aprire un record di incidente, avvisare il team di turno, creare un canale di comunicazione e avviare una cronologia. Questi passaggi riducono il carico cognitivo senza effettuare una diagnosi rischiosa in modo automatico.
La correlazione deve preservare le evidenze. Se una piattaforma raggruppa i sintomi in modo troppo aggressivo, può nascondere incidenti simultanei. Collega l’automazione alla operazioni IT e conserva i segnali grezzi di cui gli operatori potrebbero aver bisogno.
Scegliere le azioni in base al rischio
Le query in sola lettura, gli snapshot e i cambi di traffico reversibili sono generalmente più facili da automatizzare rispetto all’eliminazione di dati, alla rotazione di credenziali ampie o alla modifica di uno schema di produzione. Definisci precondizioni, timeout di esecuzione, postcondizioni e rollback per ogni azione.
Utilizza identità di servizio con privilegi minimi e separa l’autorizzazione dal motore del flusso di lavoro. I passaggi ad alto impatto dovrebbero richiedere un approvatore identificato. Se AIOps propone una causa o una correzione, gli operatori hanno comunque bisogno di evidenze di supporto e di un modo sicuro per rifiutarla.
Creare runbook affidabili
Un runbook deve dichiarare input, dipendenze, proprietario, ambito, comportamento in caso di errore ed evidenze prodotte. Testalo in staging e durante le giornate di simulazione. I passaggi idempotenti sono preziosi perché il loro ripetuto esecuzione non genera danni aggiuntivi.
Versiona e revisiona l’automazione come qualsiasi altro software. Monitora la scadenza delle credenziali, le modifiche alle API, i limiti di velocità, le esecuzioni parziali e i collegamenti nascosti tra i servizi. Le procedure manuali rimangono necessarie quando la piattaforma di automazione stessa non è disponibile.
Apprendere dopo il recupero
L’automazione dovrebbe conservare un registro con timestamp di segnali, decisioni, azioni, approvazioni e risultati. Una revisione senza colpe può quindi separare le condizioni di sistema che hanno contribuito dal trigger finale e trasformare le lezioni in miglioramenti testati.
Misure utili includono il tempo medio per riconoscere e ripristinare, la percentuale di passaggi sicuri automatizzati, il tasso di azioni fallite, gli incidenti ricorrenti e l’impatto sul cliente. Collega i risultati alla pianificazione DevOps invece di ottimizzare per il numero di ticket chiusi.
Tipi di automazione degli incidenti
L’automazione degli eventi normalizza e arricchisce i segnali in ingresso. L’automazione di coordinamento crea un record di incidente, avvisa i proprietari, apre canali di comunicazione e pubblica aggiornamenti di stato. L’automazione diagnostica esegue query in sola lettura o cattura snapshot. L’automazione di rimedio modifica lo stato del sistema, mentre l’automazione di recupero verifica la salute del servizio e chiude le mitigazioni temporanee.
Queste categorie non dovrebbero condividere lo stesso livello di fiducia predefinito. L’arricchimento può spesso essere eseguito automaticamente; un failover di produzione può richiedere controlli di fiducia e un approvatore; il ripristino dei dati solitamente necessita di un comandante dell’incidente e del proprietario dell’applicazione. Il controllo deve seguire l’impatto potenziale, non se il passaggio è implementato da una regola o da un modello di machine learning.
Gli incidenti di sicurezza aggiungono requisiti di conservazione delle evidenze. L’automazione deve evitare di modificare un host compromesso prima che i dati volatili siano catturati, di esporre indicatori sensibili in canali pubblici o di isolare infrastrutture condivise senza comprendere il raggio d’azione. I runbook operativi e forensi possono sovrapporsi, ma il loro ordine può differire.
Progettazione del flusso di lavoro e piano di controllo
Modella il runbook come stati espliciti con precondizioni e risultati terminali. Ogni azione dovrebbe segnalare avvio, successo, fallimento, timeout o salto, insieme a un identificatore di esecuzione immutabile. Un orchestratore centrale può coordinare i passaggi, ma i servizi a valle devono applicare la propria autorizzazione e convalidare gli input in modo indipendente.
Utilizza credenziali limitate e a breve durata e restringi i percorsi di rete dal motore di automazione. Separa gli ambienti di sviluppo, test e produzione. I segreti non devono apparire nei transcript delle chat o nei log. Per azioni ad alto impatto, richiedi l’approvazione di due persone o un ruolo di emergenza la cui attivazione genera immediatamente una traccia di revisione.
Progetta per il fallimento parziale. Un ticket può essere creato mentre l’avviso fallisce; uno spostamento di traffico può riuscire in una regione e scadere in un’altra. Azioni compensative, job di riconciliazione e una chiara assegnazione di responsabilità impediscono che il flusso di lavoro segnali successo solo perché il processo di orchestrazione è terminato.
Esempi, test e maturità
Un caso d’uso maturo è l’esaurimento delle connessioni al database: raccogli metriche del pool, distribuzioni recenti, query lente e informazioni sul proprietario; apri un incidente; proponi un’azione di scaling o di spostamento del traffico reversibile; richiedi approvazione; poi verifica tasso di errore e latenza. Lo stesso schema può servire per scadenza di certificati, pressione su disco, job falliti o attività sospette di account.
Testa i runbook con test unitari, API simulate, incidenti in staging, giornate di simulazione e drill di produzione controllati. Inietta dati obsoleti, negazioni di permessi, dipendenze lente, eventi duplicati e incidenti conflittuali. Conferma che i retry siano sicuri e che gli operatori possano prendere il controllo manuale senza scontrarsi con l’automazione.
La maturità avanza da notifica, a arricchimento, a azioni guidate, a auto-rimedi limitati. L’avanzamento dovrebbe dipendere dalle evidenze: diagnosi stabile, bassi tassi di azioni fallite, rollback verificato e chiaro beneficio per l’utente. La chiusura autonoma dovrebbe rimanere rara finché il sistema non dimostra il recupero e conserva sufficienti evidenze per l’apprendimento futuro.
Esempio pratico: automatizzare un incidente di servizio di produzione
Consideriamo un’API di pagamento il cui tasso di errore aumenta dopo una distribuzione. Il monitoraggio genera un avviso strutturato contenente servizio, ambiente, regione, versione, budget di errore e link al runbook. L’automazione lo arricchisce con il record di modifica, lo stato di salute delle dipendenze, i log recenti e il proprietario, poi raggruppa gli avvisi duplicati in un unico incidente. Una politica deterministica può mettere in pausa ulteriori rollout immediatamente; un rollback dovrebbe richiedere evidenze che la nuova versione sia la causa e che il rollback sia sicuro.
Il flusso di lavoro assegna un comandante dell’incidente, apre canali di comunicazione, registra una cronologia e suggerisce passaggi diagnostici. La rimedio automatizzato inizia con azioni a basso rischio e reversibili, come lo spostamento del traffico verso un’istanza sana. Ogni azione necessita di autorizzazione, limiti di concorrenza, timeout, postcondizioni verificate e rollback. Riassunti generativi possono assistere gli operatori, ma la telemetria di origine e i comandi rimangono visibili così il team può contestare una narrazione errata.
Misura il tempo per rilevare, riconoscere, mitigare e recuperare; il volume di avvisi; la soppressione dei duplicati; il successo della rimedio; la ricorrenza; e i danni causati dall’automazione. Esegui giornate di simulazione per credenziali scadute, regioni parziali, avvisi fuorvianti e rollback falliti. Dopo il recupero, conserva la cronologia fattuale, identifica le condizioni tecniche e organizzative contributive, aggiorna i runbook e i test, e traccia il lavoro correttivo fino al completamento anziché considerare una mitigazione rapida come la fine del lavoro di affidabilità.
Checklist di implementazione pratica
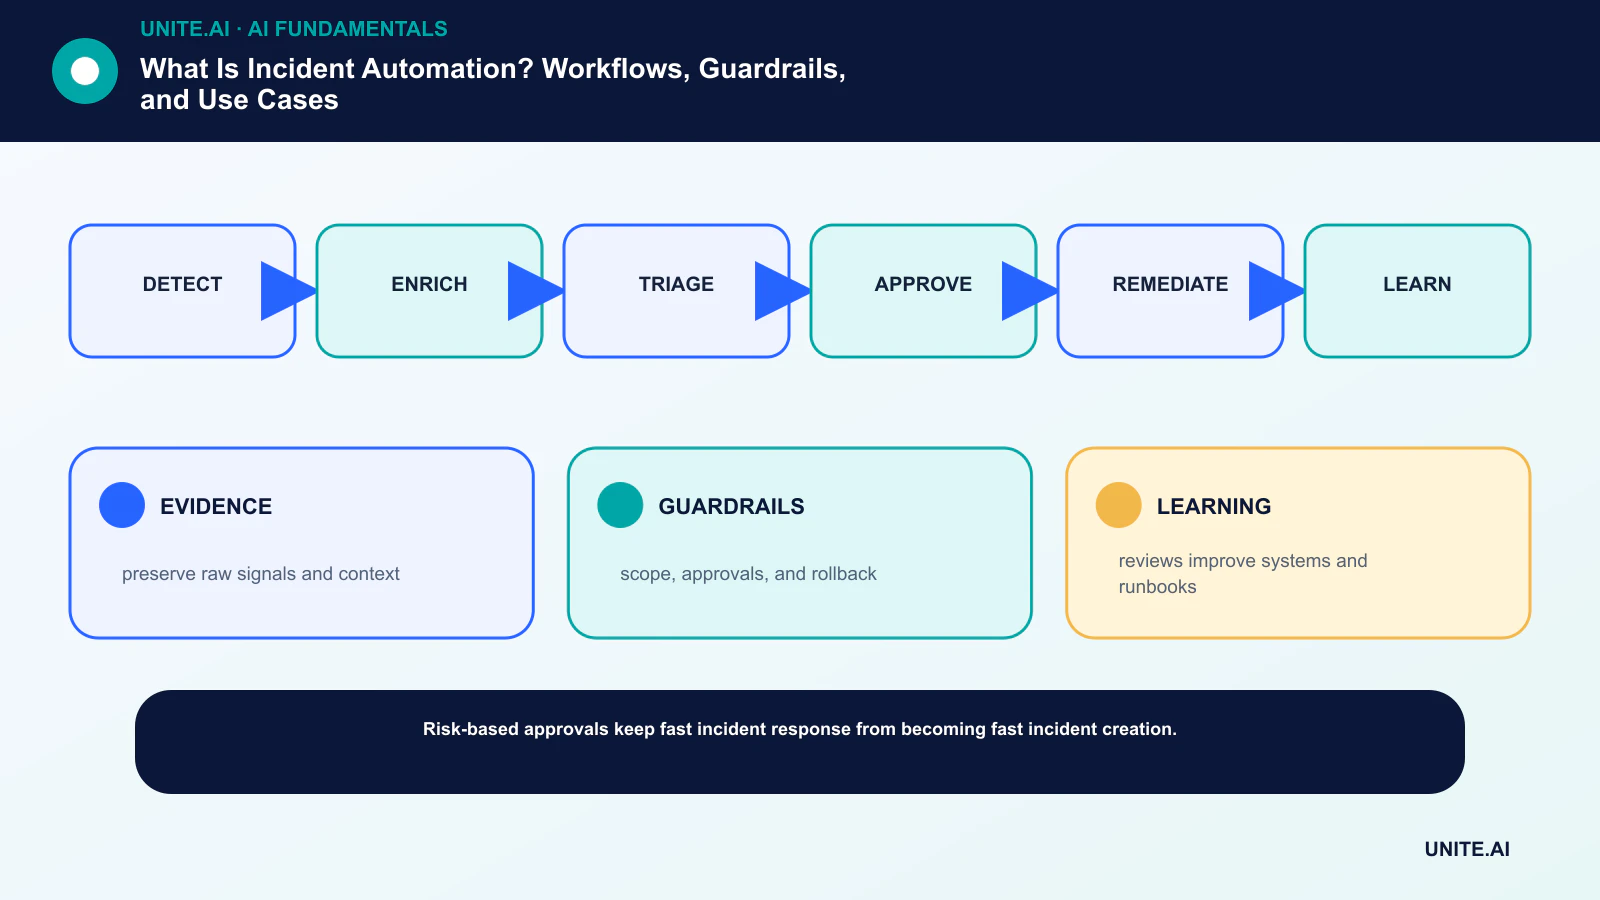
Trasforma il concetto in un flusso di lavoro limitato e testabile: rileva → arricchisci → triage → approva → rimedia → apprendi. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa i fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare l’ambito. Registra versioni e ipotesi così un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, proteggono e sono interessate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Rivedi la decisione dopo l’arrivo dei dati reali, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- EVIDENZA: conservare segnali grezzi e contesto.
- SALVAGUARDIE: ambito, approvazioni e rollback.
- APPRENDIMENTO: le revisioni migliorano sistemi e runbook.
Domande frequenti
L’automazione degli incidenti è la stessa di AIOps?
No. AIOps applica analisi o apprendimento automatico ai dati operativi. L’automazione degli incidenti è il livello più ampio di esecuzione e coordinamento; può utilizzare regole semplici, output di AIOps o entrambi.
Cosa dovrebbe essere automatizzato per primo?
Inizia con passaggi ad alta frequenza, a basso rischio e ben compresi, come l’arricchimento, la ricerca del proprietario, la cattura delle evidenze, gli aggiornamenti di stato e le diagnosi reversibili.
Riferimenti principali











