Fondamenti di IA
Che cosa sono le operazioni IT (ITOps)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
IT operations (ITOps) è il lavoro di gestire i servizi tecnologici da cui un’organizzazione dipende. Copre calcolo, reti, identità, endpoint, piattaforme cloud, database, storage, backup e i processi operativi che mantengono questi componenti disponibili, sicuri e gestibili.
Le moderne ITOps non si limitano a un centro operativo di rete che osserva dashboard. I team gestiscono sempre più infrastrutture definite dal software, servizi di piattaforma, automazione e proprietà distribuita, mantenendo la responsabilità per incidenti, capacità, continuità e livelli di servizio.
Punti chiave
- Le ITOps gestiscono servizi e le loro dipendenze tra ambienti on‑premise, cloud ed edge.
- Osservabilità, configurazione e inventario forniscono il contesto necessario per interpretare i guasti.
- La gestione degli incidenti ripristina il servizio; la gestione dei problemi affronta cause ricorrenti o sistemiche.
- Le ITOps si sovrappongono a ITSM, SRE, DevOps, SecOps e AIOps ma non sono identiche a nessuna di esse.
Servizi, asset e configurazione
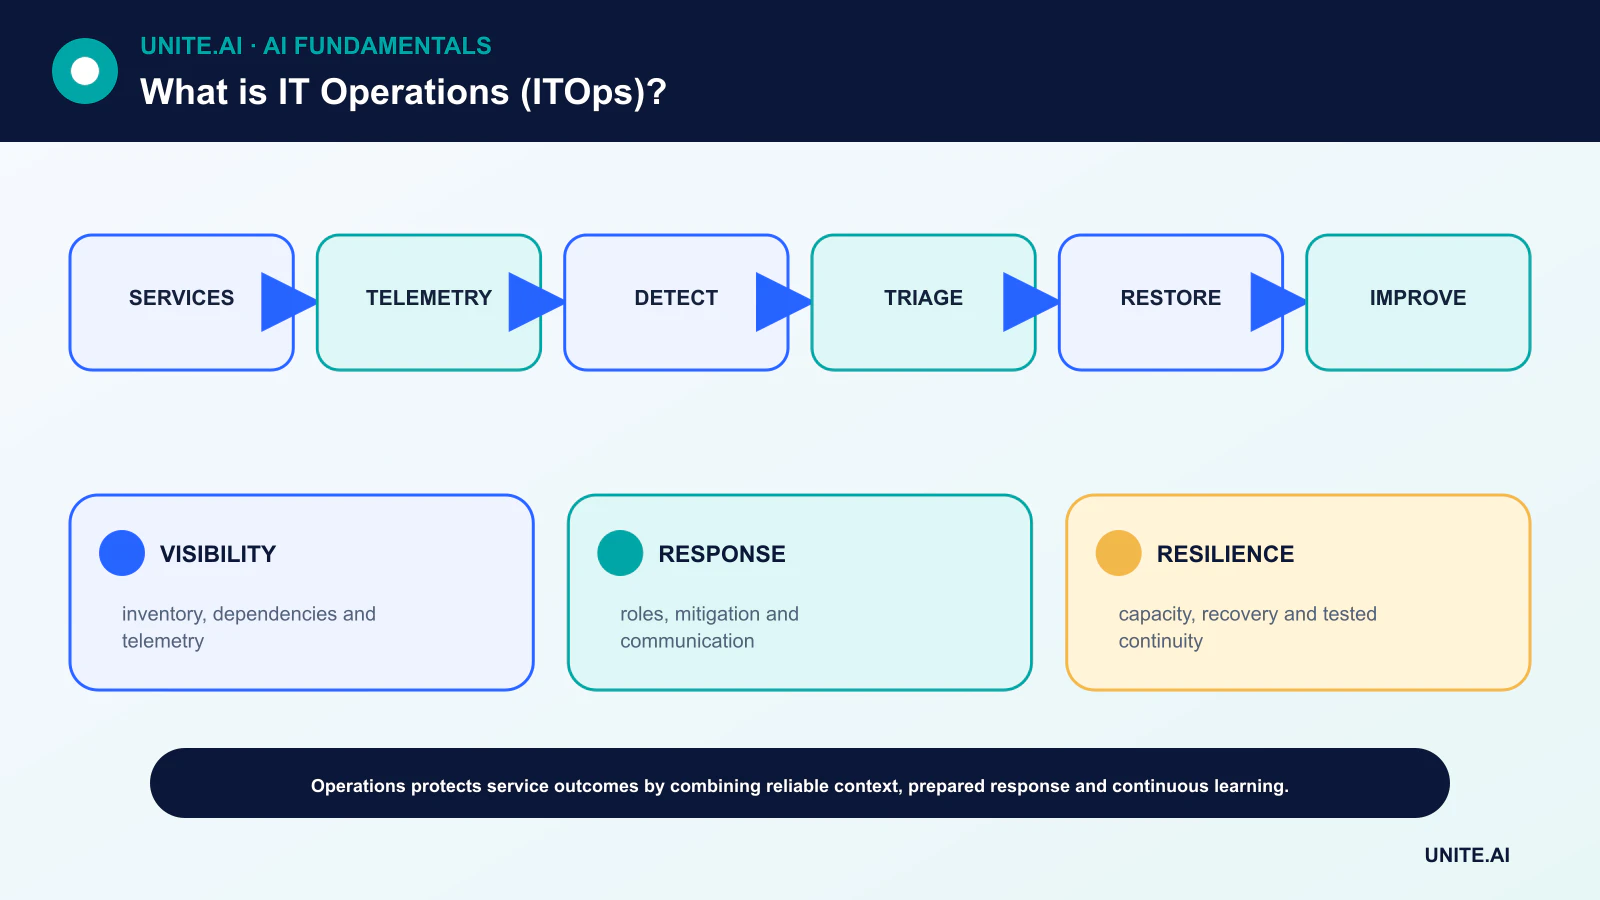
Le operazioni iniziano conoscendo quali servizi esistono, chi ne è responsabile, quali utenti ne dipendono e quale infrastruttura li supporta. L’inventario degli asset registra i componenti; la gestione della configurazione registra le relazioni rilevanti e lo stato controllato.
Un inventario mai riconciliato diventa fuorviante. Automatizzate la scoperta dove utile, identificate le fonti autorevoli e registrate il livello di confidenza o freschezza invece di fingere che ogni mappa delle dipendenze sia completa.
Osservabilità e obiettivi di servizio
Le metriche quantificano il comportamento, i log registrano gli eventi e i trace seguono il lavoro tra i servizi. I controlli sintetici possono testare un percorso utente. Un’osservabilità utile parte da domande e obiettivi di servizio, per poi raccogliere i segnali necessari a rispondere.
Gli avvisi dovrebbero identificare condizioni che richiedono azioni tempestive. Soglie senza impatto sull’utente generano rumore, mentre la mancanza di contesto sulle dipendenze rallenta la diagnosi. AIOps può aiutare nella correlazione, ma ha bisogno di telemetria affidabile e feedback operativo.
Gestione di incidenti, problemi e cambiamenti
La gestione degli incidenti coordina rilevamento, triage, mitigazione, comunicazione e ripristino. Ruoli chiari riducono la confusione sotto pressione. Una soluzione temporanea può ripristinare il servizio mentre un’indagine successiva sul problema affronta cause più profonde.
La gestione dei cambiamenti valuta e registra il rischio senza trasformare ogni modifica in una coda. Cambiamenti standard, automatizzati e a basso rischio possono seguire percorsi pre‑approvati; i cambiamenti ad alto impatto richiedono prove più solide, programmazione e preparazione al rollback.
Capacità, resilienza e continuità
I team prevedono la domanda di risorse, rimuovono colli di bottiglia e testano il comportamento sotto carico. I backup sono utili solo quando il ripristino è verificato. La ridondanza è efficace solo quando i modi di guasto sono indipendenti e il failover funziona realmente.
La continuità operativa definisce priorità, tempi di recupero e perdita di dati accettabile. Le dipendenze da identità, DNS, piani di controllo cloud e fornitori devono essere incluse negli esercizi anziché essere date per scontate.
ITOps, ITSM, SRE e DevOps
La gestione dei servizi IT fornisce processi per allineare i servizi alle esigenze organizzative. L’ingegneria dell’affidabilità del sito applica l’ingegneria del software alle operazioni e utilizza obiettivi di livello di servizio e budget di errore. DevOps unisce feedback di sviluppo e operazioni.
SecOps si concentra su minacce e risposta, mentre ITOps mantiene una salute più ampia del servizio. Gli organigrammi differiscono; il requisito importante è la proprietà esplicita e la condivisione delle evidenze tra queste discipline.
Il modello operativo ITOps
Le operazioni IT mantengono i servizi tecnologici dell’organizzazione disponibili, performanti, sicuri e recuperabili. L’ambito comprende tipicamente endpoint, identità, reti, server, cloud, storage, collaborazione, database, monitoraggio, service desk, backup e servizi dei fornitori. Le ITOps moderne coprono infrastrutture di proprietà e piattaforme gestite, quindi la responsabilità deve essere esplicita anche quando l’operatività è esternalizzata. Un inventario di configurazione o di servizi collega componenti tecnici a proprietari, utenti, dipendenze, classificazione dei dati e criticità di business.
La gestione dei servizi organizza incidenti, richieste, problemi, cambiamenti, asset, conoscenza e livelli di servizio. La gestione degli incidenti ripristina il servizio; la gestione dei problemi indaga cause ricorrenti; l’abilitazione dei cambiamenti valuta e coordina il rischio. Trattare ogni cambiamento come una lenta approvazione crea bypass, mentre l’automazione non governata genera guasti incontrollati. I cambiamenti a basso rischio standard possono essere pre‑autorizzati e automatizzati; i cambiamenti ad alto rischio necessitano di evidenze, comunicazione, rollback e programmazione basata sull’impatto.
Affidabilità, capacità e continuità
Il monitoraggio dovrebbe seguire i servizi rivolti all’utente e le dipendenze, non solo il conteggio dei dispositivi. Definite disponibilità, latenza, capacità, freschezza e obiettivi di supporto con i responsabili di business. Allertate sui sintomi azionabili e sul consumo del budget di errore; arricchite gli eventi con informazioni su proprietà e cambiamenti recenti. I modelli di pianificazione della capacità considerano domanda, saturazione, licenze e tempi di consegna. L’elasticità del cloud riduce i ritardi di provisioning ma non elimina quote, limiti regionali o controlli di costo.
La continuità operativa richiede backup testati, ripristino, recupero dell’identità, alternative di rete, contatti dei fornitori e procedure manuali. Definite obiettivi di tempo di recupero (RTO) e punto di recupero (RPO) per servizio. Un backup non è prova di recupero finché non è stato ripristinato e validato. Esercitate scenari di ransomware, perdita di regione, certificati scaduti, interruzione dell’identità e guasto del fornitore. Tracciate configurazione e infrastruttura come codice dove possibile così il recupero sia riproducibile.
Sicurezza, automazione e metriche
Utilizzate il principio del minimo privilegio, gestione di patch e vulnerabilità, controlli endpoint, segmentazione di rete, logging e risposta agli incidenti. Automatizzate i compiti ripetitivi con idempotenza, limiti, approvazioni e audit. Misurate disponibilità del servizio, ricorrenza di incidenti, adempimento delle richieste, fallimento dei cambiamenti, tempi di recupero, esposizione alle patch, capacità, costo e soddisfazione degli utenti — non solo la chiusura dei ticket. Le ITOps hanno successo quando la tecnologia supporta il lavoro in modo prevedibile e può riprendersi da un guasto, non quando l’infrastruttura appare occupata o le dashboard mostrano solo indicatori verdi.
Esempio pratico: recupero di un servizio di collaborazione
Un’azienda definisce un obiettivo di tempo di recupero di quattro ore e un obiettivo di punto di recupero di un’ora per una piattaforma di collaborazione. Inventaria identità, DNS, rete, dati, chiavi, configurazione, integrazioni e dipendenze dei fornitori. Un esercizio di recupero parte dal presupposto che la regione primaria e l’account amministratore non siano disponibili. Gli operatori attivano un’identità di emergenza protetta indipendentemente, ripristinano la configurazione del servizio e i dati in una regione isolata e convalidano permessi, messaggi, integrazioni e accesso client. I responsabili di business verificano il servizio ripristinato con percorsi utente realistici anziché basarsi solo su controlli di salute dell’infrastruttura.
L’esercizio registra perdita effettiva di dati, tempo trascorso, passaggi manuali, contatti falliti e dipendenze nascoste. Un backup che ripristina file ma non chiavi di cifratura o policy di identità viene segnalato come incompleto. Le azioni correttive ricevono proprietari e date, e il runbook viene aggiornato e ritestato. Vengono inclusi template di monitoraggio e comunicazione. L’organizzazione misura le evidenze di recupero anziché il successo del job di backup, riconoscendo che le ITOps affidabili devono ripristinare il servizio di cui gli utenti hanno bisogno in condizioni di guasto realistiche.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione riuscita. Definite gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni fallimento importante. Stabilite una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testate casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurate la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrate ogni trasformazione e soglia così un revisore indipendente può riprodurre il risultato e distinguere le evidenze da un prototipo accattivante.
Prima del lancio, assegnate l’autorità per rilascio, eccezioni, cambiamenti, rollback e dismissione. Utilizzate un rollout a fasi, conservate un fallback sicuro e verificate il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare qualità dell’input, comportamento dell’output, versione del modello o della regola, salute delle dipendenze, override umani e risultati confermati senza raccogliere dati sensibili non necessari. Definite soglie di allerta e un responsabile di risposta, poi esaminate le evidenze reali dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutate ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Qual è l’obiettivo principale delle ITOps?
Fornire e ripristinare servizi tecnologici affidabili entro i vincoli concordati di sicurezza, prestazioni, continuità e costi.
L’infrastruttura cloud è gestita interamente dal provider cloud?
No. I provider gestiscono parti della piattaforma sottostante, mentre i clienti rimangono responsabili di configurazione, identità, dati, carichi di lavoro, monitoraggio e molte decisioni a livello di servizio.
Riferimenti principali