
Fondamenti di IA
Cos’è la Gestione delle Prestazioni degli Asset (APM)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
La gestione delle prestazioni degli asset (APM) combina la strategia degli asset, la manutenzione, il monitoraggio delle condizioni, l’analisi dell’affidabilità e i dati operativi per migliorare il valore fornito dagli asset fisici. È comunemente utilizzata per apparecchiature come turbine, pompe, veicoli, linee di produzione e infrastrutture.
L’APM non è un cruscotto di sensori né un modello di manutenzione predittiva di per sé. È un processo decisionale che bilancia prestazioni, costi, rischi, sicurezza e sostenibilità lungo l’intero ciclo di vita dell’asset, con una chiara responsabilità per ispezioni, lavori, ricambi e pianificazione del capitale.
Punti chiave
- Iniziare con la criticità e le conseguenze dei guasti, non con il sensore più facile da raccogliere.
- Combinare i dati di condizione con la storia della manutenzione, il contesto operativo e la conoscenza ingegneristica.
- Utilizzare segnali predittivi per supportare una decisione di lavoro definita e un requisito di tempo di anticipo.
- Misurare il rischio evitato, la disponibilità, la qualità della manutenzione, il costo del ciclo di vita e i falsi allarmi.
Dalla strategia dell’asset al lavoro
Le organizzazioni definiscono obiettivi, gerarchie degli asset, criticità, standard di prestazione, modalità di guasto e strategie di manutenzione. Un sistema di gestione del lavoro programma ispezioni e riparazioni; le analisi APM aiutano a dare priorità a quando e perché il lavoro dovrebbe avvenire.
La stessa condizione può implicare azioni diverse per una pompa a basso costo ridondante e per una turbina critica per la sicurezza. L’APM collega le evidenze tecniche al contesto aziendale e di sicurezza anziché ottimizzare un singolo punteggio predittivo.
Dati e rappresentazioni digitali
Le fonti utili includono serie temporali dei sensori, allarmi, giri di operatori, note di manutenzione, ricambi, ambiente, carichi e limiti di progetto. Gli identificatori degli asset e i timestamp devono essere allineati prima dell’analisi. Sensori mancanti, fuori calibrazione o sostituiti possono generare tendenze false.
Un gemello digitale può combinare modelli ingegneristici e stato in tempo reale, ma necessita di assunzioni validate e regole di aggiornamento. Le note tecniche non strutturate possono aggiungere contesto che la telemetria non possiede.
Condizione, previsione e decisione
Le soglie rilevano limiti noti; i modelli di anomalia segnalano deviazioni; i modelli diagnostici stimano le cause; i modelli prognostici stimano la vita utile residua. Ognuno richiede un orizzonte temporale e un’incertezza adeguati alla decisione di manutenzione.
Un modello che prevede un guasto cinque minuti prima che si verifichi può essere accurato ma operativamente inutile se i ricambi richiedono una settimana. Il apprendimento automatico dovrebbe essere confrontato con regole e metodi di affidabilità e testato su diversi regimi operativi.
Implementazione e misurazione
Iniziare con una classe di asset critica, una modalità di guasto credibile, un tempo di anticipo disponibile e un responsabile in grado di agire. Integrare le raccomandazioni nella pianificazione, negli ordini di lavoro e nell’inventario; raccogliere i risultati affinché la regola o il modello possano essere rivisti.
Monitorare disponibilità, tempi di inattività non programmati, costi di manutenzione, rispetto del programma, falsi allarmi, eventi mancati, esposizione alla sicurezza e valore del ciclo di vita. Evitare di affermare fallimenti evitati senza un metodo controfattuale e assunzioni documentate.
Gerarchia degli asset, comportamento dei guasti e criticità
Un programma APM inizia con una gerarchia degli asset che collega siti, sistemi, apparecchiature, assemblaggi e componenti manutenibili. Ogni livello richiede identificatori coerenti, proprietà, ubicazione, specifiche e relazioni. Senza questa base, i flussi dei sensori, gli ordini di lavoro, i risultati delle ispezioni e i registri dei costi non possono descrivere in modo affidabile lo stesso asset fisico.
Le modalità di guasto spiegano come un asset può smettere di soddisfare la sua funzione richiesta, perché si verifica il guasto, quale evidenza appare per prima e quale conseguenza ne segue. L’analisi delle modalità di guasto e dei loro effetti, la manutenzione basata sull’affidabilità e l’analisi delle cause radice trasformano la manutenzione da un’attività calendario a una disciplina informata dal rischio. L’analisi dovrebbe distinguere i sintomi dai meccanismi causali.
La criticità combina probabilità e conseguenze per sicurezza, ambiente, produzione, qualità, conformità e costi. Una pompa ridondante che serve un circuito non essenziale non dovrebbe ricevere lo stesso budget di monitoraggio di un compressore a punto unico di guasto. La criticità varia con il contesto operativo, quindi i team dovrebbero rivedere le classifiche dopo cambiamenti di processo, asset o domanda.
Monitoraggio delle condizioni, previsione e decisioni di manutenzione
Il monitoraggio delle condizioni può utilizzare vibrazioni, temperatura, pressione, corrente, emissione acustica, analisi del lubrificante, ispezioni visive e osservazioni degli operatori. La frequenza di campionamento deve corrispondere alla fisica del guasto. Vibrazioni ad alta frequenza dei cuscinetti e corrosione a lento drift richiedono sensori, archiviazione, caratteristiche e logiche di allarme differenti. La calibrazione e la qualità dell’installazione fanno parte della qualità dei dati.
I modelli predittivi possono rilevare anomalie, classificare guasti noti, stimare indicatori di salute o prevedere la vita utile residua. Un segnale statisticamente anomalo non è automaticamente un guasto azionabile. I modelli necessitano di contesto dello stato operativo, incertezza, valutazione del tempo di anticipo e validazione su apparecchiature, stagioni, carichi ed eventi di manutenzione. I falsi allarmi consumano fiducia e manodopera; le rilevazioni mancate possono generare perdite gravi.
L’output delle analisi deve collegarsi a una decisione: ispezionare, lubrificare, ridurre la capacità, programmare il lavoro, ordinare un ricambio o arrestare l’impianto. Le soglie decisionali dovrebbero riflettere le conseguenze del guasto, il tempo di anticipo dell’intervento, la capacità della forza lavoro, i ricambi e le finestre di produzione. La soglia economicamente ottimale raramente è quella che massimizza una metrica generica del modello.
Integrazione dell’APM, misurazione del valore e governance
L’APM collega la tecnologia operativa con sistemi aziendali come la gestione informatizzata della manutenzione, la gestione degli asset aziendali, gli storici, l’inventario e la pianificazione. L’integrazione dovrebbe preservare timestamp, unità, identità dell’asset, stato del lavoro e provenienza. La segmentazione della rete e i gateway controllati sono essenziali perché la comodità diagnostica non deve creare un percorso verso i sistemi di controllo critici per la sicurezza.
Misurare il valore attraverso il downtime evitato, la riduzione del lavoro di emergenza, i costi di manutenzione, la disponibilità dei ricambi, l’efficienza energetica, il rendimento, l’esposizione alla sicurezza e la vita dell’asset. I guasti evitati sono controfattuali, quindi occorre utilizzare baseline credibili, asset comparabili, assunzioni documentate e intervalli di sensibilità. Un progetto pilota che individua molte anomalie ma non modifica le decisioni di manutenzione non ha dimostrato valore commerciale.
La governance assegna responsabili per sensori, modelli, regole di allarme, librerie di guasti e processi di lavoro. Revisionare gli avvisi dopo ogni intervento, registrare se la diagnosi era corretta e reinserire i risultati confermati nelle regole e nei modelli. Operatori e manutentori hanno bisogno di un modo per mettere in discussione le raccomandazioni; la conoscenza locale è evidenza, non resistenza all’automazione.
Esempio pratico: proteggere un asset rotante critico
Per un compressore di produzione, il team mappa componenti e modalità di guasto, classifica le conseguenze di perdita di produzione e di sicurezza, e collega i tag dello storico, i sensori di vibrazione, i campioni di lubrificante, le ispezioni e gli ordini di lavoro a un’unica identità di asset. I dati di baseline devono coprire l’avvio, il carico stabile, la riduzione e le condizioni stagionali. Altrimenti il modello potrebbe segnalare transizioni operative normali come guasti o perdere degradazioni visibili solo a un carico specifico.
Uno strato analitico rileva variazioni nello spettro di vibrazione e nella temperatura dei cuscinetti, stima l’incertezza e mostra le evidenze accanto a eventi storici comparabili. Un avviso persistente genera una richiesta di ispezione anziché arrestare automaticamente l’impianto. Il manutentore registra i risultati, l’azione, il componente sostituito e la causa confermata. Questi risultati determinano se la soglia, il modello di guasto o l’installazione del sensore debbano essere modificati.
Valutare il tempo di anticipo dell’avviso, il tasso di rilevamento confermato, il carico di falsi allarmi, il downtime evitato, il lavoro di emergenza, la prontezza dei ricambi e il costo della manutenzione rispetto a una baseline documentata. Includere il costo dei sensori, dell’integrazione, dell’analisi e dei processi di lavoro modificati. La revisione della cybersicurezza isola il monitoraggio dal controllo, e la governance assegna responsabili per dati e modelli. L’obiettivo è una decisione di manutenzione più sicura ed economica, non la più ampia raccolta possibile di telemetria degli asset.
Checklist di implementazione pratica
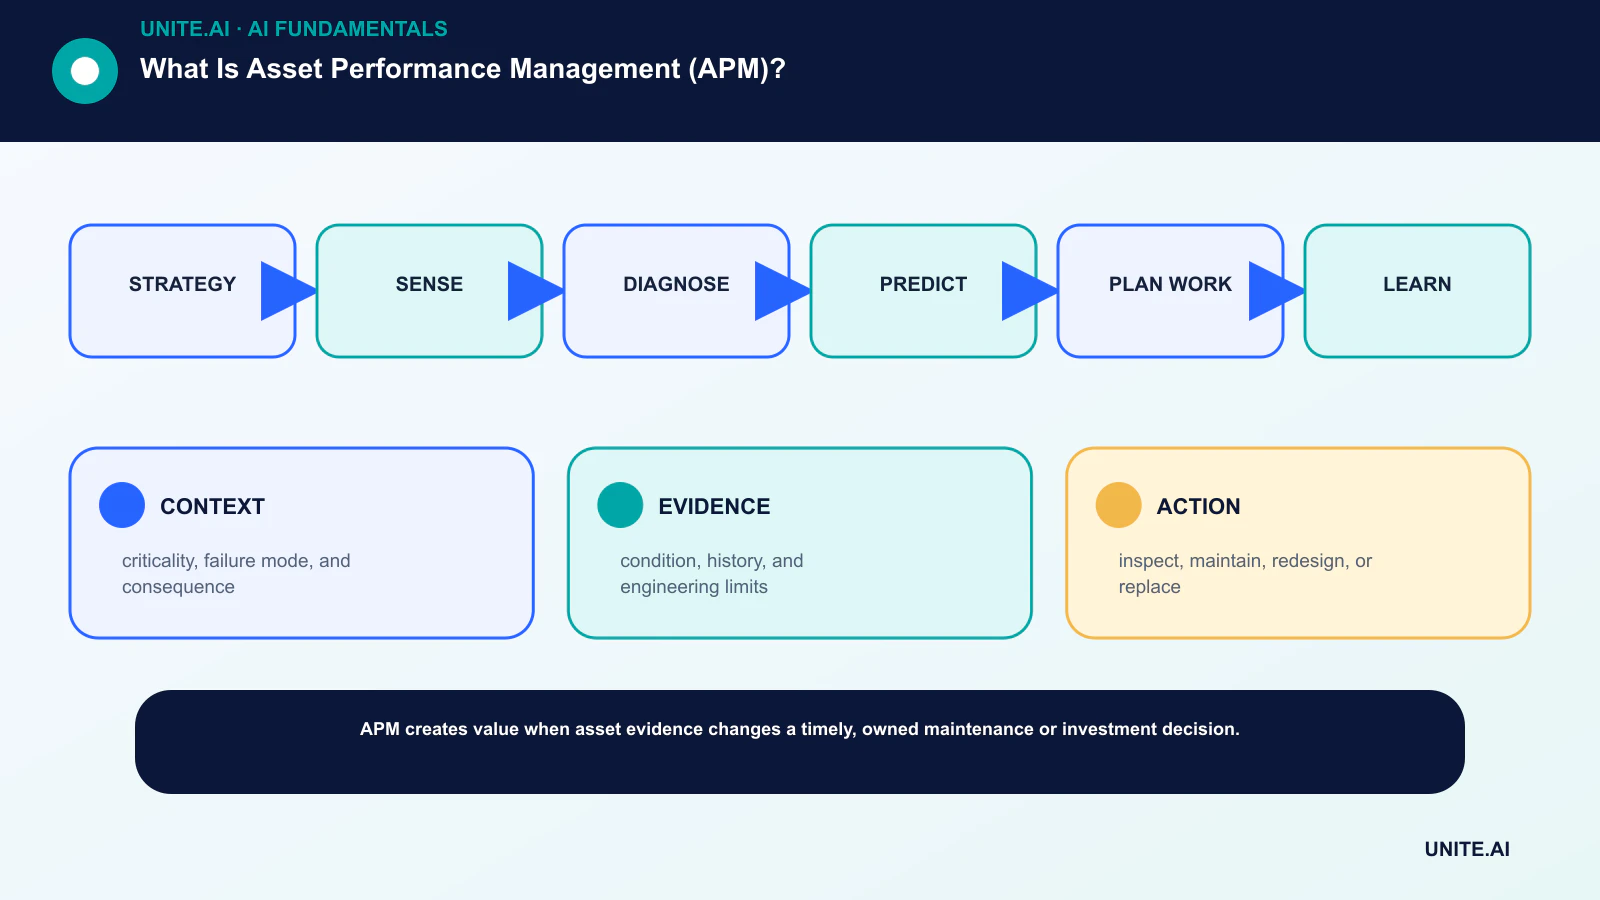
Trasformare il concetto in un flusso di lavoro delimitato e verificabile: strategia → rilevamento → diagnosi → previsione → pianificazione del lavoro → apprendimento. Assegnare un responsabile, documentare i dati e le dipendenze, stabilire una baseline semplice, definire criteri di accettazione e interruzione, testare guasti rappresentativi e definire monitoraggio, rollback e revisione prima di ampliare l’ambito. Registrare versioni e assunzioni affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, eseguire una revisione di prontezza documentata con le persone che costruiscono, operano, mettono in sicurezza e sono influenzate dal sistema. Testare casi normali, condizioni di confine, guasti di dipendenza e usi impropri; preservare le evidenze e i rischi non risolti. Definire chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Rivedere la decisione dopo l’arrivo dei dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- CONTESTO: criticità, modalità di guasto e conseguenza.
- EVIDENZA: condizione, storia e limiti ingegneristici.
- AZIONE: ispezionare, mantenere, riprogettare o sostituire.
Domande frequenti
In che modo l’APM differisce da un CMMS?
Un CMMS gestisce principalmente il lavoro di manutenzione, i programmi e i registri. L’APM aggiunge strategia degli asset, analisi di affidabilità e di condizione, priorità e decisioni di performance; i sistemi spesso si integrano.
La manutenzione predittiva è obbligatoria per l’APM?
No. Le strategie preventive, basate sulla condizione, run-to-failure, di riprogettazione e di sostituzione possono tutte essere appropriate. La previsione è uno strumento all’interno di una strategia di asset.
Riferimenti principali












