
Fondamenti di IA
Che cos’è l’Intelligenza Artificiale spiegabile?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Intelligenza Artificiale spiegabile (XAI) comprende metodi e pratiche che aiutano le persone a comprendere il comportamento o l’output di un sistema di IA. Una spiegazione può descrivere gli input influenti, mostrare un esempio simile, presentare una modifica controfattuale, riassumere una regola globale o comunicare quando il sistema non conosce.
Nessuna spiegazione è universalmente la migliore. Uno sviluppatore che esegue il debug di un modello, un revisore che verifica la conformità a una politica e una persona interessata da una decisione hanno bisogno di evidenze diverse. Le spiegazioni devono quindi essere valutate per accuratezza, significato e uso previsto — non solo per l’appeal visivo.
Punti chiave
- La trasparenza descrive le informazioni disponibili; l’interpretabilità riguarda il significato; la spiegazione comunica evidenze o ragioni.
- I metodi globali riassumono un modello, mentre i metodi locali si riferiscono a una singola previsione o a una piccola regione.
- Le spiegazioni post-hoc possono essere utili ma possono risultare instabili o non fedeli al modello sottostante.
- Una spiegazione non dimostra equità, causalità, robustezza o correttezza.
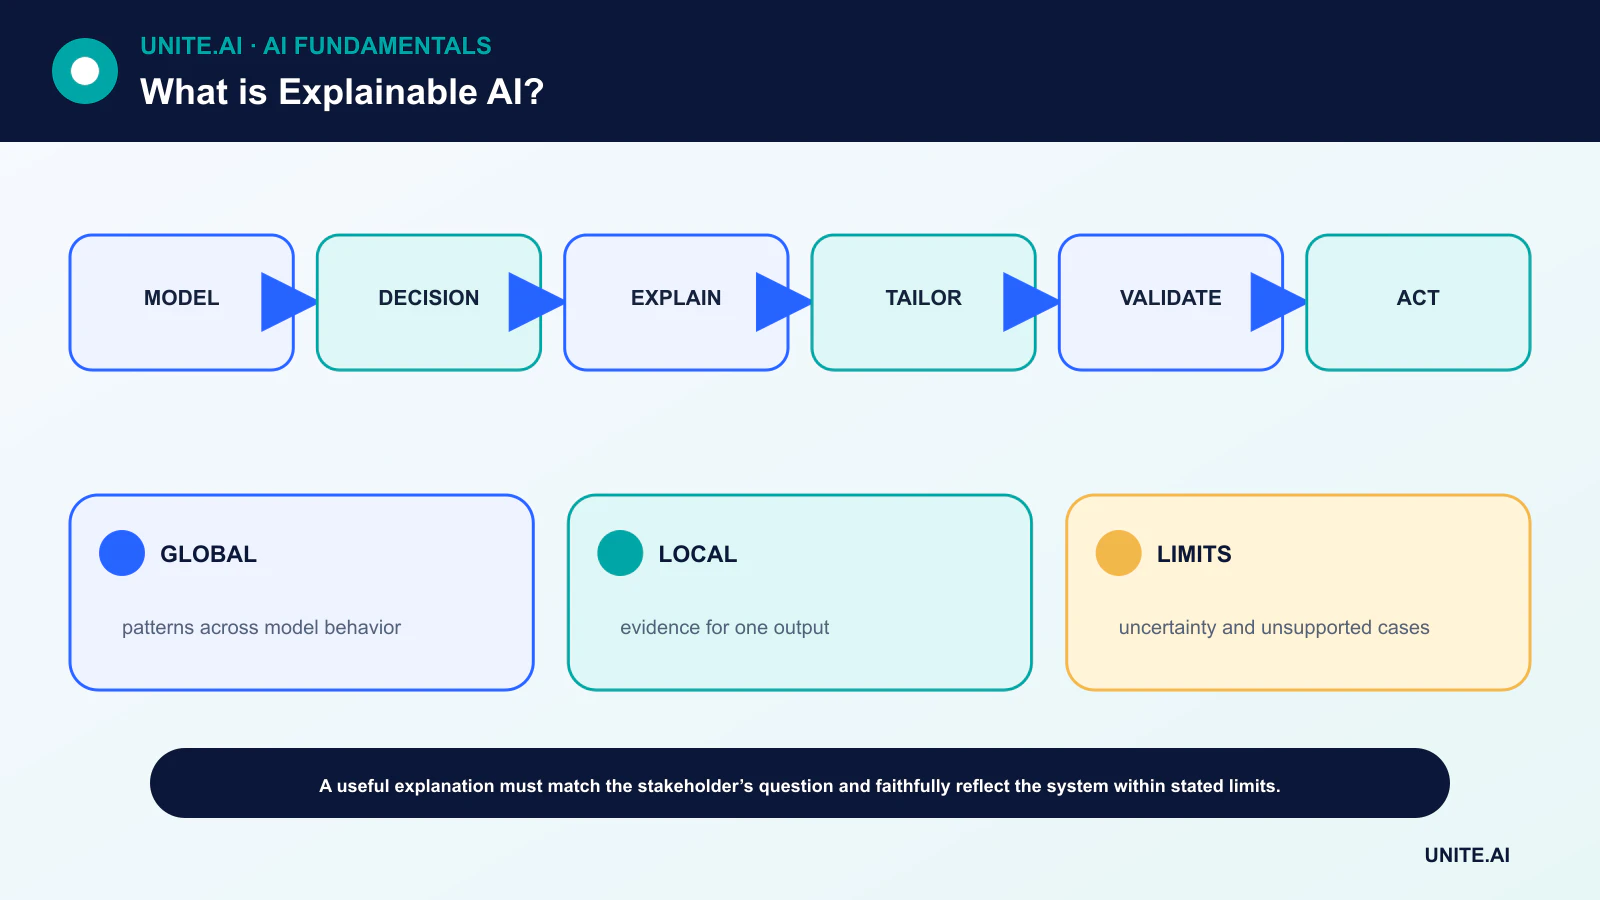
Quattro principi per spiegazioni utili
Il NIST propone che un sistema fornisca una spiegazione, la renda significativa per l’utente previsto, garantisca che rifletta accuratamente il processo del sistema e comunichi i limiti della sua conoscenza. Questi principi distinguono l’esistenza di una spiegazione dalla sua qualità.
Il significato è specifico del pubblico. Un codice di motivazione conciso può aiutare un richiedente, mentre uno sviluppatore di modelli può aver bisogno di distribuzioni, comportamento delle caratteristiche e gruppi di errori. Entrambi dovrebbero essere collegati allo stesso sistema documentato e al contesto decisionale.
Metodi intrinseci e post-hoc
Un modello lineare sparso o un albero decisionale decision tree limitato può essere direttamente interpretabile nel suo ambito valido. Un modello complesso può invece utilizzare attribuzione di caratteristiche post-hoc, un surrogato locale, esempi, mappe di salienza o controfattuali.
La semplicità intrinseca non è automaticamente fedele quando le caratteristiche sono mal definite o la pipeline è nascosta. La complessità post-hoc non è automaticamente fuorviante. Il metodo deve essere testato rispetto alla domanda a cui è destinato a rispondere.
Attribuzione delle caratteristiche e input correlati
I metodi di attribuzione assegnano parti di un output alle caratteristiche di input secondo assunzioni esplicite. LIME adatta un semplice surrogato locale intorno a una previsione; i metodi correlati a SHAP collegano attribuzioni additive ai concetti di valore di Shapley.
Le caratteristiche correlate possono condividere o scambiare attribuzioni, e un’alta attribuzione non è un effetto causale. Modificare una caratteristica in isolamento può creare una persona, un’immagine o una transazione impossibili. Le spiegazioni dovrebbero indicare le loro ipotesi di base, di campionamento e di dipendenza.
Controfattuali, esempi e comportamento globale
Un controfattuale chiede quale cambiamento fattibile altererebbe un risultato. I vincoli sono essenziali: una spiegazione attuabile non dovrebbe raccomandare cambiamenti immutabili, illegali o irrealistici. I metodi basati su esempi mostrano prototipi o casi di addestramento influenti, ma possono esporre dati privati.
L’analisi globale esamina le prestazioni, la dipendenza parziale, la monotonicità, le interazioni e il comportamento dei sottogruppi. Per ensemble come gradient boosting, combina riassunti con evidenze locali e test diretti dei vincoli attesi.
Convalidare la spiegazione e il sistema
Verificare la fedeltà, la stabilità sotto piccole perturbazioni, la coerenza tra input equivalenti, la comprensione da parte dell’utente e se la spiegazione supporta una decisione appropriata. I test avversari dovrebbero verificare se una spiegazione persuasiva può accompagnare un output errato o manipolato.
L’XAI rientra in una valutazione più ampia: qualità su dati di test, calibrazione, equità, privacy, sicurezza, monitoraggio e meccanismi di ricorso. Una spiegazione può supportare la responsabilità, ma non può sostituire una governance responsabile.
Obiettivi della spiegazione e famiglie di metodi
L’Intelligenza Artificiale spiegabile dovrebbe partire da una domanda e da un pubblico: perché è avvenuta una decisione, come si comporta generalmente il modello, quali evidenze lo hanno influenzato, cosa cambierebbe il risultato o se è stata seguita una politica. Le spiegazioni locali riguardano una singola previsione; le spiegazioni globali riassumono un comportamento più ampio. I modelli intrinsecamente interpretabili espongono coefficienti, regole o strutture, mentre i metodi post-hoc approssimano modelli complessi. Una spiegazione del comportamento del modello non è automaticamente una spiegazione causale del mondo o una giustificazione che una decisione sia equa.
I metodi di attribuzione delle caratteristiche includono gradienti, gradienti integrati, valori in stile SHAP, permutazione e modelli surrogati locali. Le spiegazioni basate su esempi recuperano casi influenti o simili; i controfattuali propongono cambiamenti associati a un output diverso; i metodi concettuali collegano le rappresentazioni interne a categorie umane. Ognuno ha assunzioni su baseline, indipendenza delle caratteristiche, linearità locale o accesso al modello. Variabili correlate, interazioni e pre‑elaborazione possono rendere le attribuzioni instabili o fuorvianti. Confronta i metodi e perturba gli input per verificare se una spiegazione prevede il comportamento.
Valutazione e fattori umani
Valutare la fedeltà — se la spiegazione corrisponde al modello — separatamente dalla plausibilità per una persona. Testare stabilità, sensibilità, completezza, parsimonia e utilità per un compito definito come il debug o il ricorso. Gli studi umani necessitano di partecipanti rappresentativi e dovrebbero misurare la qualità delle decisioni, il rilevamento degli errori, la dipendenza e il tempo, non se gli utenti affermano che un grafico sia chiaro. Una spiegazione persuasiva può aumentare la fiducia in un modello errato, quindi le interfacce devono mostrare incertezza, alternative e limitazioni.
I controfattuali dovrebbero essere fattibili, attuabili e non raccomandare la modifica di caratteristiche protette o immutabili. Le spiegazioni possono trapelare informazioni sul modello o personali e aiutare gli aggressori a ricostruire le decisioni. Applicare controlli di accesso e minimizzazione dell’output. Per usi regolamentati o ad alto impatto, conservare la provenienza dei dati, la versione del modello, la soglia e la logica decisionale reale; un grafico generico di importanza delle caratteristiche non può sostituire una motivazione legalmente significativa o una revisione umana.
Utilizzare le spiegazioni in modo responsabile
Scegliere il modello più semplice che soddisfi le esigenze di prestazioni e operative, ma non sacrificare la validità per un’interpretabilità superficiale. Combinare le spiegazioni con test su sottogruppi, controlli di robustezza, analisi causali dove pertinenti e monitoraggio dei risultati. Documentare il pubblico previsto e le inferenze non valide. Se una spiegazione cambia dopo una perturbazione innocua, indagare prima del rilascio. L’esplicabilità è una prova su un sistema mediante un metodo; è utile per il debug, la supervisione e la comunicazione, ma non certifica verità, equità, sicurezza o comprensione.
Esempio pratico: spiegare un modello di rischio creditizio
Un finanziatore definisce innanzitutto il pubblico e la motivazione richiesta: i richiedenti hanno bisogno di fattori decisionali accurati e di un percorso di correzione, mentre gli sviluppatori necessitano di diagnostica. Una baseline interpretabile calibrata viene confrontata con un modello potenziato. Attribuzioni locali, controfattuali e analisi globale degli errori sono testati per fedeltà, stabilità, comportamento delle caratteristiche correlate e utilità. Le spiegazioni non possono raccomandare la modifica di età, disabilità o altre caratteristiche immutabili, e non sono presentate come effetti causali.
Il registro decisionale di produzione conserva i dati di origine, la trasformazione delle caratteristiche, il modello, la soglia, la politica e l’azione umana. I richiedenti possono contestare dati errati e ricevere una revisione significativa. Il monitoraggio verifica la stabilità dei risultati e delle spiegazioni tra gruppi e aggiornamenti del modello. Se una spiegazione plausibile cambia sotto una perturbazione innocua delle caratteristiche o omette una regola politica decisiva, il rilascio viene interrotto. L’esplicabilità integra la validazione e i diritti procedurali; non scusa un obiettivo non valido, risultati discriminatori o la mancanza di autorità umana responsabile.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi rivedere le evidenze del mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
Le mappe di attenzione sono spiegazioni?
Possono essere segnali diagnostici, ma i pesi di attenzione da soli non garantiscono di rappresentare fedelmente le ragioni dell’output di un modello.
L’Intelligenza Artificiale spiegabile richiede un modello semplice?
Non sempre. I modelli complessi possono essere analizzati con metodi post-hoc, ma tali spiegazioni necessitano di una validazione indipendente e di limiti chiaramente dichiarati.
Riferimenti principali












