Fondamenti di IA
Apprendimento supervisionato vs non supervisionato

 Aggiungi Unite.AI alle tue fonti preferite su Google
Apprendimento supervisionato apprende da esempi associati a risposte target. Apprendimento non supervisionato cerca strutture nei dati senza etichette target. La differenza non riguarda quale approccio sia più intelligente o accurato; riguarda il tipo di segnale di apprendimento disponibile e la domanda a cui il sistema è progettato per rispondere.
Questi sono due paradigmi principali nell<a href=”https://www.unite.ai/what-is-machine-learning/”>apprendimento automatico</a>, ma i sistemi moderni utilizzano anche l’apprendimento semi-supervisionato, auto-supervisionato e per rinforzo.
Punti chiave
- L’apprendimento supervisionato prevede un target noto; l’apprendimento non supervisionato scopre pattern o rappresentazioni.
- La classificazione e la regressione sono compiti supervisionati; il clustering, la stima della densità e molti metodi di riduzione della dimensionalità sono non supervisionati.
- Gli output non supervisionati non corrispondono automaticamente a classi del mondo reale e possono essere più difficili da valutare.
- Il costo computazionale e l’accuratezza dipendono dall’algoritmo, dai dati, dal compito e dalla valutazione, non solo dal paradigma.
Come funziona l’apprendimento supervisionato
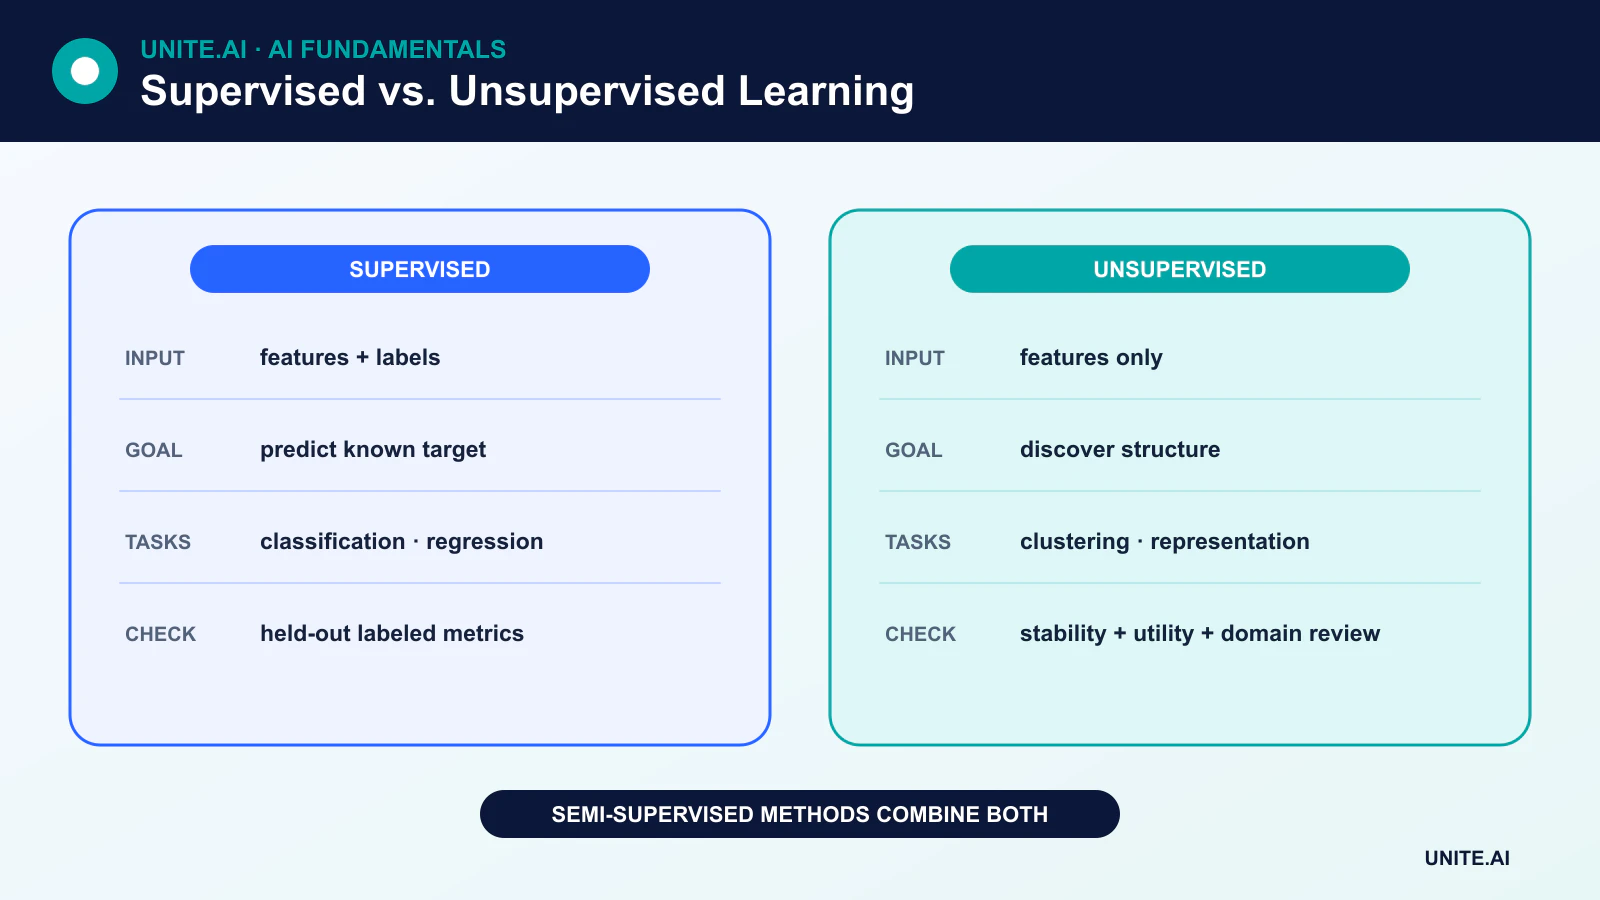
Un dataset supervisionato contiene le caratteristiche X e un target y. L’addestramento regola un modello in modo che le sue previsioni si avvicinino ai target. La valutazione utilizza esempi etichettati di riserva per stimare quanto bene il modello generalizzi.
Classificazione
La classificazione prevede una categoria: spam o non spam, un argomento di documento tra diversi, o uno o più oggetti in un’immagine. Le metriche rilevanti includono precisione, richiamo, F1, calibrazione e misure sensibili al costo. L’accuratezza può essere fuorviante quando una classe è rara; una matrice di confusione rivela quali classi vengono confuse.
Regressione
La regressione prevede un valore continuo, come la domanda, la durata o la temperatura. La regressione lineare può utilizzare una o più caratteristiche; non è limitata a tracciare una relazione tra due variabili. Le metriche di regressione includono l’errore medio assoluto, l’errore quadratico medio radice e i costi specifici del compito.
Algoritmi supervisionati comuni
I metodi supervisionati includono modelli lineari e logistici, alberi decisionali, foreste casuali, gradient boosting, macchine a vettori di supporto, K-nearest neighbors e reti neurali.
La regressione logistica produce un punteggio o una probabilità che può essere convertita in una classe usando una soglia scelta. Una foglia di un albero decisionale contiene una previsione basata su una regione dello spazio delle caratteristiche, non necessariamente su una singola osservazione di addestramento. KNN prevede a partire da esempi di addestramento etichettati vicini e richiede comunque una solida progettazione di train/validation/test.
Come funziona l’apprendimento non supervisionato
L’apprendimento non supervisionato riceve le caratteristiche senza una colonna target. Il suo obiettivo è definito indirettamente — ad esempio, minimizzare la distanza all’interno dei cluster, ricostruire un input, stimare la densità dei dati o mantenere quanta più varianza possibile in meno dimensioni.
Clustering
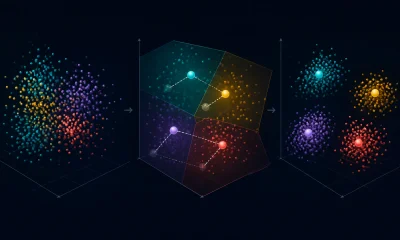
K-means assegna i punti a un numero scelto di cluster e aggiorna i centri dei cluster per ridurre la distanza quadratica intra-cluster. L’algoritmo scopre raggruppamenti geometrici sotto una particolare distanza e rappresentazione delle caratteristiche. Questi gruppi non corrispondono automaticamente a tipi di cliente significativi, diagnosi o altre etichette di dominio.
Riduzione della dimensionalità
La riduzione della dimensionalità rappresenta i dati usando meno variabili. L’analisi delle componenti principali trova direzioni ortogonali che mantengono quanta più varianza possibile sotto una proiezione lineare. Altri metodi preservano diverse nozioni di struttura e possono produrre visualizzazioni molto diverse.
Rilevamento di anomalie e stima della densità
I metodi non supervisionati possono stimare dove i dati sono densi e segnalare osservazioni insolite. Un punteggio di anomalia non prova frode, guasto o comportamento maligno; identifica una deviazione sotto la rappresentazione e il modello scelti.
Come viene valutato l’apprendimento non supervisionato
Non esiste una nozione universale di “accuratezza” non supervisionata. Un professionista può utilizzare metriche interne come il silhouette score, confrontare la stabilità tra campioni, testare l’utilità in un compito a valle, o chiedere agli esperti di dominio se la struttura scoperta è significativa. Se esistono etichette di verità a terra per la valutazione, è possibile utilizzare metriche di clustering esterne senza trasformare il processo di addestramento in apprendimento supervisionato.
Oltre il confronto binario
Apprendimento semi-supervisionato
L’apprendimento semi-supervisionato combina un piccolo insieme etichettato con un insieme più grande non etichettato. Pseudo-etichettatura, regolarizzazione della coerenza e metodi basati su grafi sono esempi. I dati non etichettati devono comunque somigliare abbastanza alla distribuzione target per essere utili.
Apprendimento auto-supervisionato
L’apprendimento auto-supervisionato ricava i target dall’input stesso, ad esempio prevedendo token mascherati o abbinando visualizzazioni trasformate. È una base per i modelli moderni di linguaggio, visione e multimodali, inclusi i transformer.
Apprendimento per rinforzo
L’apprendimento per rinforzo ottimizza le decisioni tramite ricompense generate dall’interazione. Si differenzia sia dalla previsione etichettata sia dalla scoperta di pattern statici.
Scegliere l’approccio giusto
Inizia con la decisione o l’insight che il sistema deve produrre. Se esistono target affidabili e l’obiettivo è la previsione, l’apprendimento supervisionato è naturale. Se l’obiettivo è l’esplorazione, la rappresentazione o il raggruppamento, un metodo non supervisionato può essere adatto. Quando le etichette sono scarse, il preaddestramento auto-supervisionato o semi-supervisionato seguito da una valutazione supervisionata può essere più efficace.
In ogni caso, perdite di dati, campionamento di parte, proxy deboli e spostamenti di distribuzione possono dominare la scelta dell’algoritmo. Un modello tecnicamente corretto addestrato sul obiettivo sbagliato può comunque fallire.
Segnali di apprendimento, obiettivi e metodi rappresentativi
L’apprendimento supervisionato utilizza esempi associati a etichette o valori target e ottimizza l’errore predittivo. Classificazione, regressione, ranking e predizione strutturata differiscono per output e loss. L’apprendimento non supervisionato cerca strutture senza etichette target attraverso clustering, stima della densità, riduzione della dimensionalità, apprendimento di rappresentazioni o modellazione generativa. L’apprendimento auto-supervisionato crea target di previsione dai dati stessi, mentre l’apprendimento semi-supervisionato combina un piccolo insieme etichettato con dati non etichettati più ampi. Queste categorie descrivono il segnale di apprendimento; la stessa architettura neurale può essere addestrata sotto diversi paradigmi.
Le etichette rendono esplicito un obiettivo ma introducono costi di annotazione, rumore, assunzioni di policy e ritardi temporali. I dati non etichettati sono più facili da raccogliere ma non indicano a un algoritmo quale struttura scoperta sia utile. Un cluster può riflettere illuminazione, lunghezza del documento o fonte di acquisizione invece di una categoria significativa. Definisci la valutazione in modo indipendente: i modelli supervisionati usano risultati etichettati di riserva, mentre i modelli non supervisionati richiedono stabilità, ricostruzione, verosimiglianza, recupero, utilità a valle o validazione da parte di esperti. La sola separazione visiva non è prova di una struttura valida.
Scegliere un paradigma e prevenire errori comuni
Utilizza l’apprendimento supervisionato quando esiste un target stabile e etichette rappresentative. Utilizza l’esplorazione non supervisionata per riassumere, rilevare novità, comprimere o generare ipotesi, ma tratta gli output come provvisori. Il preaddestramento auto-supervisionato è prezioso quando i dati grezzi sono abbondanti e i compiti a valle condividono le rappresentazioni. I metodi semi-supervisionati aiutano solo quando le assunzioni sui dati non etichettati e sulla struttura delle classi sono valide. Confronta con baseline semplici e considera il costo totale di raccolta, etichettatura, revisione, computazione ed errori invece di presumere che i dati non etichettati siano automaticamente poco costosi.
Previeni le perdite separando entità correlate prima di derivare etichette, aumenti o pseudo-etichettature. Monitora l’equilibrio delle classi, l’accordo di annotazione, la stabilità dei cluster, il collasso e il drift. Le pseudo-etichette possono rafforzare errori iniziali; il clustering può codificare attributi sensibili; una rappresentazione preaddestrata può trasferire bias di origine. La revisione umana dovrebbe concentrarsi sui casi limite e sulle conseguenze. In produzione, documenta come è stato creato il segnale di apprendimento e quando diventa obsoleto. Il paradigma determina dove la supervisione entra nel sistema, non se le scelte e i valori umani siano presenti.
Esempio pratico: scoperta e etichettatura dei temi di supporto
Un’azienda utilizza inizialmente embedding non supervisionati e clustering per esplorare i temi nei messaggi di supporto de-identificati. Gli analisti esaminano esempi rappresentativi e di confine e scoprono che alcuni cluster riflettono la lunghezza del messaggio e il canale piuttosto che i problemi. Sviluppano una tassonomia supervisionata con una classe sconosciuta, linee guida per l’annotazione e accordo misurato. Un classificatore viene poi valutato su periodi successivi, lingue e prodotti rispetto a baseline basate su parole chiave e nearest-neighbor.
I messaggi nuovi non etichettati supportano la scoperta di drift ma non riaddestrano automaticamente il classificatore. I revisori etichettano casi incerti ed emergenti selezionati tramite apprendimento attivo, con controlli di qualità e un set di valutazione sigillato. Il monitoraggio traccia la prevalenza dei temi, la fiducia, il disaccordo e i risultati di instradamento. Quando viene lanciato un nuovo prodotto, la tassonomia e la capacità dei team a valle vengono aggiornate insieme. Il flusso di lavoro utilizza metodi non supervisionati per la generazione di ipotesi e prove supervisionate per l’instradamento operativo.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizza un rollout a tappe, mantieni un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allerta e un responsabile di risposta, quindi esamina le prove reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che cambiano le fonti di dati, gli utenti, i modelli, i fornitori, le policy, l’hardware o gli obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disabilitato o sostituito.
Riferimenti principali